
ACE-Step:一首歌生成之后,继续改歌词和风格
为什么值得关注
把短句改词、按时段重绘与参考音频生成放进同一创作流程,适合已有满意片段、想控制下一轮修改范围的人。
适合谁:愿意逐版听辨中文歌词、衔接和风格的音乐草稿创作者
这次有哪些亮点
- Edit 区分仅改歌词与 remix 模式
- Repainting 可指定时段及来源音频
- Audio2Audio 提供参考音频和参考强度入口
使用前需要知道
本文对应v1-3.5B,不是v1.5更新。改词宜小片段,重绘/延长可有衔接问题;中文说唱图另载LoRA,不代表基础模型效果。
一段 AI 歌曲有了喜欢的旋律,却想改掉一句歌词,整首重抽会连满意的部分一起换掉。ACE-Step v1-3.5B 值得看的地方,是把生成后的继续修改放进同一套界面:可以换一小段歌词、重做指定时段,或拿已有音频尝试新的风格。它给创作草稿增加了几种修改入口。
中文歌词和风格描述分开填写
官方 RapMachine 演示把中文歌词放在 Lyrics,把电子、嘻哈、节奏与人声描述放在 Tags;右侧显示生成音频和参数。两块输入各管一件事:歌词说明要唱什么,风格描述说明希望怎样呈现。主歌、副歌等结构标签,则帮助区分歌曲段落。
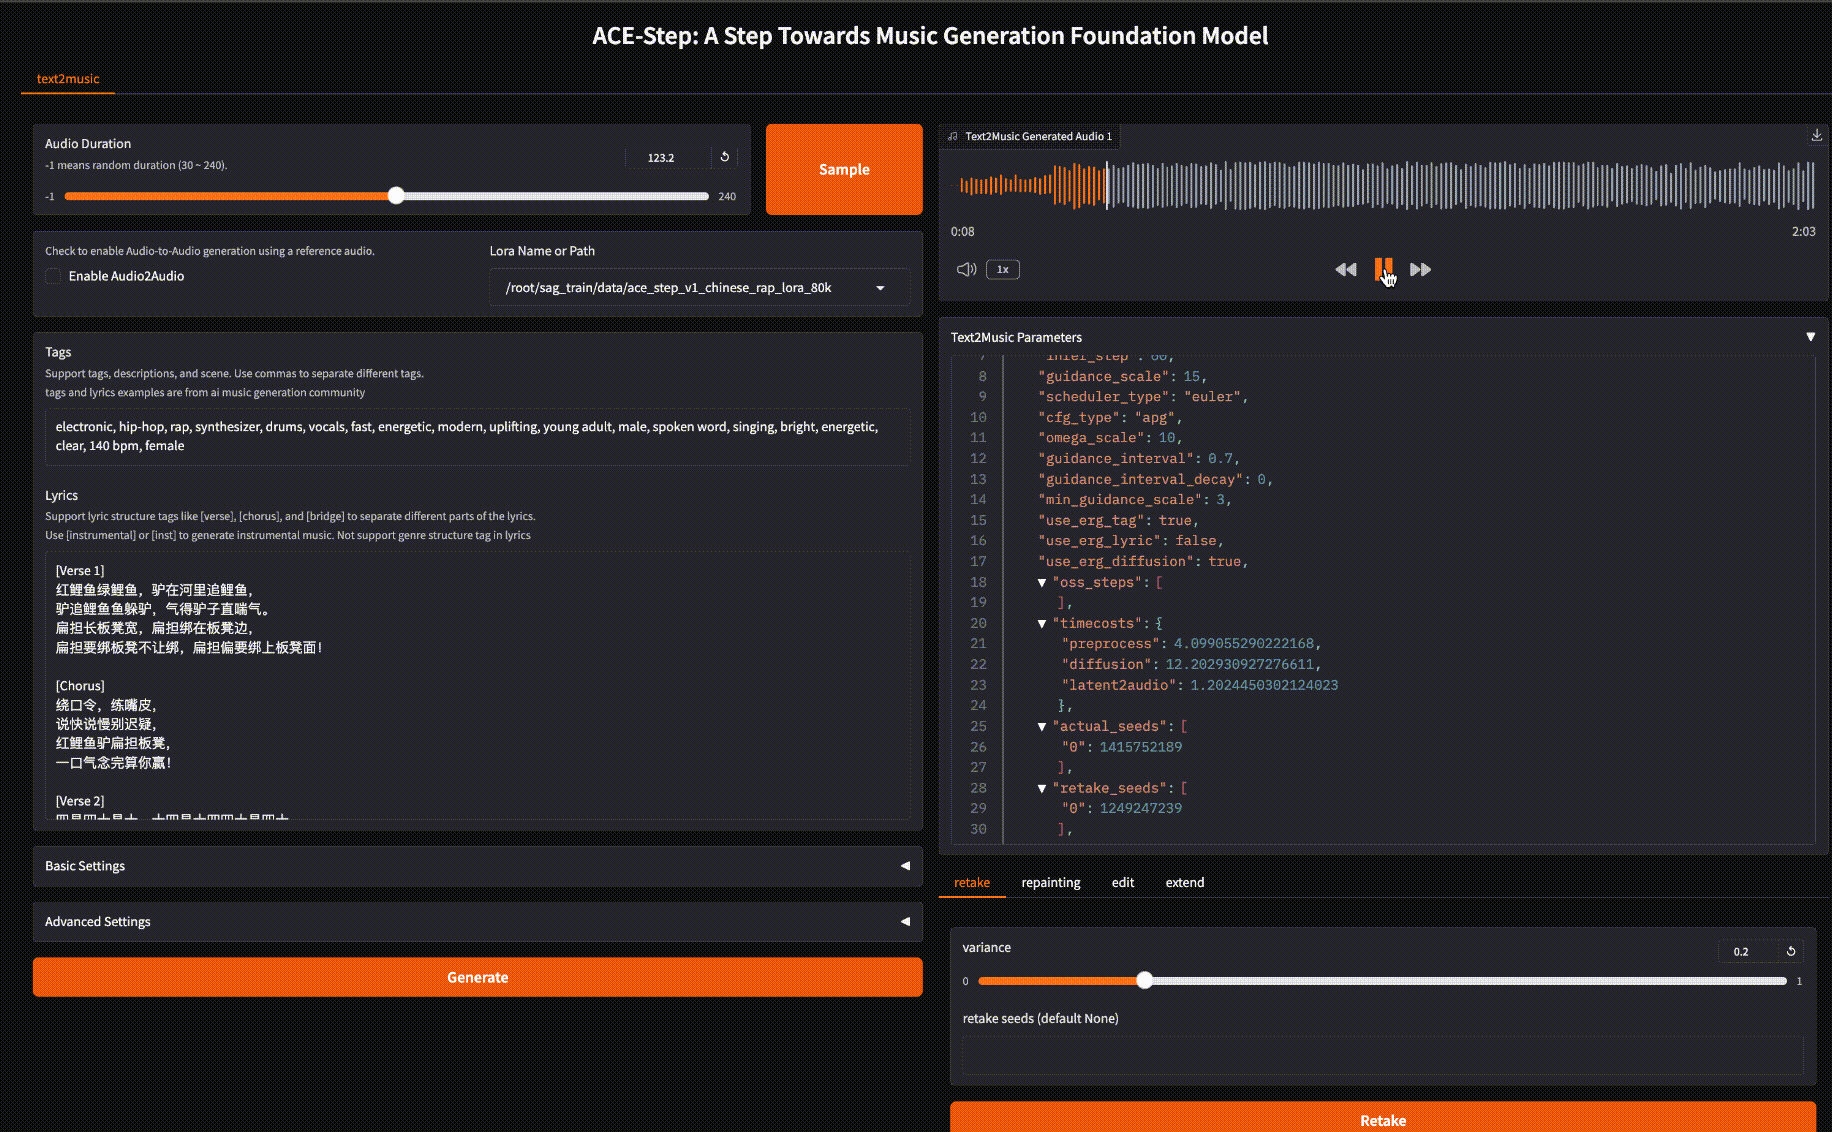
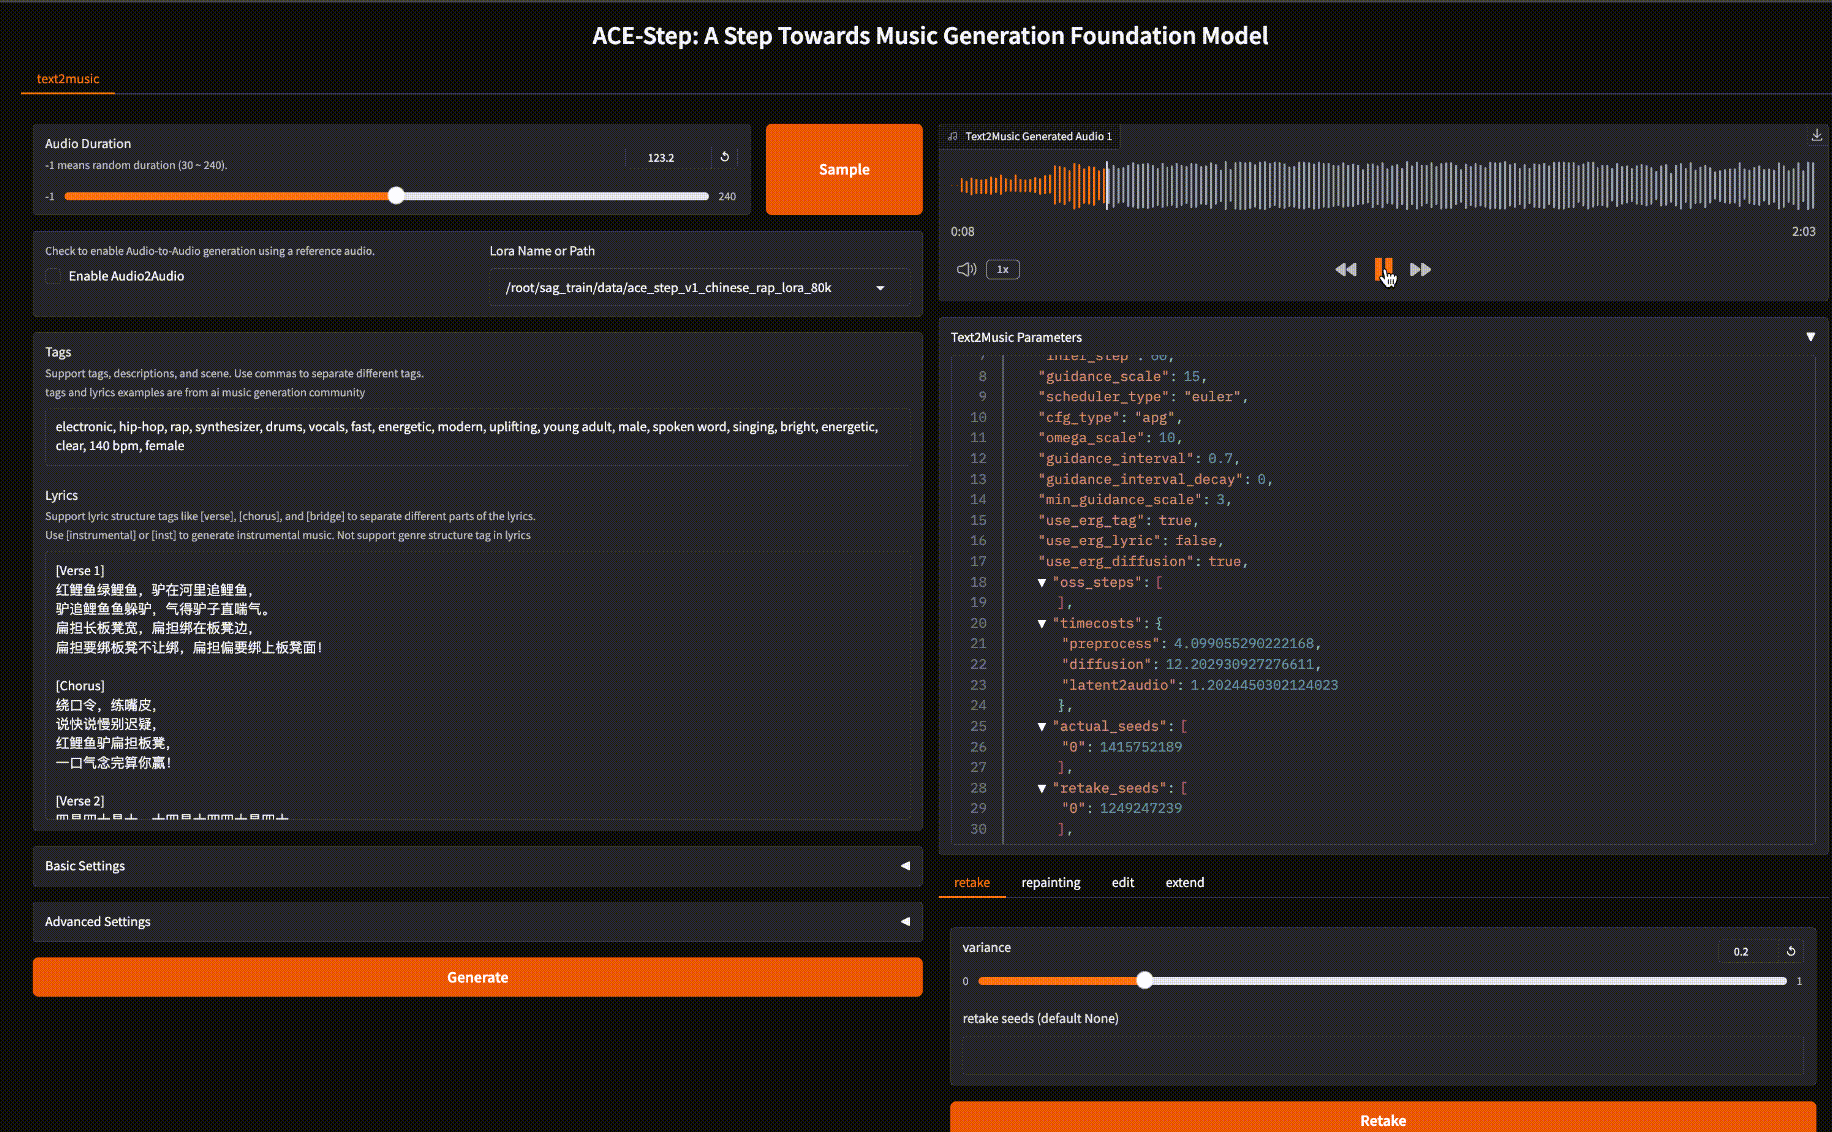
看左侧的中文绕口令歌词和上方 LoRA 路径:这个官方示例加载了中文说唱 LoRA,不能把它的展示全部归给裸的 v1 基础模型。右侧波形说明界面已经载入音频,但静态图不能证明咬字、押韵和音质。本篇判读官方界面与说明,没有在本机出歌或试听评级。(打开原图)
同一段草稿,有不同的修改范围
假设你已经得到一段歌,只有副歌里的短句需要替换,这是一个理解 Edit 的教学情境。官方界面提供 only_lyrics 模式,目标是在保留旋律的情况下改歌词;remix 则允许旋律发生变化。选哪一种,取决于你满意的是现有曲调,还是只想保留部分原作特征。
这里必须把“修改入口”与“修改保证”分开。官方 Lyric Editing 说明写得很具体:一次只适合改较小的歌词片段,改动太大可能失真,可以分多次处理。因此我会优先把它用于局部草稿修订,而不会承诺整首换词后仍保持原来的所有演唱细节。
如果问题出在某一段编排,而非某几个字,Repainting 可以指定起止时间,选择生成结果、上次重绘或上传音频作为来源。只是想在大致方向上再选一个版本,则用 Retake 调整变化程度。这几个入口的价值,在于先说明自己愿意改动多大范围,再生成候选,减少每次都从整首重新开始的盲目性。
已有音频也可以作为起点
官方 Audio2Audio 动画展示了另一条路线:启用选项后,左侧出现参考音频与 Refer audio strength 滑块,下面仍能填写 Tags 和 Lyrics。画面里的标签是 trance,歌词栏用 [inst] 表示器乐。
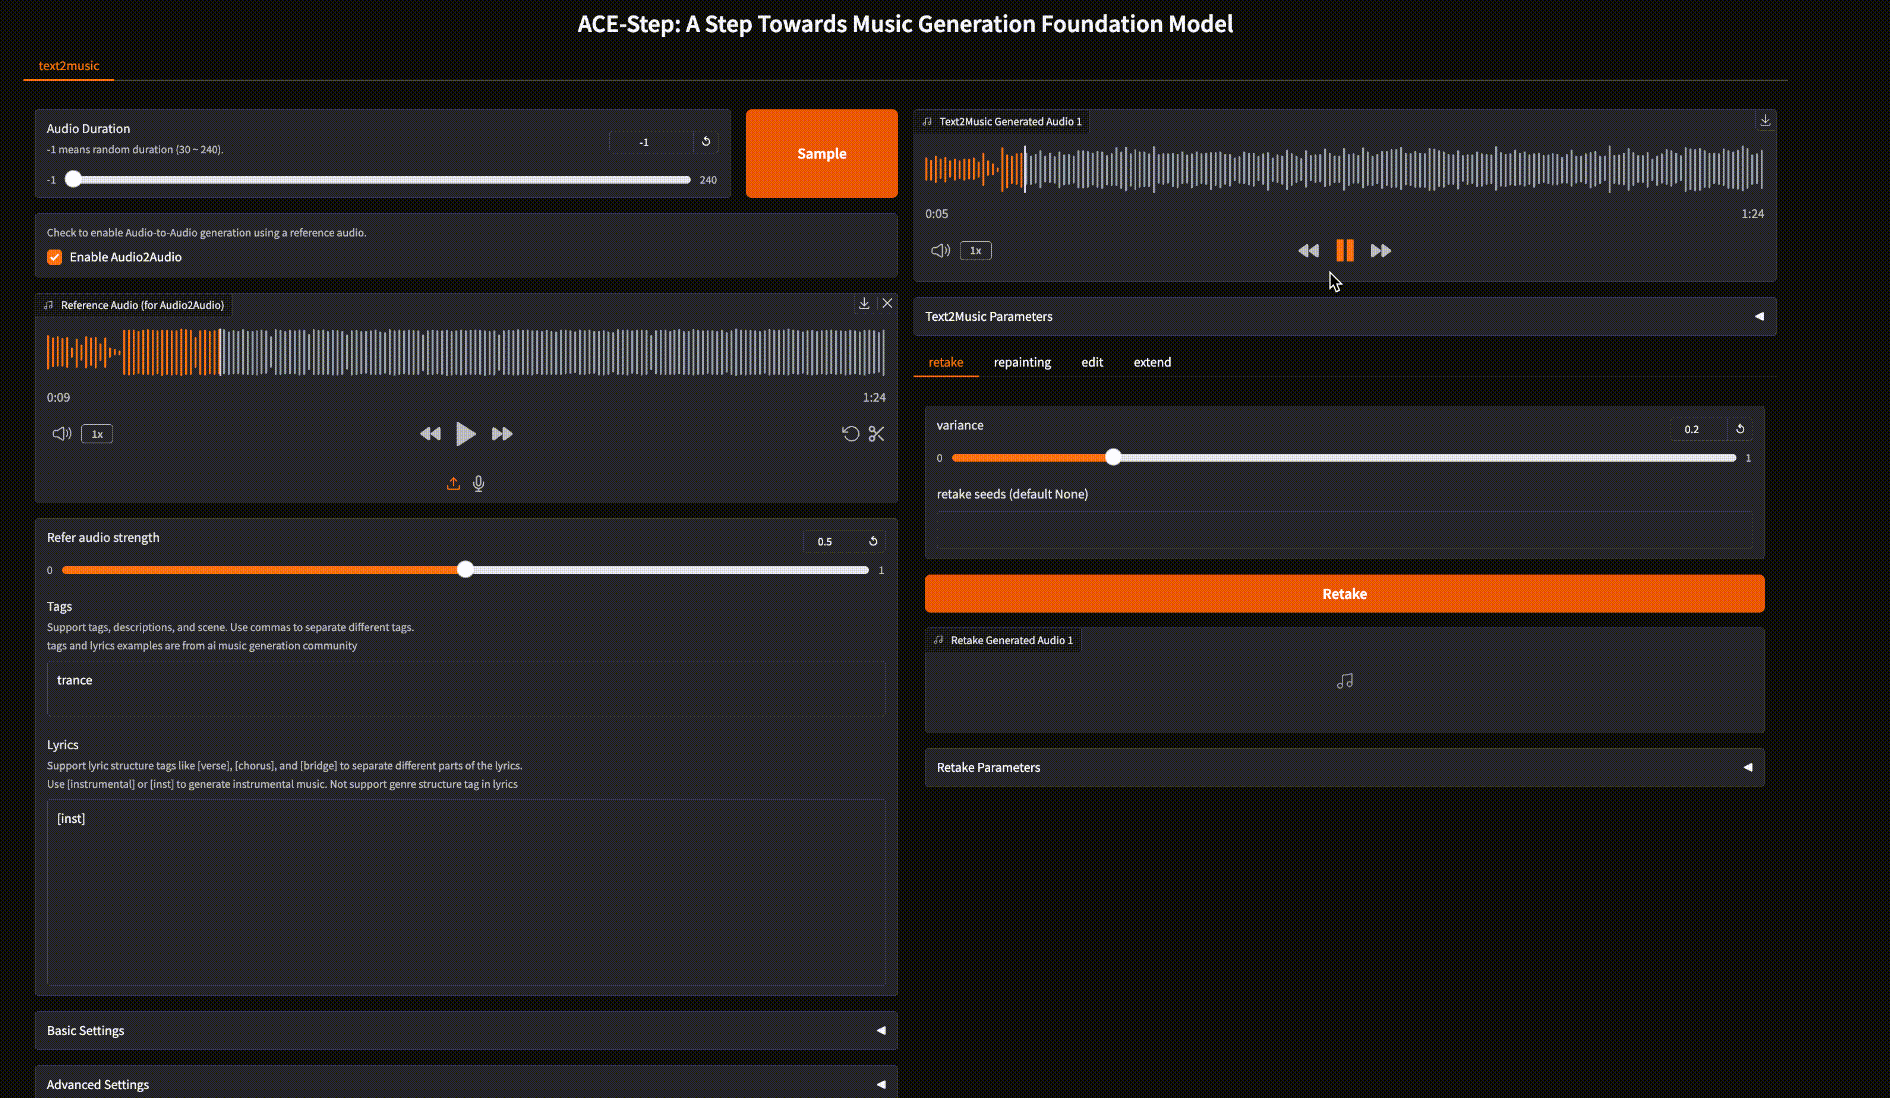
这张图应看“参考音频—强度—描述—生成音频”的位置关系,不能把它说成前面中文歌词已经完成改词的前后对比。它说明已有声音可以进入生成流程;实际保留了多少旋律、改变了多少风格,仍要对照输入输出听。官方模型卡也承认,结果对随机种子和时长敏感,重绘与延长可能出现不自然衔接,人声细腻度仍有限。(打开原图)
本篇说的是 v1,不是 v1.5 更新公告
这套仓库与示例对应 ACE-Step v1-3.5B。当前 README 顶部另外链接 ACE-Step v1.5,并在新闻中记录了 2026 年 1 月的发布信息;页面较下方还保留旧路线图。不能用旧路线图否定 v1.5 已发布,也不能把这里的 v1 演示包装成今天新增的能力。
要试本篇这条路线,可从 v1-3.5B 官方模型页 或仓库链接的 ModelScope 入口取得模型,项目主页有生成与编辑样例。README 建议 Python 3.10 及以上,提供本地 Gradio 界面;其内存优化说明涉及卸载到 CPU 等选项,不能从“有优化”推导任意电脑都能流畅运行。代码与该模型卡均标注 Apache 2.0,输入音频和歌词仍需有相应使用权限。
如果你愿意保留原稿、分小范围修改,并逐版听衔接与咬字,ACE-Step 提供了值得尝试的创作空间。追求一次生成即可正式发行,或要求局部之外的声音绝对不变,则超出了这份 v1 材料能支持的承诺。
参考:
以上为编辑整理,功能、许可与使用条件以官方说明为准。