
Boltz-2:分子摆得像,还要看它结合得多强
为什么值得关注
将复合物结构与两类亲和力输出接在同一流程中,为研究者组织筛选和活性分子优化提供不同依据。
适合谁:希望理解分子筛选的 AI 读者、结构生物学与计算化学学习者
这次有哪些亮点
- 联合预测分子复合物结构与结合亲和力
- 结合概率和活性分子间的强弱比较分别建模
- 可用实验接触信息与结构模板约束预测
使用前需要知道
当前亲和力模块限于小分子对蛋白质;预测与计算模拟不替代湿实验。完整 Boltz-2 训练及更新评估代码仍被仓库列为待提供。
给定一个蛋白质和几种候选小分子,研究者想知道的不只是它们能摆出什么三维姿态,还包括哪些更可能结合、已经能结合的分子改动后会怎样。Boltz-2 把复合物结构与结合亲和力放进同一套预测流程。这是它值得单独认识的地方:一张看起来合理的结构图,终于有了另一类输出与它配合,帮助组织下一轮实验候选。
它是面向生物分子相互作用的模型,适合结构生物学、计算化学学习者和需要理解分子筛选流程的 AI 读者。这里解析官方材料与文档,不把模型建议写成已经发现的新药。官方介绍说明了它从结构建模延伸到亲和力预测的目标。
一份输入,读出两种不同的问题
可以用一个教学情境理解这条流程:保持目标蛋白质不变,为几种候选配体分别准备输入。蛋白质用氨基酸序列描述,小分子可用 SMILES,也可用标准化学组分代码;再指定需要对哪条配体链计算亲和力。模型随后输出预测结构、结构置信信息,以及单独的亲和力文件。这里没有实际运行这组候选。
最容易读错的是亲和力文件里的两项数值。affinity_probability_binary 表达模型认为该配体属于结合分子的概率,官方把它放在从干扰候选里寻找结合者的语境中。affinity_pred_value 则用于比较不同活性分子的结合强弱,特别是小幅化学改动后的变化。两者使用的训练数据和监督方式不同,不能把它们当成同一分数的两种写法。
后一项采用以微摩尔为单位的 IC50 再取常用对数的口径,数值越低表示预测结合越强。按文档给出的换算例,1 微摩尔对应 0,1 纳摩尔对应 −3。这是读数解释,并非本文得到的实验值。若把“越大越好”的直觉套上去,候选排序就会反过来。预测文档还明确要求,强弱比较应放在活性分子之间,不能据此给所有无活性候选排出可信次序。
为什么值得看,为什么仍要看测试条件
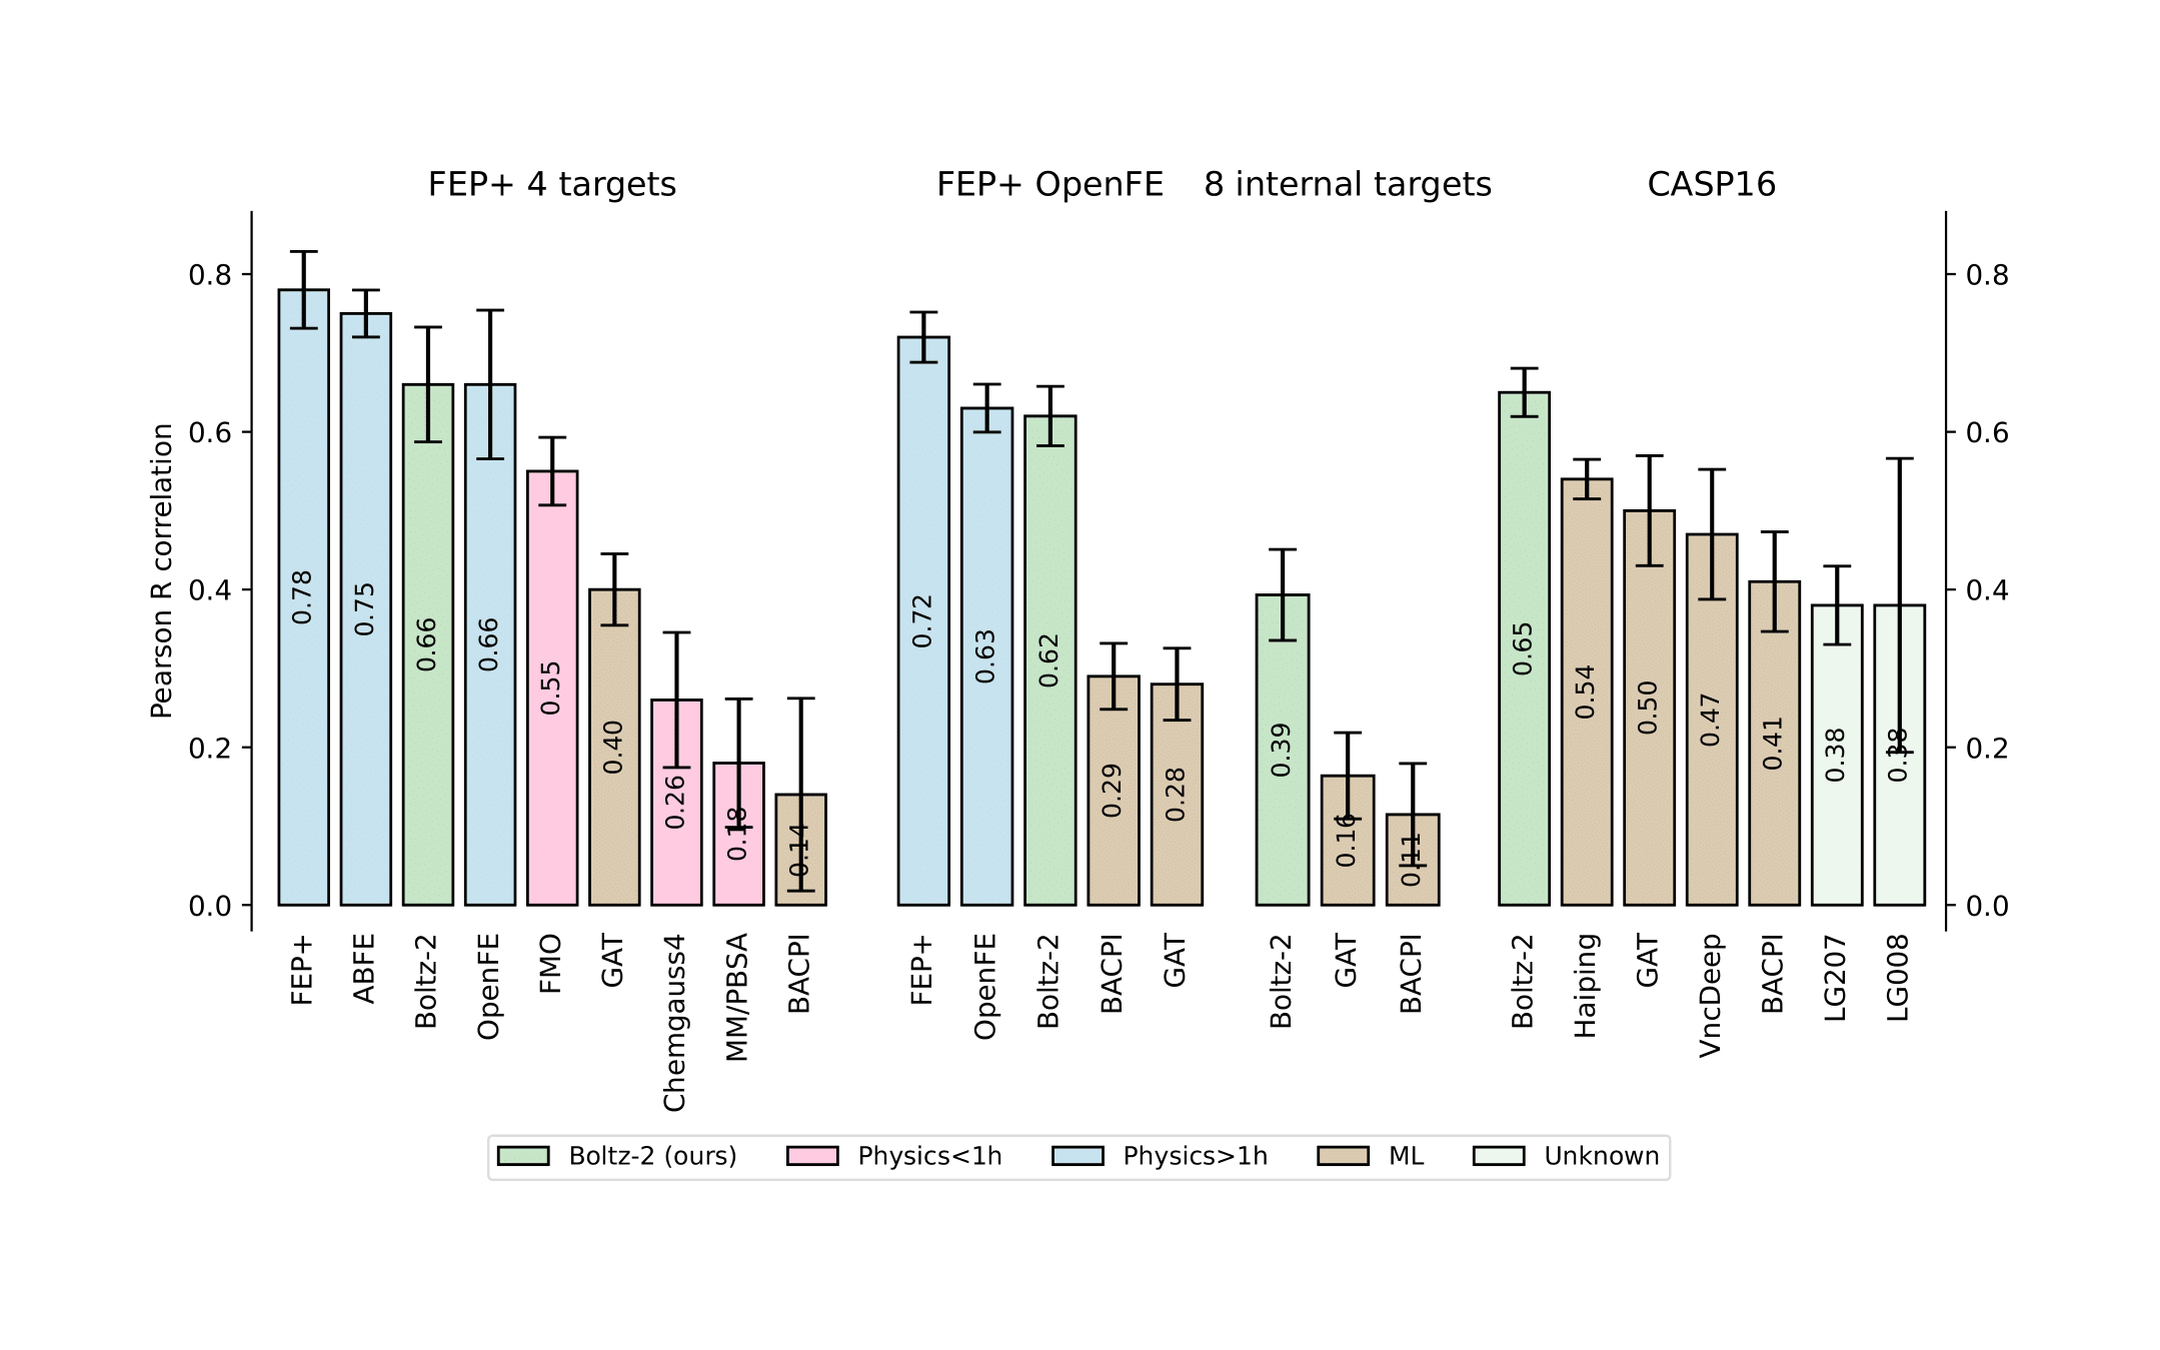
官方亲和力评估图把不同测试集放在同一张图里。中间标为 FEP+ OpenFE 的一组中,Boltz-2 的 Pearson 相关系数为 0.62,OpenFE 为 0.63;左边四个靶标子集和右边 CASP16 又是各自的比较。图里的纵轴衡量预测与参考值的相关程度,不能读成“百分之多少候选能在实验里成功”。
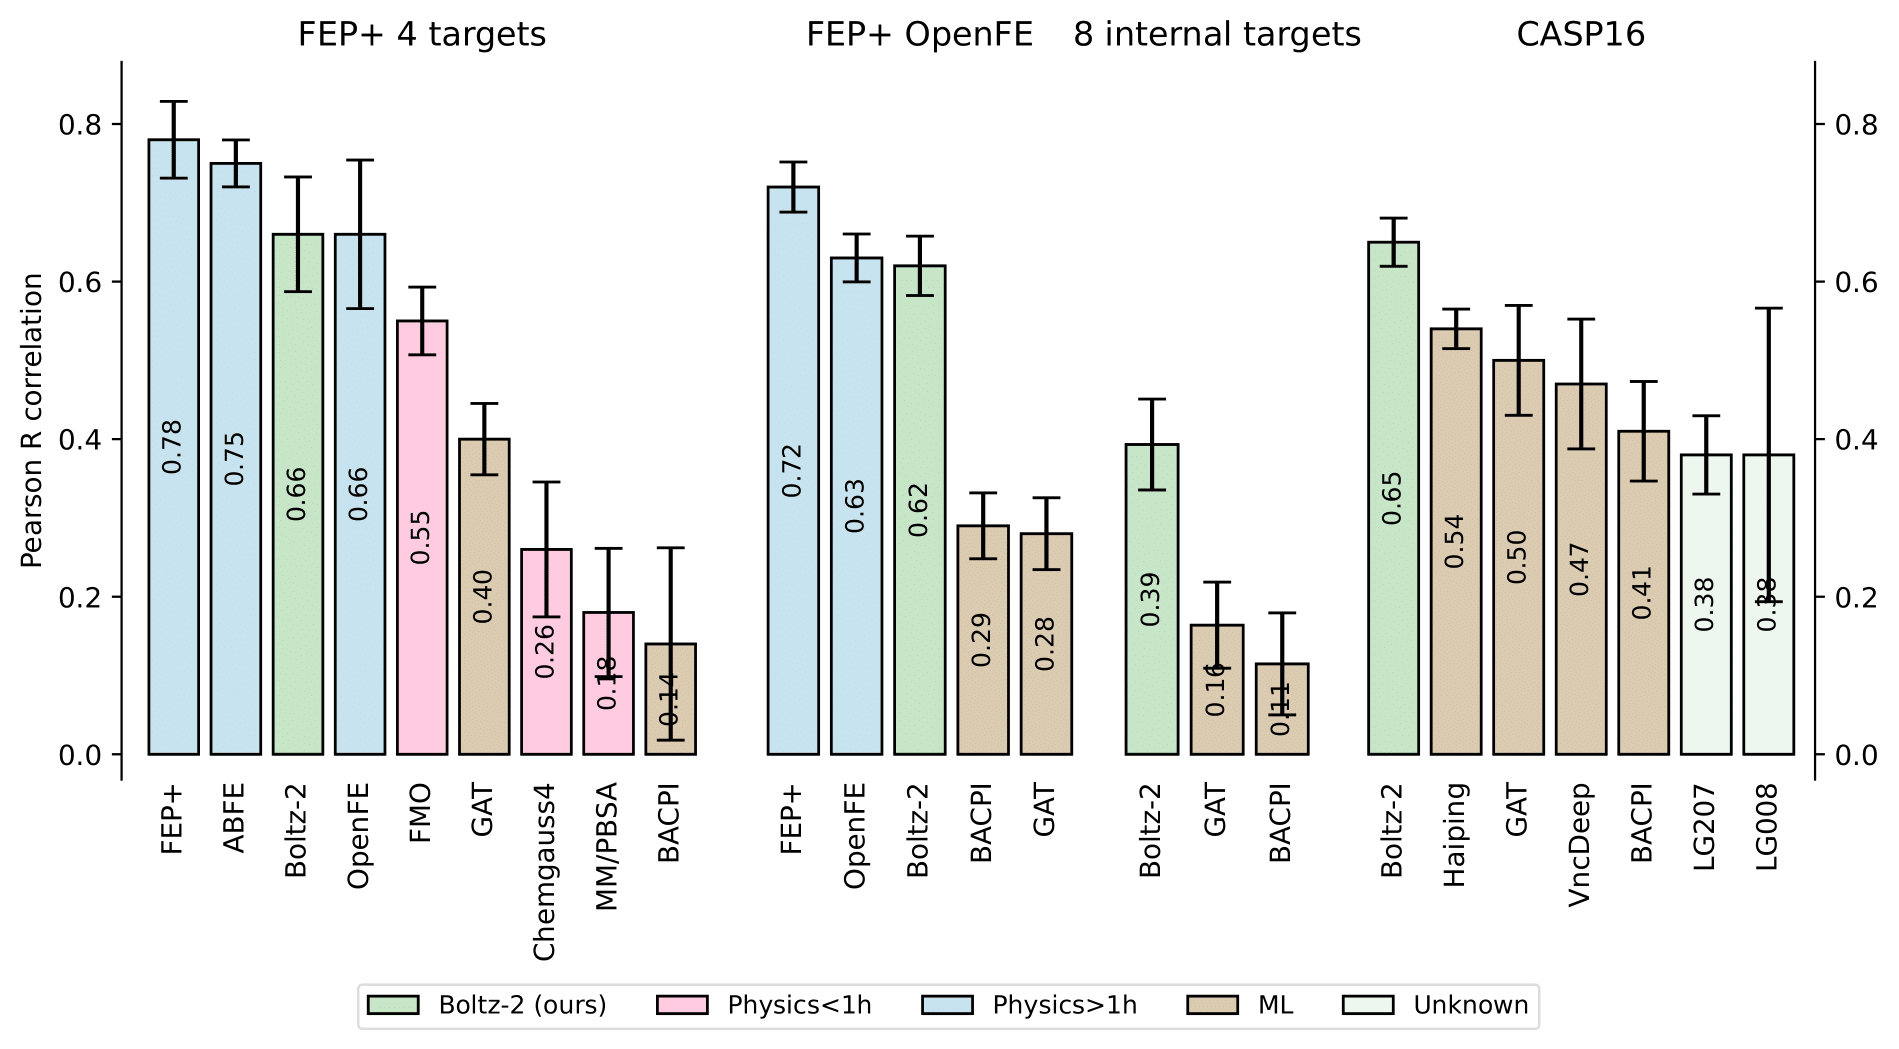
官方评估图。看中间 FEP+ OpenFE 一组的两根柱子,再留意左右各组测试范围不同;打开原图可放大读标注。来源:Boltz 官方仓库,非编辑实测。
我的判断是,Boltz-2 最有价值的增量在于让“生成一个姿态”和“为候选取舍提供依据”接上了,而非把结构图变得更漂亮。官方页面还介绍了结合生成模型进行 TYK2 筛选的尝试,其中候选随后接受的是 ABFE 计算模拟检验。这个案例能支持计算流程之间的衔接,不能当作湿实验已经确认疗效,也不能将发布方的速度比较套到任意硬件和任务上。
真正开始前,要核对哪一条边界
结构建模可以涉及蛋白质、DNA、RNA等组分,亲和力模块的适用范围却更窄:当前文档支持小分子对蛋白质靶标的亲和力。文档特别提醒,换成 RNA、DNA 或辅因子靶标,即使程序没有报错,输出也不可靠。配体大小也有训练与输入限制,不能只看文件是否能被读入。
输入还需要蛋白质的多序列比对信息,可自行提供,或选择调用 MSA 服务;后者会让这一步依赖外部服务。准备敏感序列时,这个数据去向是流程选择的一部分。已有实验接触信息或结构模板则可以作为约束,使预测围绕已知信息展开。
代码仓库明确将代码和模型权重按 MIT 许可开放,允许学术与商业使用;这不等于输入数据库和外部服务也共享同一许可。仓库目前仍把 Boltz-2 的完整训练、更新评估代码列为待提供内容,不能由“权重可下载”推断重训流程已全部齐备。
以上为编辑整理,功能、许可与使用条件以官方说明为准。