
Chandra 2:先选报告中的几页,再把公式和正文留成可编辑文件
为什么值得关注
让复杂文档的选定页面成为可编辑、可检查的文件,而不是只拿到一段总摘要。
适合谁:处理长报告、数学讲义与复杂扫描资料的技术编辑和文档应用开发者
这次有哪些亮点
- page-range明确处理范围,CLI默认走vLLM服务
- 按文件保存Markdown、HTML、元信息和图片
使用前需要知道
代码Apache2,权重为修改版OpenRAIL-M;商业规模/竞争用途及模型和输出的署名、同许可条件须分别核对,托管API与开放权重不同。
一份几百页报告,真正需要整理的可能只有其中的技术附录。Chandra 2的实用入口,是先选页,再把正文、公式和图像整理为可以继续编辑的材料。它支持图像与PDF,输出不止一段聊天答案。
官方README介绍的是2026年发布的Chandra 2;Datalab托管平台使用改进模型和其他组件,不能把平台宣传的能力与开放权重完全画等号。这里沿本地CLI及实际保存逻辑解释交付物,未运行模型。
先处理需要的页面
CLI的--page-range可以指定如1-5,7,9-12的范围。对技术编辑,先取正文里的方法与附录,或单独处理几页公式密集材料,比一开始转换整份文件更容易核对输入和结果。
默认推理方式是vLLM服务;选择--method hf则走本地Hugging Face模型。前者需要先准备服务,后者要安装相应训练框架依赖。命令很短,并不意味着机器无需权重、算力和环境准备。
数学页里的不同内容,应该怎样留下
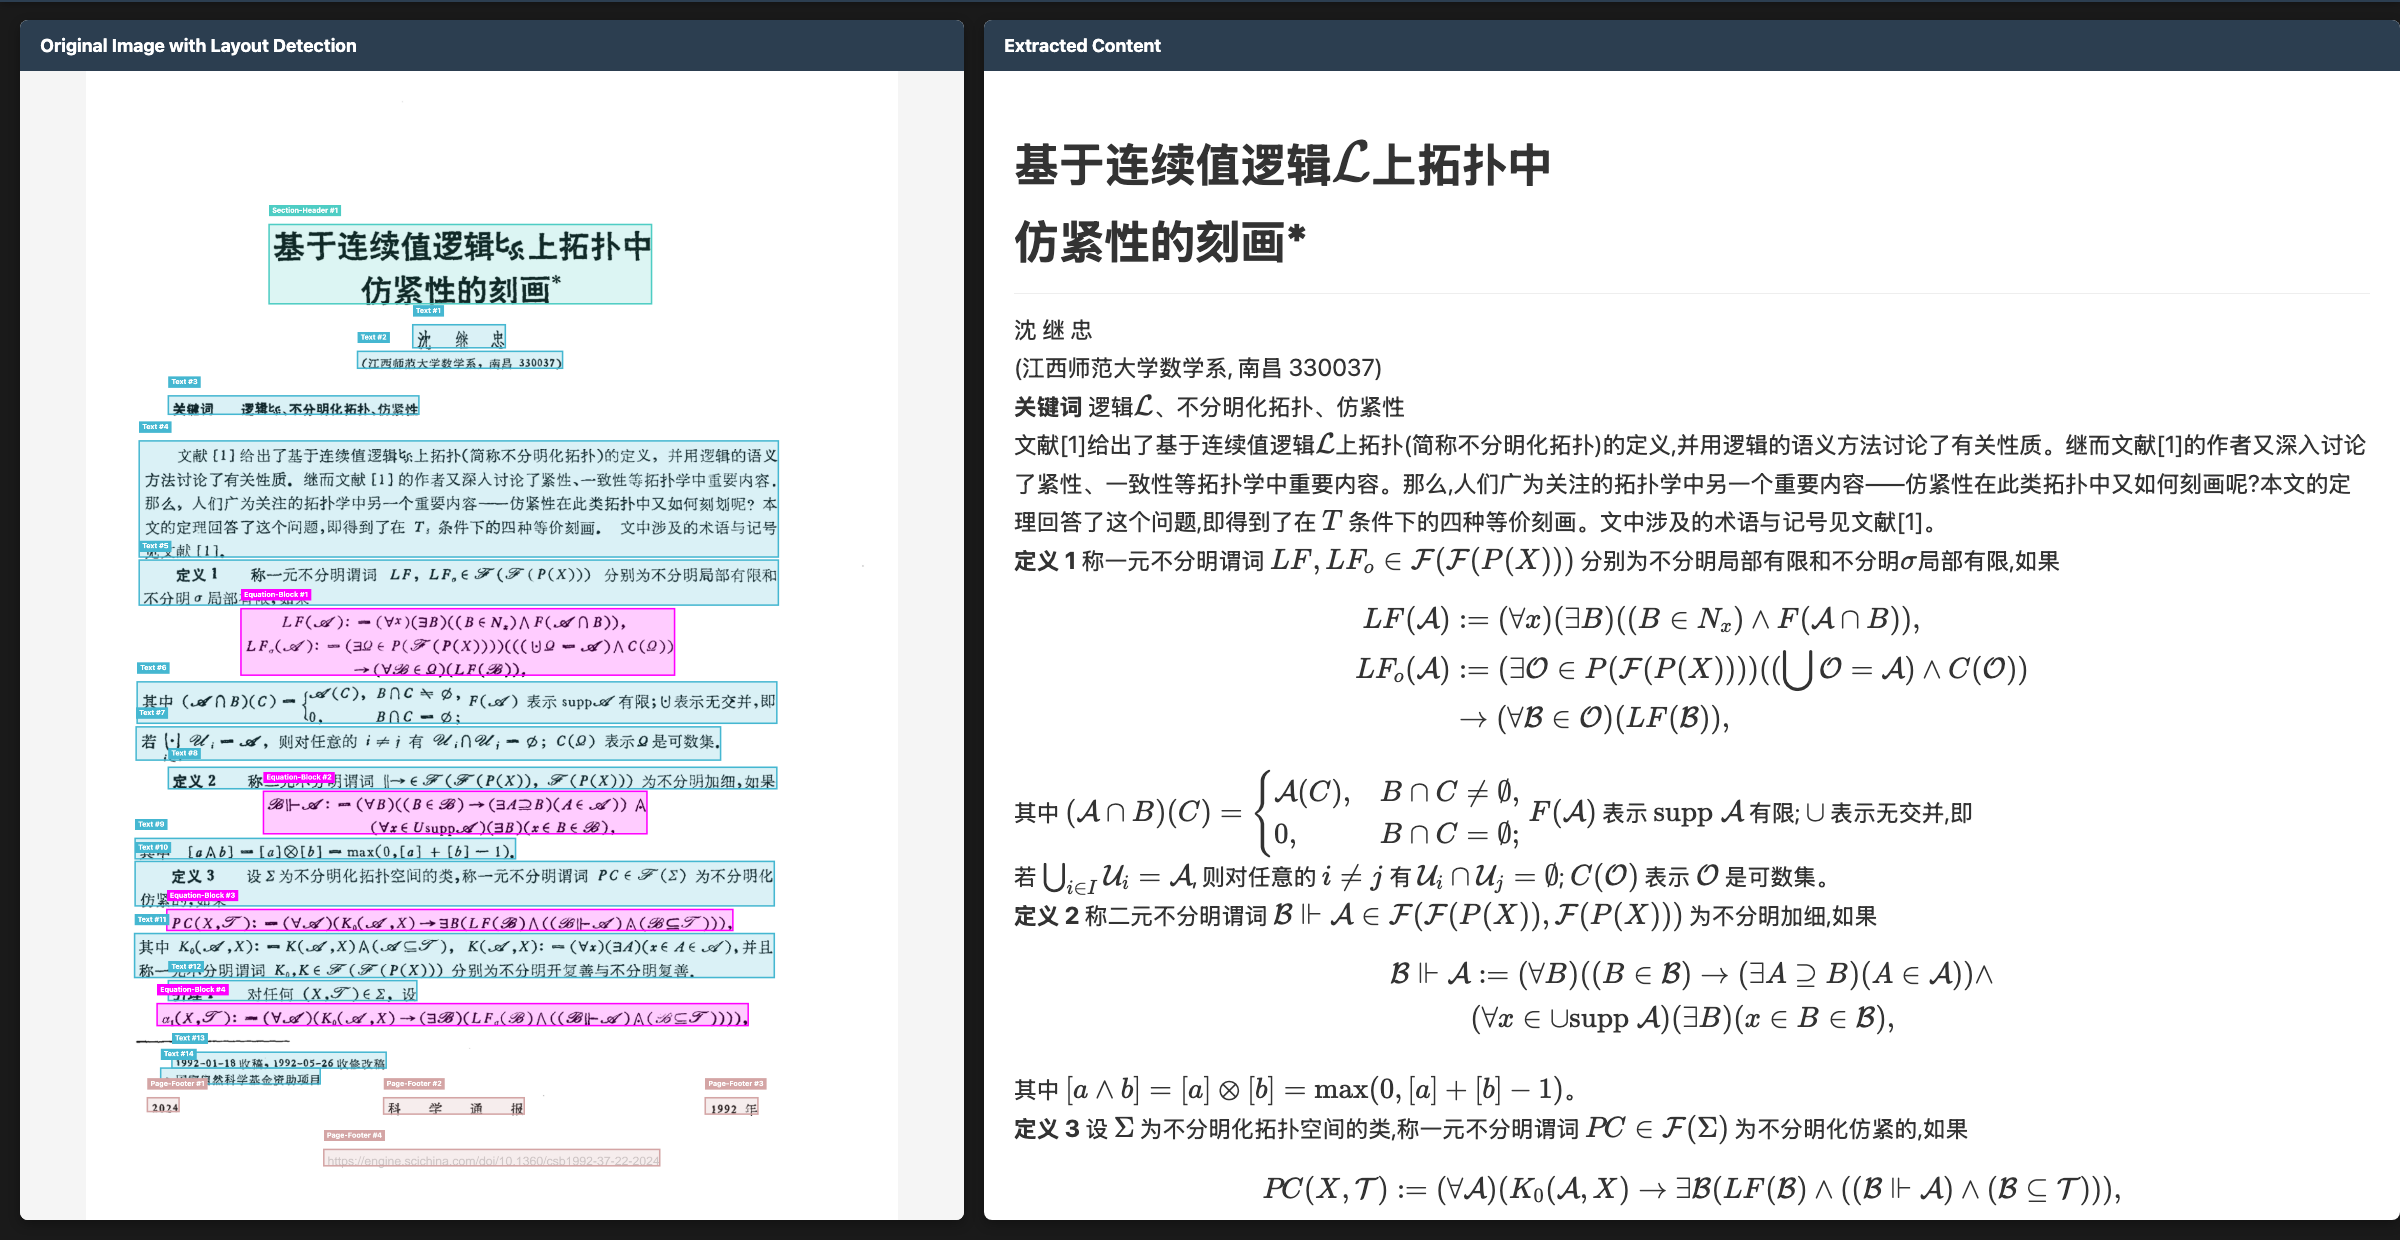
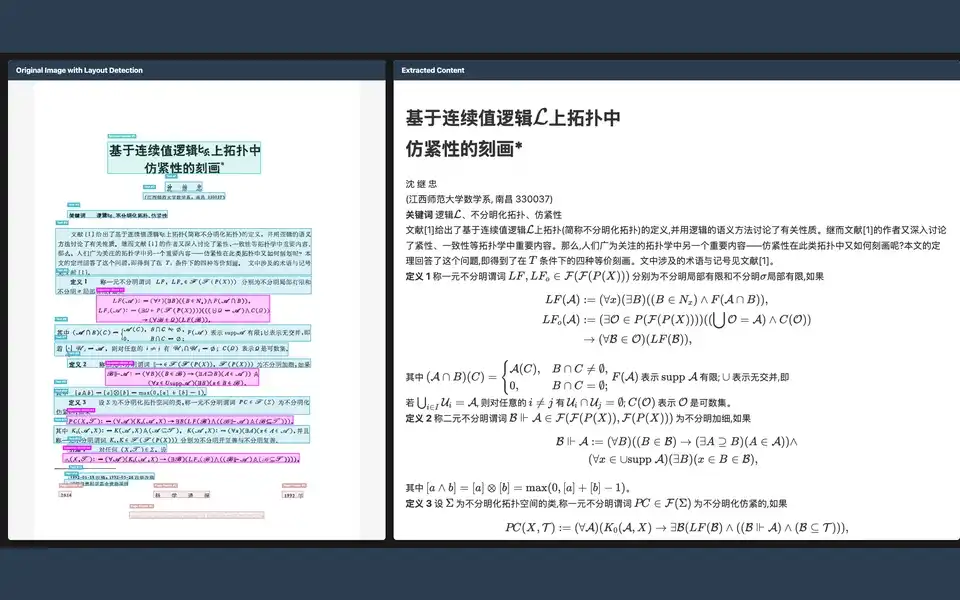
图源:Datalab官方README中的Chinese Math样例。原页里的正文和公式被分别标注,右侧重新呈现标题、作者与数学表达;这是官方展示,未由本文运行或验证每个符号。
这张对照图说明,任务不只是认出一串汉字。正文顺序、公式的位置和表达方式,都影响转换后能否继续阅读。实际整理时,可以先看某个定义前后的段落是否连贯,再对照分式、上下标与括号;版面看起来干净,仍不代表数学含义完全相同。
一个文件,留下多种可检查产物
保存源码为每个输入文件建立子目录,合并各页生成.md与.html,另写_metadata.json。元信息记录页面数量、token、内容块和图片数量;抽出的图片也保存在对应目录。
Markdown便于接笔记和文本处理;HTML保留另一种展示结构;元信息则帮助追查本轮究竟处理了多少材料。默认不插入显式页间分隔,需要时可开启对应选项。不要在合并之后丢掉原文件与选页记录,否则一段文字仍很难回到来源。
源码中的page_num按返回结果从零枚举。只处理PDF中间几页时,不能直接把这个数字当作原文件印刷页码。保留页码映射,是应用将转换结果接进引用系统时需要补上的一步。
开放代码,与权重条件分别看
代码采用Apache-2.0,Chandra 2权重使用修改版OpenRAIL-M。除用途限制外,上一年总营收或累计融资任一超过200万美元的情形、与许可方竞争的产品用途,都有相应限制;模型与输出还涉及署名、同许可等条款。不能只凭代码仓库的Apache标签判断整条商业交付路径。
对选页整理任务,它留下的是能继续编辑的文档材料。先把一小段真实需要使用的内容转换清楚,保留来源、选页范围和各类输出,再决定是否扩大到整批资料。
以上为编辑整理,功能、许可与使用条件以官方说明为准。