Chroma:给内部文档做语义搜索,结果还能回到原文
为什么值得关注
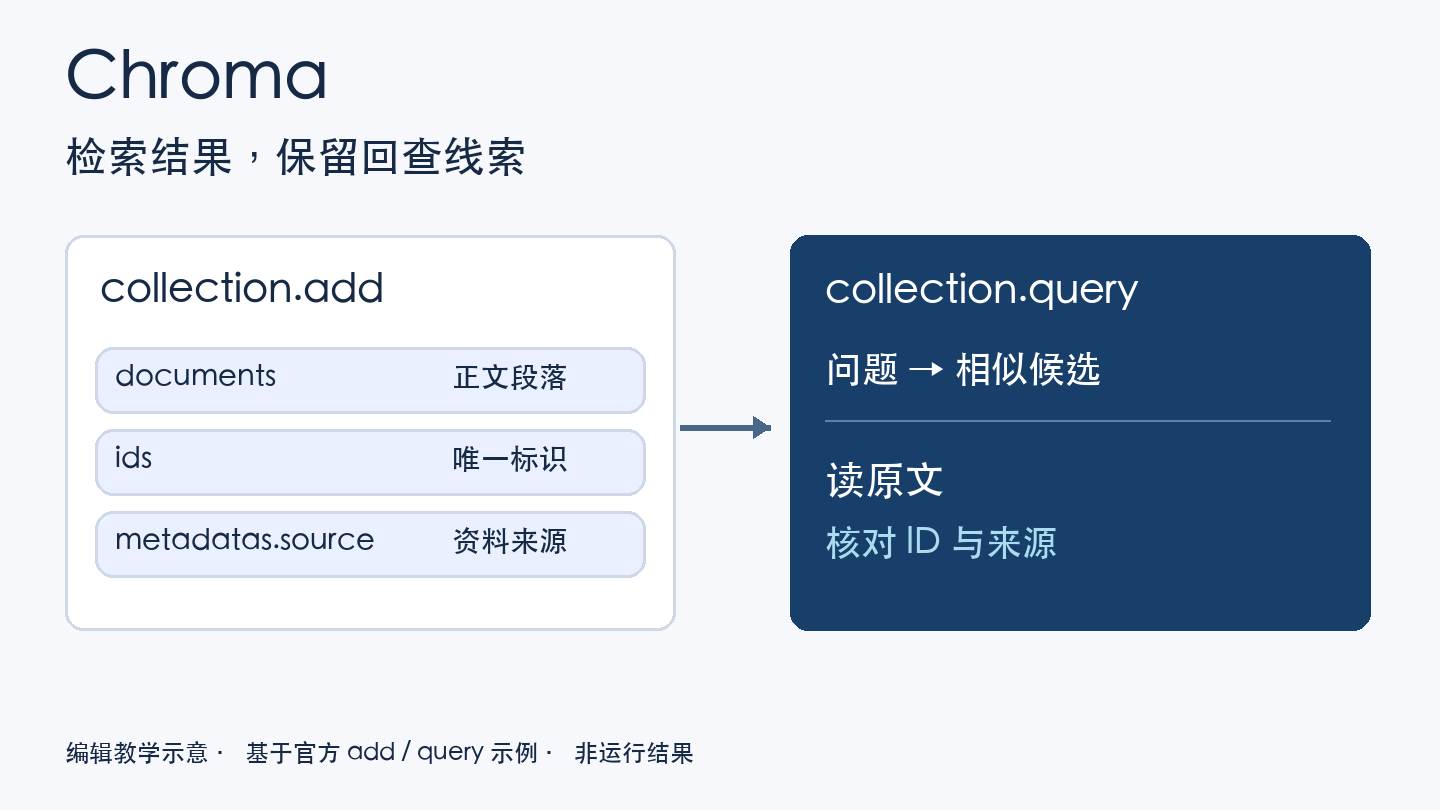
将正文、唯一 ID 和来源元数据放在同一次写入中,让语义检索原型保留回查资料的线索。
适合谁:想为一小批内部文档验证语义检索,并能选择嵌入模型的开发者
这次有哪些亮点
- 同次 add 写入 documents、ids 与 metadatas
- query 按相似度召回,并可结合元数据过滤
- 嵌入函数可挂在 collection,也可自备向量
使用前需要知道
README 的 Client 示例是内存原型;需要落盘应明确使用持久化配置。默认嵌入可能下载模型,中文召回需用实际材料验证;远程嵌入另涉及 API 与数据发送。
同事问“离职后设备怎么还”,制度里写的却是“资产归还流程”。给一小批内部文档做搜索原型时,开发者希望找回对应段落,也希望知道它来自哪份文件。Chroma 的一个实用起点,是在存入正文时就一起保留唯一 ID 和来源,避免语义搜索做出来了,结果却无法回查。
写进去的不只是向量
README 的 Python 示例创建 collection 后,用一次 collection.add 传入三组对应数据:documents 是文字,ids 标识每条资料,metadatas 保存 source。示例的来源值是 notion 和 google-docs,体现的设计很直接:相似内容有自己的身份和出处,不必等模型生成答案后再猜引用从哪里来。
这改变了原型的验收方式。先看 query 挑出了哪几条原文,再核对来源是否正确,比只看一段流畅答案更容易发现检索问题。Chroma 在这里承担存储、索引与找相似内容;答案撰写仍是后续应用要安排的步骤。
以教学情境说明,可以把制度段落逐条存入,给每段一个唯一 ID,来源记录文件名或可回查地址。查询“离职后设备怎么还”时,让 query_texts 提交问题,n_results 控制候选数量。若资料分属不同来源,还能通过 where 约束元数据。这个情境没有实际运行,近义问题是否找对段落,需要用自己的中文资料检验。
先选表示方法,再看召回
文档和问题怎样变成向量,会直接影响相似关系。官方文档说明,嵌入函数可以绑定 collection,在添加与查询时调用;也允许先在别处生成向量再写入。默认函数使用本地运行的 all-MiniLM-L6-v2,可能自动下载模型。选择远程 API 则需要相应凭据,并把待编码内容发给该提供方。
所以,中文资料的试验不宜停在“成功返回两条”。可以事先选几个已知答案的真实问题,混入同义表达和容易混淆的制度,再检查候选段落。这样才知道问题在嵌入模型、资料切分还是来源范围,而不是把数据库可用误当作中文检索已达标。
另一个容易漏掉的细节是保存方式。README 明确把 chromadb.Client() 示例称为内存原型;当前源码提供 PersistentClient(path=...) 将数据落盘,并建议生产使用服务器支撑的实例。进程里查到资料,不等于已经建成可长期使用的知识库。
Chroma 仓库采用 Apache 2.0 许可。本篇依据动态 README、文档与客户端源码整理,未运行项目。建议从官方 API 示例开始,只导入一小组可回查资料,先验证召回,再明确持久化和服务方式;需要生成答案时,另接后续模型并检查引用。
来源:
以上为编辑整理,功能、许可与使用条件以官方说明为准。