
Chronos-2:预测一条曲线,也能参考相关序列和已知计划
为什么值得关注
当历史不长、又有相关序列或辅助信息时,Chronos-2 能在预测时共享上下文;官方零售实验具体展示了促销与假日如何进入预测。
适合谁:关心销量、用量等预测的分析人员,以及需要研究多序列和协变量建模的团队。
这次有哪些亮点
- 组注意力让同组相关序列共享信息
- 同时支持单变量、多变量与协变量预测
- 已知未来变量与未知目标分别处理
- 代码和 amazon/chronos-2 权重均标注 Apache-2.0
使用前需要知道
输入主要为数值与类别信息,不直接理解文字事件;官方展示案例经过挑选,不能代表平均效果;预测分位数需结合实际回测解释。
预测门店未来销量,除了历史销售额,往往还有营业安排、促销计划和假日信息。Chronos-2 能把这些材料放进同一个预测任务,也能让相关序列在推理时共享信息。它值得关注的地方,是预测不再只能围着一条曲线打转:哪些序列有关、哪些未来值已经知道,都能成为输入的一部分。
这是 Amazon 发布的预训练时间序列模型,具体权重是 amazon/chronos-2。它与早期 Chronos、Chronos-Bolt 同属一个项目,但架构和能力有区别;不能把旧版“数值转词元再生成”的流程直接当作 Chronos-2 的解释。官方模型卡
看一份有来有回的官方零售案例
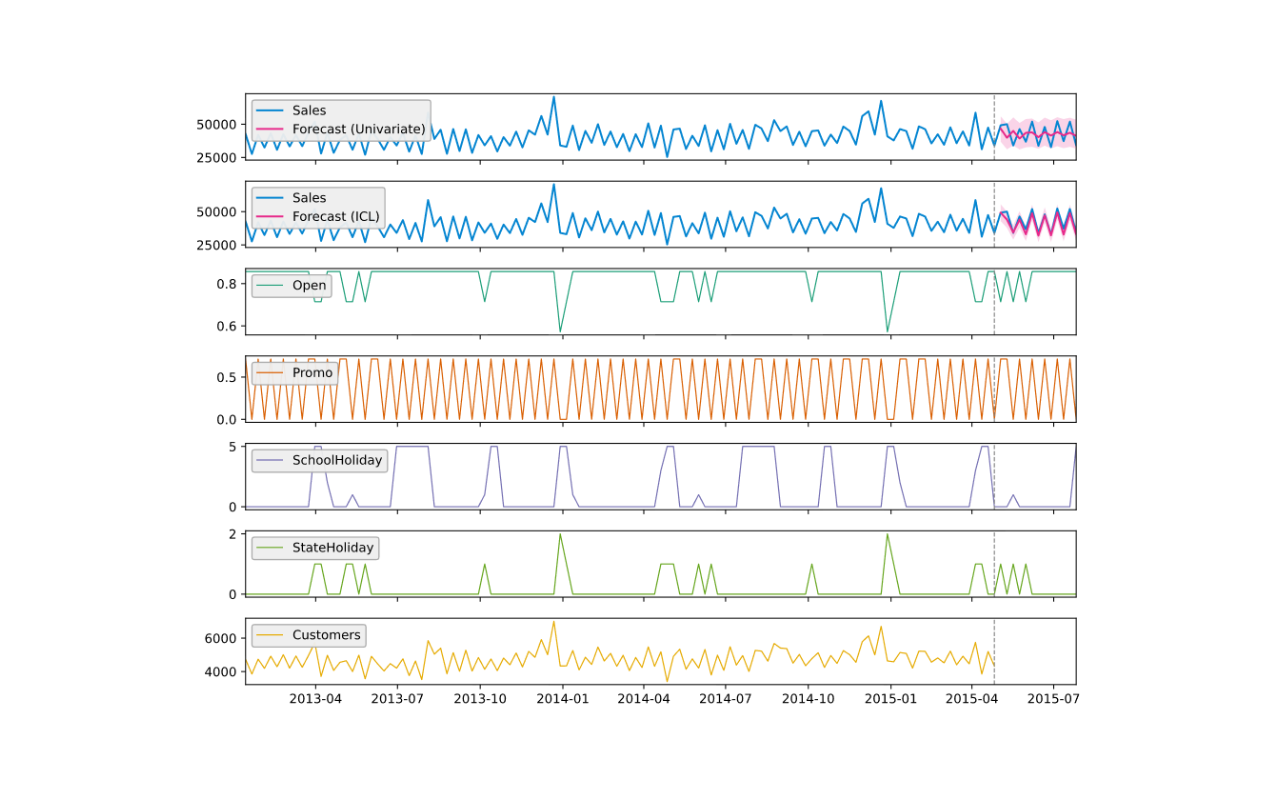
论文选了 Rossmann 门店销售任务:预测下一季度的周销售额,输入历史销量、历史客流,以及营业、促销和假日等已知辅助信息。下面图中,前两行分别是只看单序列的预测和使用上下文学习的预测;蓝色为销量,粉色为预测,虚线右侧是预测范围。下方几行列出了营业、促销、学校假期、公共假日和客流。
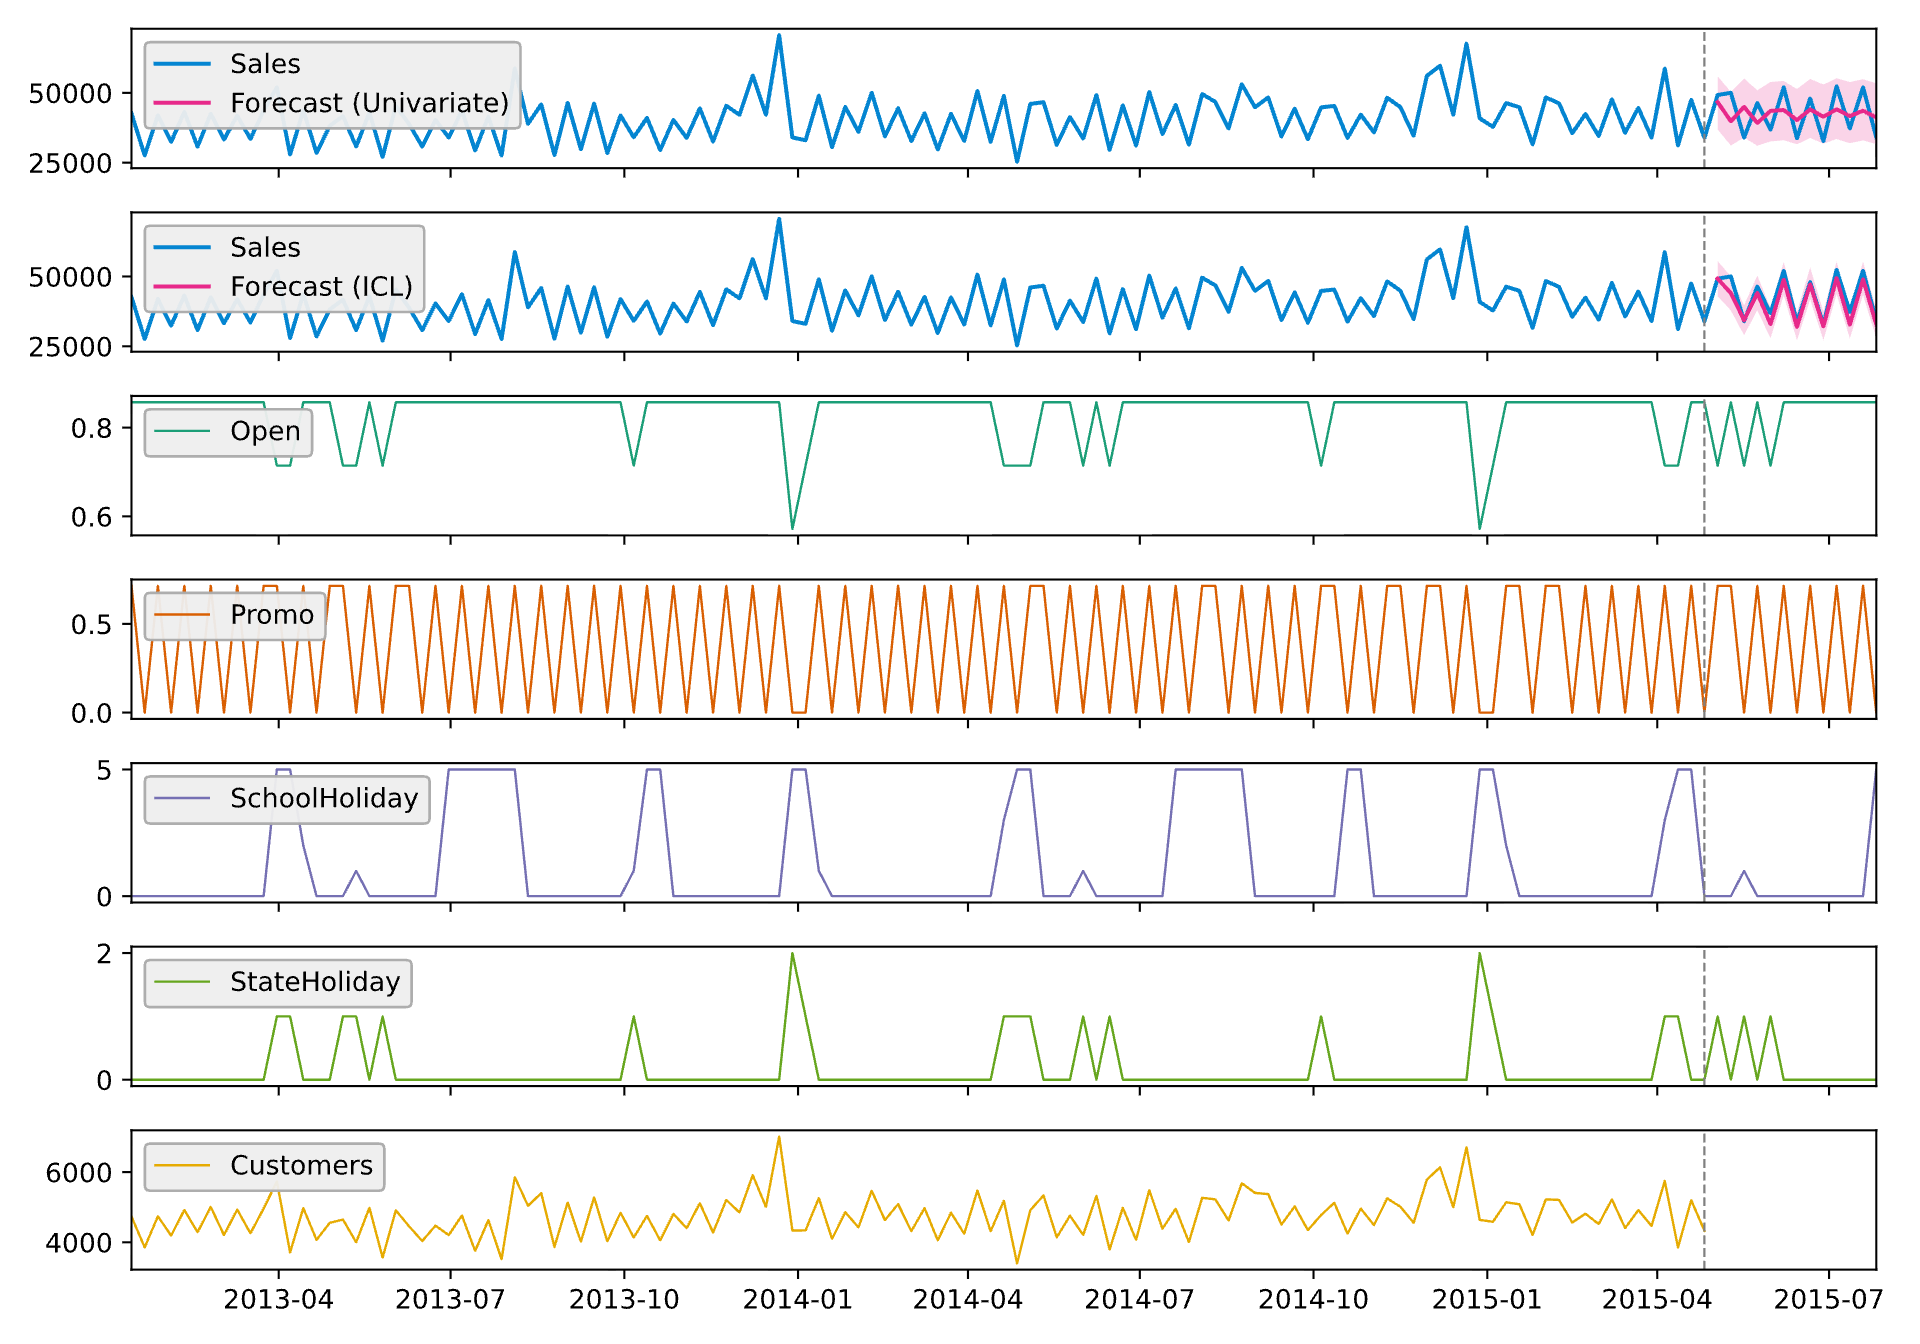
官方实验图,来自论文图 7;SVG 经浏览器渲染。最下方客流在预测起点后不再提供观测值,促销等已知变量仍延伸到未来。阴影表示作者展示的预测区间。打开清晰原图
只看销量时,未来预测相对平缓;加上这些上下文后,模型在图示区间里更贴近销售的周期变化。处理过程不是读取一段“节假日销量会升高”的提示,而是把历史目标与辅助序列切成片段,结合时间位置和缺失标记一起编码,再输出未来的多个分位数。
这一例子给我的判断是:先确认未来哪些列真的拿得到,比寻找一个听起来更大的模型更有意义。历史客流与未来促销的角色并不相同,不能拿测试期的真实客流冒充事前已知条件。论文也说明,这份展示是作者挑选的、上下文学习改善较大的案例,不能用一张图代替全体任务的平均表现。论文第 5.2—5.3 节
让信息共享,需要先说清谁属于一组
Chronos-2 的组注意力会在同组序列之间交换信息,时间注意力则处理各条序列随时间的变化。一组可以是同一个任务的多个目标与辅助变量,也可以是一批具有相关来源或属性的序列。组的含义因此是建模选择,而不是随便把所有列放在一起。
论文把预测方式分开检验:在单变量任务上,共享上下文允许不同条目之间互相参考;在多变量任务上,额外改善较小;带协变量的任务改善最明显。这比一句“多变量总是更准”更值得记住。已有很长历史时,单序列模型也可能捕捉到大部分规律;其他曲线能否带来增量,要通过验证决定。
官方表格接口把这套思路做得比较直接:历史数据表含序列编号、时间戳、目标与辅助列;未来表提供预测区间的辅助值,但先删掉真实目标列。示例预测 24 步,返回点预测以及 0.1、0.5、0.9 分位数。分位数表达模型对不同位置的预测,不能直接承诺实际数据一定按比例落进区间。官方使用示例
可以从哪里开始,什么别期待
Chronos-2 支持 CPU 与 GPU 推理,本地可通过项目推理包加载。仓库代码和该官方模型卡均标注 Apache-2.0;训练使用的真实数据集合、合成数据以及你自己输入的数据,仍要分别看来源和使用条件,不会因为模型许可就自动变成同一种授权。
它接收的协变量主要是数值与类别,不会直接理解一份新品发布稿或临时停业通知。对确有相关历史数据与未来安排的任务,我会先比较“只给目标历史”和“加入有效辅助信息”两个版本,确认增量来自哪里。Chronos-2 提供的是让这些材料参与预测的能力,是否有帮助,最终仍要落回同一份留出数据上。
以上为编辑整理,功能、许可与使用条件以官方说明为准。