
ClearVoice:先压住噪声,再决定是否给录音补高频
为什么值得关注
把语音降噪与高频重建分开选择,依据输入状况保留中间候选,避免规格提升掩盖人声细节损失。
适合谁:整理口播、访谈与已有授权语音录音,愿意运行模型并逐段试听的创作者和开发者。
这次有哪些亮点
- 增强SE与超分SR模型职责分开
- 超分预期干净输入,噪声素材可先做增强
- 单文件、目录及列表可处理,结果可另存
使用前需要知道
本文未运行或听验;高频重建不是无损找回;官方HF演示本次出现依赖错误,本地需环境与算力,ModelScope入口未执行;代码和两组权重许可不覆盖其他模型/依赖及录音权利。
录好一段访谈,回放时才发现空调声很重;另一份旧录音没有明显杂音,却显得闷。两份材料听起来都“不够清楚”,需要做的事可能不同。ClearerVoice-Studio 中的 ClearVoice 把语音增强与语音超分做成独立任务:前者处理背景噪声,后者尝试重建低带宽语音缺少的高频。对整理口播、访谈和声音素材的人,先分清问题,比把每个模型都跑一遍更有帮助。
官方为什么要求先降噪
超分模型卡给出一个会改变操作顺序的条件:MossFormer2_SR_48K 用干净语音训练,预期输入也是干净语音;有噪声时,推荐先使用 MossFormer2_SE_48K 做增强,再进行超分。两者名称很像,但 SE 与 SR 分别承担不同工作。
这意味着“输出变成48 kHz”和“声音已经适合使用”不是一回事。高采样率文件能容纳更宽的频率范围,模型还要估计原材料没有提供的细节;它不能把丢掉的真实信息无损找回来。若原录音有持续风扇声,先补高频也不会自动解决内容被噪声遮住的问题。
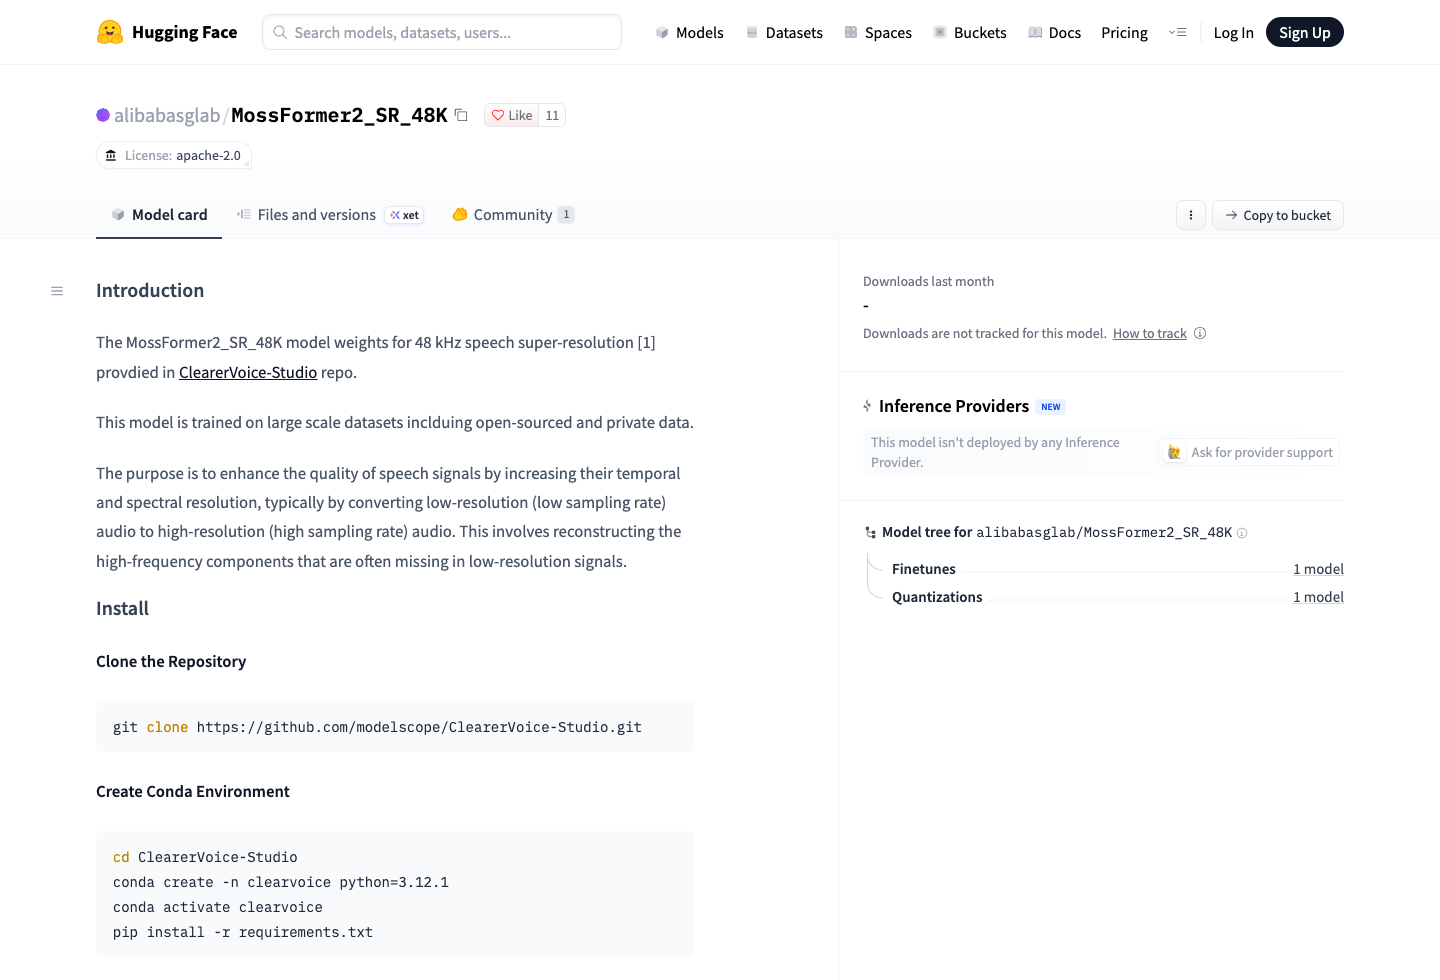
图为官方模型卡实页截图。先认清 SR 型号和48 kHz用途,右侧还说明没有现成推理提供商。它用于辨认模型与入口,不是本文处理后的波形或音质证明。打开原图。
一份输入,先保留能比较的中间文件
官方增强示例从 samples/input.wav 读取一份录音,得到结果后另存为 output_MossFormer2_SE_48K.wav;超分模型卡也给出独立的输入与输出文件路径。两个例子说明的是可接起来的文件处理方式,并不是已经展示同一段录音的连续实测。
例如,假设要整理一段自己录制的中文访谈,可以先保留原文件,只做一次增强,另存候选,再听人声和背景的变化。此处是教学流程,本文没有运行模型或完成听验。如果噪声减轻了,却连轻声尾音也一起变薄,不能只因背景安静就接受结果;应回到原录音,判断这份材料需要保留什么。
增强稿已经可用时,也不必为了规格继续超分。确实希望补充高频,再把候选送入 SR,并保留增强前、增强后及超分后三个版本,比较齿音、呼吸和长元音有没有变得突兀。判断目标是这段话是否更适合收听或继续剪辑,不是文件名里的数字更大。
评测表也透露了处理链的边界
ClearVoice 文档的超分实验使用 VoiceBank+DEMAND 的48 kHz测试集,再降采样成16、24、32 kHz作为输入,并先用增强模型降低噪声。因此,表中的改进来自一条处理链,不能全部归到“补高频”这一个动作上。
文档还特意说明:48 kHz那一列没有使用超分,只做增强。这是很有用的对照——同样叫输出改善,不同输入实际经过的步骤可能不同。本文不拿发布方的指标替代中文访谈听感,也不据此给出模型排名;它提醒使用者先记录输入状况和处理步骤,再比较自己的候选文件。
工具入口不等于所有任务都共用模型
项目还有语音分离、视听目标说话人提取等路线。多人同时讲话、背景噪声和录音带宽不足是不同问题,不能只换一个任务名就假定增强模型会把每位说话人拆成独立音轨。本篇聚焦的是增强与超分两个确切权重。
开发者可从官方 ClearVoice 文档的 pip install clearvoice 和 Python 示例开始。它支持单文件,也能按目录或列表批量处理;权重首次推理时自动从 Hugging Face 下载,失败时另有 ModelScope 下载入口。WAV之外的格式转换依赖 FFmpeg,安装包并不免除模型下载、运行环境和算力开销。
官方 Hugging Face 演示在本次访问时显示依赖导入错误,不能宣传为当下可直接上传试听的稳定服务。项目同时列出 ModelScope 演示,但本文未执行该入口;准备采用时,可优先核对本地示例,再在实际服务里确认可用状态。
仓库代码为 Apache 2.0,本文涉及的 SE_48K 与 SR_48K 官方权重卡也分别标注 Apache 2.0;这不统一覆盖外部依赖、其他模型或原始录音权利。对有权处理的语音素材,ClearVoice 的采用理由是把两种处理拆开、让中间结果能够留下核对。只有确实改善了这次录音的可用性,才值得把下一步接上。
参考资料:
以上为编辑整理,功能、许可与使用条件以官方说明为准。