
找图表里的那一页,ColPali 直接把文档页面当作检索材料
为什么值得关注
为图表丰富的文档提供页面图像检索,找回可供阅读的原页。
适合谁:研究图表文档搜索和视觉资料检索的开发者
这次有哪些亮点
- 以页面图像生成多向量表示
- 文字查询与页面表示进行匹配
- 检索结果可保留原始页面
使用前需要知道
骨干PaliGemma遵循Gemma许可,适配器MIT;训练检索数据为英文,中文效果需独立判断。旧colpali-engine已弃用。
一份报告里的答案,有时就在一张柱状图上。把PDF只转成文字,图例、坐标和旁边说明之间的关系可能散掉。ColPali选择从另一个方向入手:把整页当图像来建立检索表示,再让文字问题去找相关页面。
它交出的首先是“该看哪一页”,而不是替你写好结论。对图表、版面和文字共同承载信息的资料,这个区别很有用。
页面如何参与文字搜索
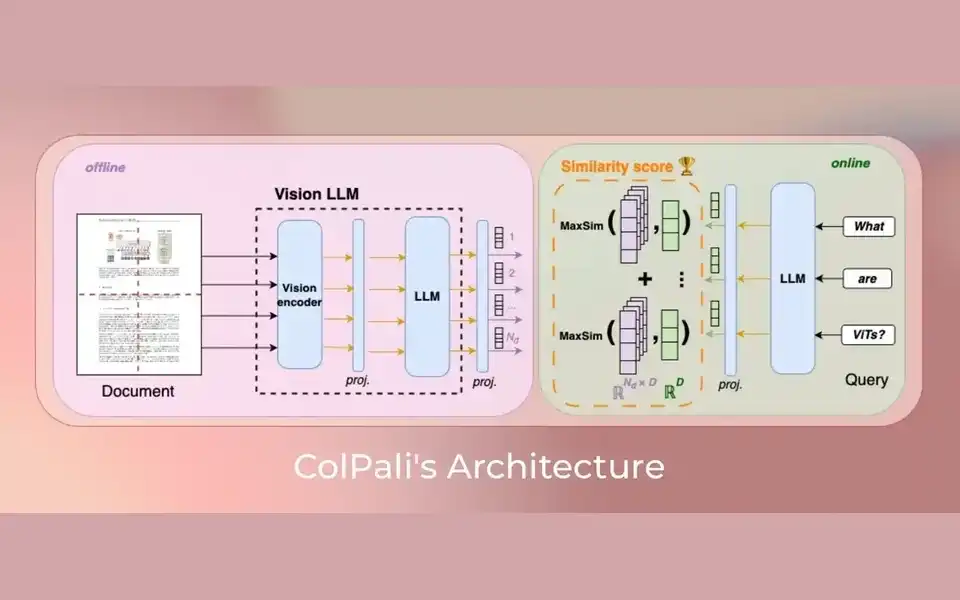
模型卡介绍,ColPali以PaliGemma视觉语言模型为基础,为页面生成一组向量,而不是只把整页压成一个向量。查询也被编码成多个表示,匹配时再比较它们之间的关系,这一方式称为后期交互。
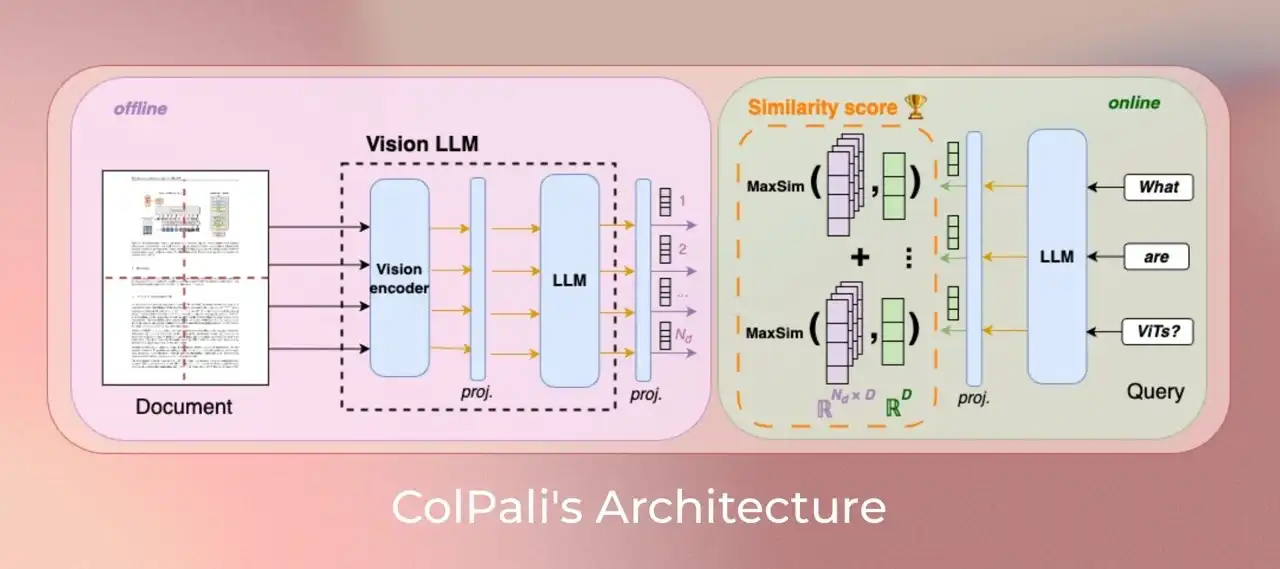
图源:ColPali项目仓库。左侧先处理文档,右侧在查询到来后进行相似度计算;这张图说明检索结构,不是本次运行截图。
对使用者,可以先把它理解为两步:资料入库时保留页面图像及其表示;读者提问后,系统给这些页面排序,并让人打开原页。找到之后是否还要抽表格、生成摘要,属于后续处理。
官方例子找的是图轴与年度数据
模型卡中的示例给出四张文档页面和两条问题:一条问图的纵轴代表什么,另一条问哪一年总支出最高。查询与页面编码后,示例返回两行四列的分数矩阵,每条问题都可以据此挑出相关页面。
这比“支持视觉检索”更能说明用途。问题需要注意图表中的信息,页面的视觉内容不必先全部变成一串OCR文本,才有机会被找回。但矩阵只是相关性,不是图中数值的答案;页面排在第一,也还需要打开核对。
对中文资料,同样不能从这组英文示例推断识别效果。官方说明检索训练数据按英文设计,其他语言表现需要单独评估。若任务是中文年报,至少应保留一组能由编辑直接判断的问题和页码作对照。
现在的新项目,从哪个运行入口开始
项目仓库已把旧 colpali-engine 标为弃用,保留它供研究复现和现有项目使用,并建议新项目转向Sentence Transformers的多向量接口。模型仍可研究,旧运行包的状态不应被藏起来。
多向量也意味着索引组件需要相应支持,不能把结果当成普通单向量随意存进去。许可上,适配器采用MIT,但骨干PaliGemma仍遵循Gemma许可,不能只看一张仓库许可徽章就判断整套权重条件。
如果搜索链路反复漏掉图表页,ColPali提供了一个明确可比较的办法:让问题直接检索页面,再把原页交回读者。它最有价值的结果,是减少寻找相关页面的绕路,并让后续判断仍有原始材料可看。
以上为编辑整理,功能、许可与使用条件以官方说明为准。