
把“不能漏掉退款期限”写进评分标准,DeepEval 让回答进入回归测试
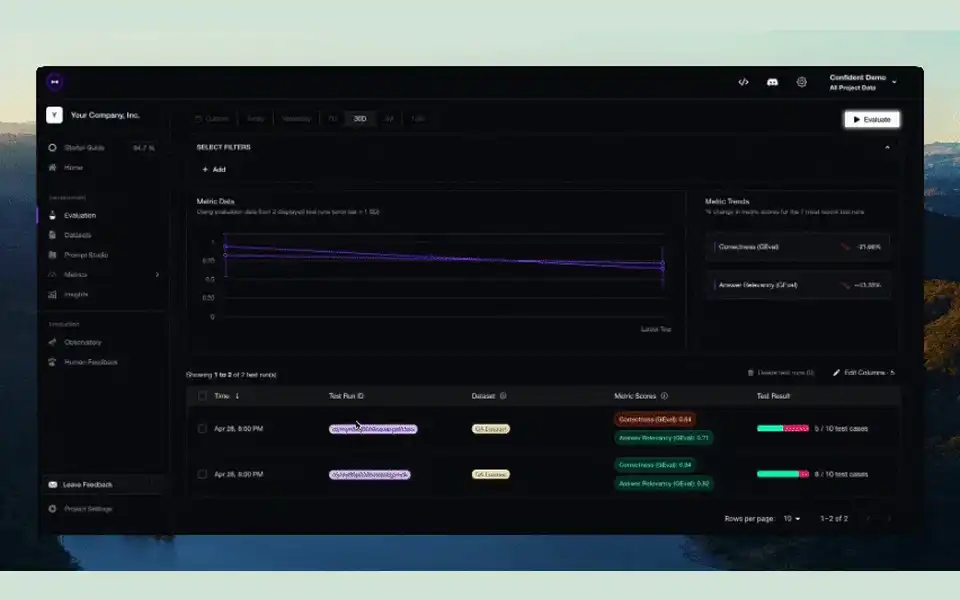
为什么值得关注
把业务验收要求变成可重复执行的检查,避免提示词更新后重要信息悄悄丢失。
适合谁:已有Python AI应用、需要将业务回答质量接入回归检查的开发者
这次有哪些亮点
- LLMTestCase提供问题、实际回答和参考答案
- G-Eval可固定evaluation_steps、读取score/reason并以threshold判定
使用前需要知道
框架Apache-2.0,Confident AI云平台另有服务条件。G-Eval是模型裁判,分数不确定且可能有调用费用;标准、参考答案和所选字段须匹配,不能替代事实核验。
售后助手回答“可以退款”,却漏了“30天内”,读起来仍然顺畅,业务含义却少了一截。DeepEval 的G-Eval允许把这种要求写成评分标准,再接入Python测试,让提示词修改后能够重复检查。
它用模型充当裁判。标准写得清楚有助于比较,但评分不是事实核验的替代品,也不是每次必然相同的程序答案。
一个测试样本,保存要比较的两边
官方README以鞋子退款问题举例:LLMTestCase保存用户input、应用actual_output,以及理想expected_output;GEval根据标准比较,再由assert_test接入测试。
例子里的回答字符串是演示数据,不是编辑本次实际运行应用所得。接入真实项目时,actual_output应换成应用对这条问题产生的结果,参考答案则应来自有效业务规则。
围绕这个案例,可以拟定“与参考答案一致,并且不遗漏退款期限和费用条件”的要求。这里是教学标准,业务若变更,参考材料和检查也要同步更新,不能让旧测试把正确的新政策判成错误。
从一句要求,到明确检查步骤
G-Eval文档提供两种入口:给criteria,让工具生成评价步骤;或者自己提供evaluation_steps。二者应二选一,不能同时传入。
官方正确性示例的步骤包括检查事实冲突、重罚遗漏细节,以及区分模糊表达与事实错误。若已经确认怎样评审,固定步骤可以跳过每次重新生成步骤的阶段,减少标准本身漂移;这仍不保证裁判完全确定。
evaluation_params则决定裁判看到哪些字段。只应加入标准确实提到的材料,例如实际输出和参考输出;把所有字段都塞进去,可能让无关上下文干扰判断。
分数和理由,都应该回到具体回答
每个指标可以读取score与reason,再用threshold判断是否通过。也可增加rubric,描述不同评分区间对应怎样的表现。文档中的rubric区间采用0到10且不得重叠,最终指标分数仍是0到1,不能混为同一种数值。
对于重要规则,值得保留一组已知正确、已知遗漏与已知矛盾的样本,检查裁判是否按预期区分。若它给“漏掉期限”的回答高分,应先修标准或评测设置,而不是直接把高分当成质量证明。
DeepEval代码采用Apache-2.0;接入模型裁判及Confident AI云平台时,分别有调用和服务条件。它在这项任务里交付的是可重复运行、能查看理由的业务回答检查,让“别漏掉这个事实”从口头叮嘱进入下一次改动也会执行的回归流程。
以上为编辑整理,功能、许可与使用条件以官方说明为准。