
DeepSeek-OCR:同一张扫描页,保留版式还是只读文字?
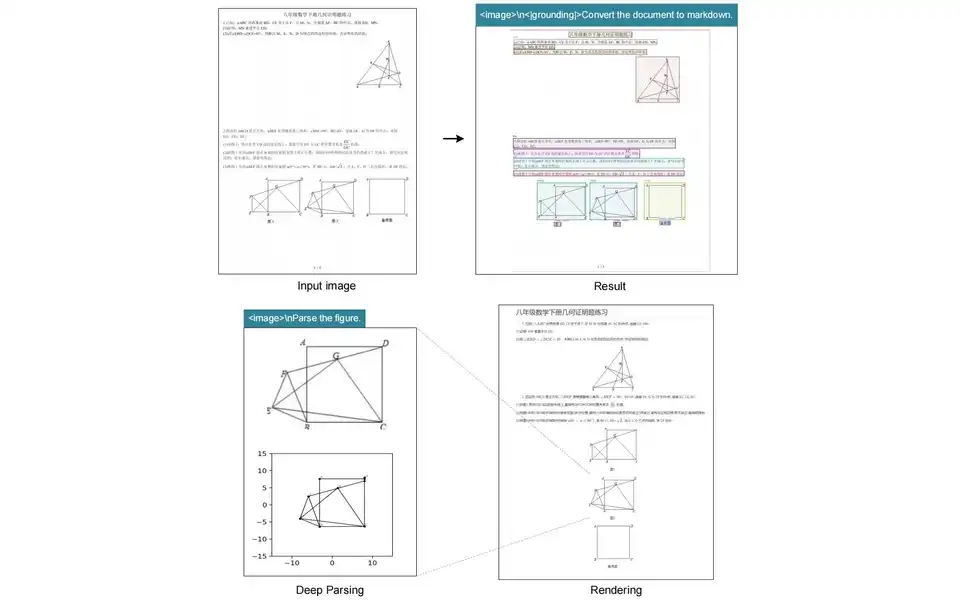
为什么值得关注
把扫描页转成后续可整理的文字或Markdown,并能回看版面与图像位置。
适合谁:准备把扫描报告、讲义接入资料库,能配置模型环境的开发者
这次有哪些亮点
- Free OCR与带grounding的Markdown任务不同
- PDF脚本分别保存原始定位结果、整理文本与版面预览
使用前需要知道
本文限定2025年初代,不移用2026年OCR2能力;需GPU与对应依赖,疑似重复页可能被脚本跳过,输出仍须逐页核对。
扫描报告里的文字能复制出来,不代表标题、段落和配图仍然连得上。DeepSeek-OCR给了两个不同入口:只取文字,或按文档结构生成Markdown。选哪一个,应从下一步要做什么决定。
这里介绍2025年发布的初代DeepSeek-OCR。当前仓库已链接2026年的OCR2;两者不能混用同一份环境说明与效果预期。下文按初代模型卡和PDF处理源码解读,未执行推理。
复制一段文字,与整理一页文档不同
完整模型卡的两种提示很短:Free OCR.面向文字读取;带<|grounding|>的Convert the document to markdown.则用于文档转换。图像标记、任务文字与图片一起交给模型,输出目标由这份提示明确表达。
假设要整理一份公开培训讲义,这是教学情境。只想引用一段说明,可以先看文字识别;希望把标题、正文和插图继续放进知识库,则更需要文档结构。前者不必被加工成一份复杂页面,后者也不能在拿到连续文字后就视为排版关系已保留。
仓库另列图表解析、图像描述与定位指定文字的提示。这些是不同任务入口,不能把图像描述生成的解释,当成逐字抄录的原文。
PDF脚本实际交出三类材料
官方PDF脚本先将每页渲染成图,再逐页组织模型输入。它同时写出带定位标记的_det.mmd、整理后的.mmd,以及画出区域框的_layouts.pdf。
整理过程中,图片区域被裁出,正文中的相应位置改成图片文件引用;其他定位标记则从阅读版本中去除。因此,只有一份文字文件还不够:若移动到新目录,相关images目录也要一起保留,否则原来能显示的插图会断开。
三类材料适合做不同检查。整理文本便于继续编辑;定位结果保留模型原始结构;版面预览帮助看一张图或一段文字究竟被划在哪里。它没有把原PDF自动变成可在Word里逐项修改的原生排版。
脚本还提供SKIP_REPEAT。开启时,未产生预期结束标记的结果可能被跳过,不能因输出文件已经生成,就断言所有页面都已完整保留。交付前对照原页数和关键页,比只看文件是否存在更可靠。
分辨率与部署条件一起选择
官方列出512、640、1024、1280等原生输入模式,以及由多块640图像和一张1024全图组成的动态模式。它们改变图像进入模型的方式,并不保证小字、表格合并关系或公式都能原样恢复。
初代文档使用特定Python、CUDA、PyTorch与推理依赖组合;旧文中的nightly安装说明有其发布时间背景,新部署应核对当前对应路径。代码为MIT,模型卡也标MIT;输入文件的使用权仍按资料来源判断。
这个项目最具体的用途,是把“认出字”和“留下文档关系”拆成可选择、可回查的任务。先确定最终需要文字、结构还是区域定位,再保留相应产物,后面的整理才有依据。
以上为编辑整理,功能、许可与使用条件以官方说明为准。