
Dia-1.6B-0626:把英语双人脚本连成一段对话
为什么值得关注
把角色轮次与非语言反应放在一份连续脚本里,能直接探索双人接话的配音方式,减少先按角色拆成独立旁白的准备。
适合谁:制作英语课堂问答、短播客样稿或双人动画试配,能编辑英文脚本并试听的读者。
这次有哪些亮点
- 通过 [S1]、[S2] 在一段脚本内生成角色轮换
- 可在脚本中加入笑声、咳嗽等列出的非语言标记
- 参考录音配合带角色标签的转写可提供声音条件
使用前需要知道
指定权重只支持英语;标记过多可能产生异常,长短输入也会影响节奏。纯文本运行的声音可能变化,官方硬件测试以 GPU 为主。
做英语听力材料、动画试配或短播客样稿时,两个人轮流说话,比两条各自顺滑的旁白更难处理。你需要交替的角色、接话的节奏,有时还要一句话后的笑声。Nari Labs 的 Dia-1.6B-0626 提供了一条直接的路线:把带角色标签的英语脚本整体交给模型,生成一段包含角色轮换的对话音频。
它是一组 1.6B 参数的语音生成权重。本篇讨论的入口固定为 nari-labs/Dia-1.6B-0626。当前仓库虽也放着 Dia2 的链接,那是另一个项目,不能把新入口的能力算到这组权重上。对中文读者同样需要先说清用途:官方明确表示这组模型目前只支持英语生成,适合用中文理解方法、制作英语材料。
标签是在交代谁接着说
官方示例先让 [S1] 介绍 Dia,再由 [S2] 接话,随后 [S1] 表示惊讶并带上 (laughs),最后交回 [S2]。值得看的是整个顺序:角色信息与台词处于同一段输入里,笑声也落在对应角色的话后面。
[S1] 和 [S2] 可以理解成脚本里的说话人标记。它们不是需要念出的单词,也不只是给两份音频文件起名字。模型按这份连续脚本生成对话,创作者因此可以把精力放在谁回应谁、反应写在哪一句,而不是先把每个人的旁白独立生成再手工拼接。输出仍是一段待试听的音频,并不能据此承诺获得两条可单独混音的角色分轨。
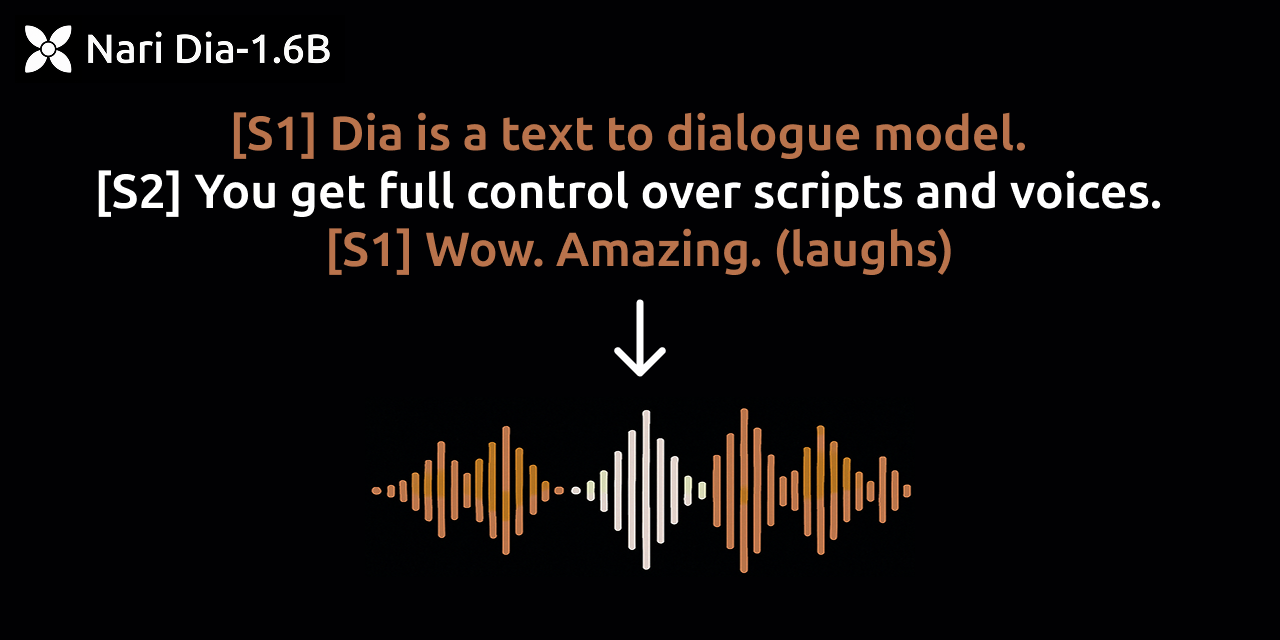
官方图用橙色与白色区分 S1、S2,并在 S1 的反应后标出 (laughs)。它说明输入脚本的结构;下方波形是示意,不能用这张图判断声音自然度或英语发音质量。
一段能跟上的对话,要控制脚本长度
假设要制作一段英语课堂里的问答,先安排一个人提问、另一个人回应,再决定哪里需要反应声。这是教学情境,本文没有运行模型或生成课堂样音。它与官方示例相通的地方,是把轮次和反应写进输入,而不是期待模型替自己编好对话。
README 给出的生成建议很具体:从 [S1] 开始,并交替使用两个标签,避免连续两段都标成同一个人。文本也应适中;按官方经验,对应少于约 5 秒的输入容易不自然,超过约 20 秒则可能说得过快。它们是试用指导,并非严格的音频长度上限。对较长教学材料,我会先按完整的小问答组织片段,保留接话关系,再决定怎样分段。
笑声、咳嗽、叹气等非语言声音也有列出的标记,例如 (laughs)、(coughs)、(sighs)。官方同时提醒要少用,未列出的写法或过度使用可能产生异常。这让脚本编辑有了明确取舍:反应声用来表达某个角色的具体反应,不能靠每句都加括号来保证对话生动。
想保留角色声音,还需要参考条件
只输入文本时,官方说明不同运行可能得到不同声音。角色标签解决的是轮到谁说话,并不自动固定你想要的声线。需要延续声音时,可以添加参考音频或固定随机种子;前者还要配上与录音对应的转写,并正确标记角色。仓库建议参考录音约 5 至 10 秒,转写放在新脚本之前,生成时只输出新脚本内容。
这一步适合已有授权角色素材的试配工作:录音提供声音条件,文字转写把录音与角色对应起来,新脚本才是要新增的内容。固定种子则是另一种复现条件,不能理解成已经为两位角色建立了长期声音档案。正式使用前仍应试听接话、读错字词和角色漂移。
真实起点是这组权重的 Hugging Face 页面和官方仓库;README 还链接了对应的 ZeroGPU Space。想自己运行的人可使用仓库示例或 Transformers 路径,官方展示了把结果保存为音频文件的方式。材料中的硬件测试以 GPU 为主,首次运行还需下载 Descript Audio Codec,不能把模型参数小直接等同于普通电脑即开即用。
仓库采用 Apache 2.0,模型卡也标注同一许可;官方同时要求避免未经许可模仿真实人物或用于欺骗。对需要短段英语双人材料、愿意编辑脚本和试听的人,Dia 的价值在于让角色轮次进入同一个生成过程;若任务本身是中文对话,就应先换到明确支持中文的模型路线。
参考资料:
以上为编辑整理,功能、许可与使用条件以官方说明为准。