
Dolphin-v2:把文档中的代码、公式和表格分开识别
为什么值得关注
通过当前元素级脚本解释文档代码截图如何获得保留缩进的文本,并保留整页解析的坐标和顺序。
适合谁:整理技术教材、含代码与公式资料的开发者和研究人员
这次有哪些亮点
- 当前主线Dolphin-v2为3B,区别早期0.3B版
- 代码、公式、表格分别使用对应提示与输出表达
- 整页结果保留元素位置与阅读顺序,局部可单独识别
使用前需要知道
需要自行准备模型和依赖;根许可为Qwen研究许可、含非商业条件,不能用个别MIT源码标记推断模型可自由商用;中文标签不等于任意拍照材料效果保证。
技术教材的一页里,正文可以连成段,代码的空格却不能随意合并,公式又需要另一种表达。Dolphin 当前主线 Dolphin-v2 把这几类内容分开处理:先确定页面里有哪些元素、按什么顺序阅读,再针对代码、表格和公式生成不同形式的内容。对整理教材的人来说,价值在于识别结果仍能保留各类材料自己的结构。
一段代码可以成为独立输入
官方元素级脚本接受一张元素图片,并提供 text、table、formula、code 四种类型。选择代码时,脚本使用 “Read code in the image.” 提示,结果归入 code 标签;公式和表格则使用各自提示。
可以用一个教学任务理解它:教材整页 OCR 已经得到正文,但其中的 Python 代码缩进丢了,就将那一块裁成图片,按代码类型单独识别。裁剪应包含完整代码块,保留其行首空间;输出是识别文本,不等于一段已经运行通过的程序。读者需要核对缩进、变量名和符号,之后才能把它放入编辑器。
当前模型卡明确将保留缩进列为代码解析的目标;公式对应 LaTeX,表格对应 HTML。这些格式表达的是不同关系:代码需要层级,公式需要数学结构,表格需要行列。把它们全部变成一长串普通文字,会提前丢掉后续编辑需要的信息。
整页解析如何把局部接回原页
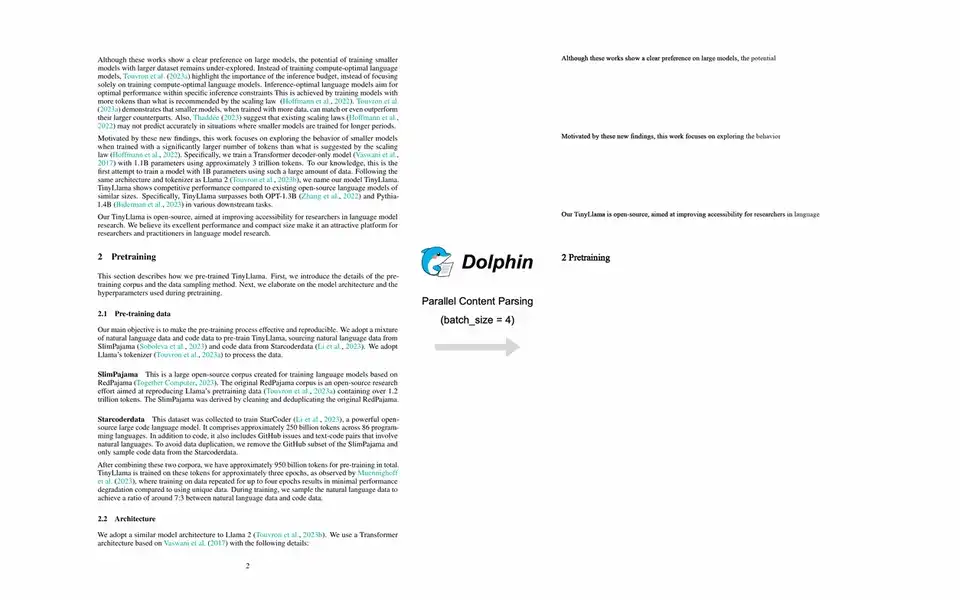
如果材料没有现成裁剪,页面级流程会先预测阅读顺序,再按元素边界裁图。当前页面脚本把表格、公式和代码分组进行识别,随后依 reading_order 排回顺序。每块结果保留 label、bbox、text 和顺序信息;图片则单独保存,并在结果里留下引用。
这让教材整理不必只保留一份最后的 Markdown。比如正文已能阅读,只有某个公式可疑,可以根据元素位置回看原页。多页 PDF 会先转成页面图像,再在合并结果中记录页码和元素。局部重做与整页输出因此能衔接,但“只重新识别某块并自动覆盖旧文件”的编辑界面仍需自己实现。
Dolphin-v2 还区分数字文档与拍照文档:数字页适合按元素并行,拍照页使用整体解析策略处理变形。代码中也有布局异常或框重叠较多时回退整页的逻辑。因此不能假定所有输入最后都会得到同样细的元素分块。
先确认型号与许可,再考虑采用
当前仓库已将主线切到 3B 的 Dolphin-v2,早期 0.3B 和 1.5 版本放在旧分支。模型卡标注中文、英文,不能据此推断歪斜拍照、细小字或复杂代码都已识别可靠。
许可尤其不能只看某个脚本。推理脚本带 MIT 标记,但仓库根 LICENSE为 Qwen RESEARCH LICENSE AGREEMENT,写有非商业用途及商业使用另行申请条件。准备嵌入商业教材服务时,应先取得适用模型和组成部分的明确授权。对研究与资料整理而言,可以先沿元素图片入口理解它的产物,再决定是否需要整页解析;重点是把难编辑的局部恢复成适合继续处理的结构。
以上为编辑整理,功能、许可与使用条件以官方说明为准。