
dots.mocr:读出文档结构,也能把示意图交成SVG代码
为什么值得关注
让文字、公式、表格与图形有不同输出约定,避免只留下失去版面关系的一段OCR文本。
适合谁:整理带图论文、技术教材或复杂文档,需要保留结构的开发者与技术编辑
这次有哪些亮点
- 版面任务输出区域框、类别和阅读顺序,公式LaTeX/表格HTML
- 图像转SVG有独立提示与优化型号,非普通OCR顺带保证
使用前需要知道
旧dots.ocr-1.5在2026年更名dots.mocr;SVG专用版本与文档解析入口分开,复杂表格公式与图形仍可能失败,截图不等于编辑文件质量验证。
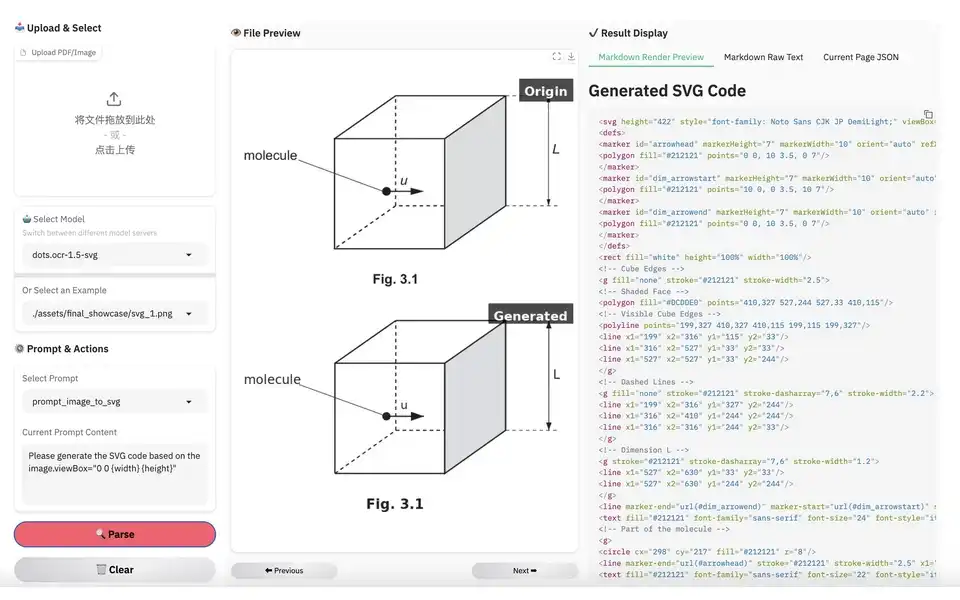
论文里有一张立方体示意图,普通OCR读出molecule和L两个标签,并没有把线条、箭头和图形关系留下。dots.mocr提供了另一种输出:让图像变成SVG代码。它同时保留文档版面解析,二者解决的任务不同。
先认清名称:旧官方仓库的公告在2026年3月说明,dots.ocr-1.5已更名为dots.mocr,并另发布面向图像转SVG优化的dots.mocr-svg。旧截图仍可能保留1.5名称,不能因此把它当作另一款独立产品。
页面里每种内容,留成什么格式
官方提示定义把版面输出写得很具体:每个区域有坐标框、类别和相应文本,按人的阅读顺序排列。公式按LaTeX表达,表格按HTML表达,其他正文与标题用Markdown;Picture区域不要求填入文字字段。
这比一段连续文本更适合继续接阅读器或资料系统:程序可以知道哪块是标题、哪块是表格,也能把某段文字指回页面位置。它仍是模型预测,区域顺序、表格跨行和公式符号需要回到原页检查。
仓库还提供只检测布局、只取文字和给定框内取文字的提示。已有版面检测时,不必每次都让模型重做全部工作;只要一段原文时,也不必误把解释或翻译作为OCR结果。
图形代码,要走另一个入口
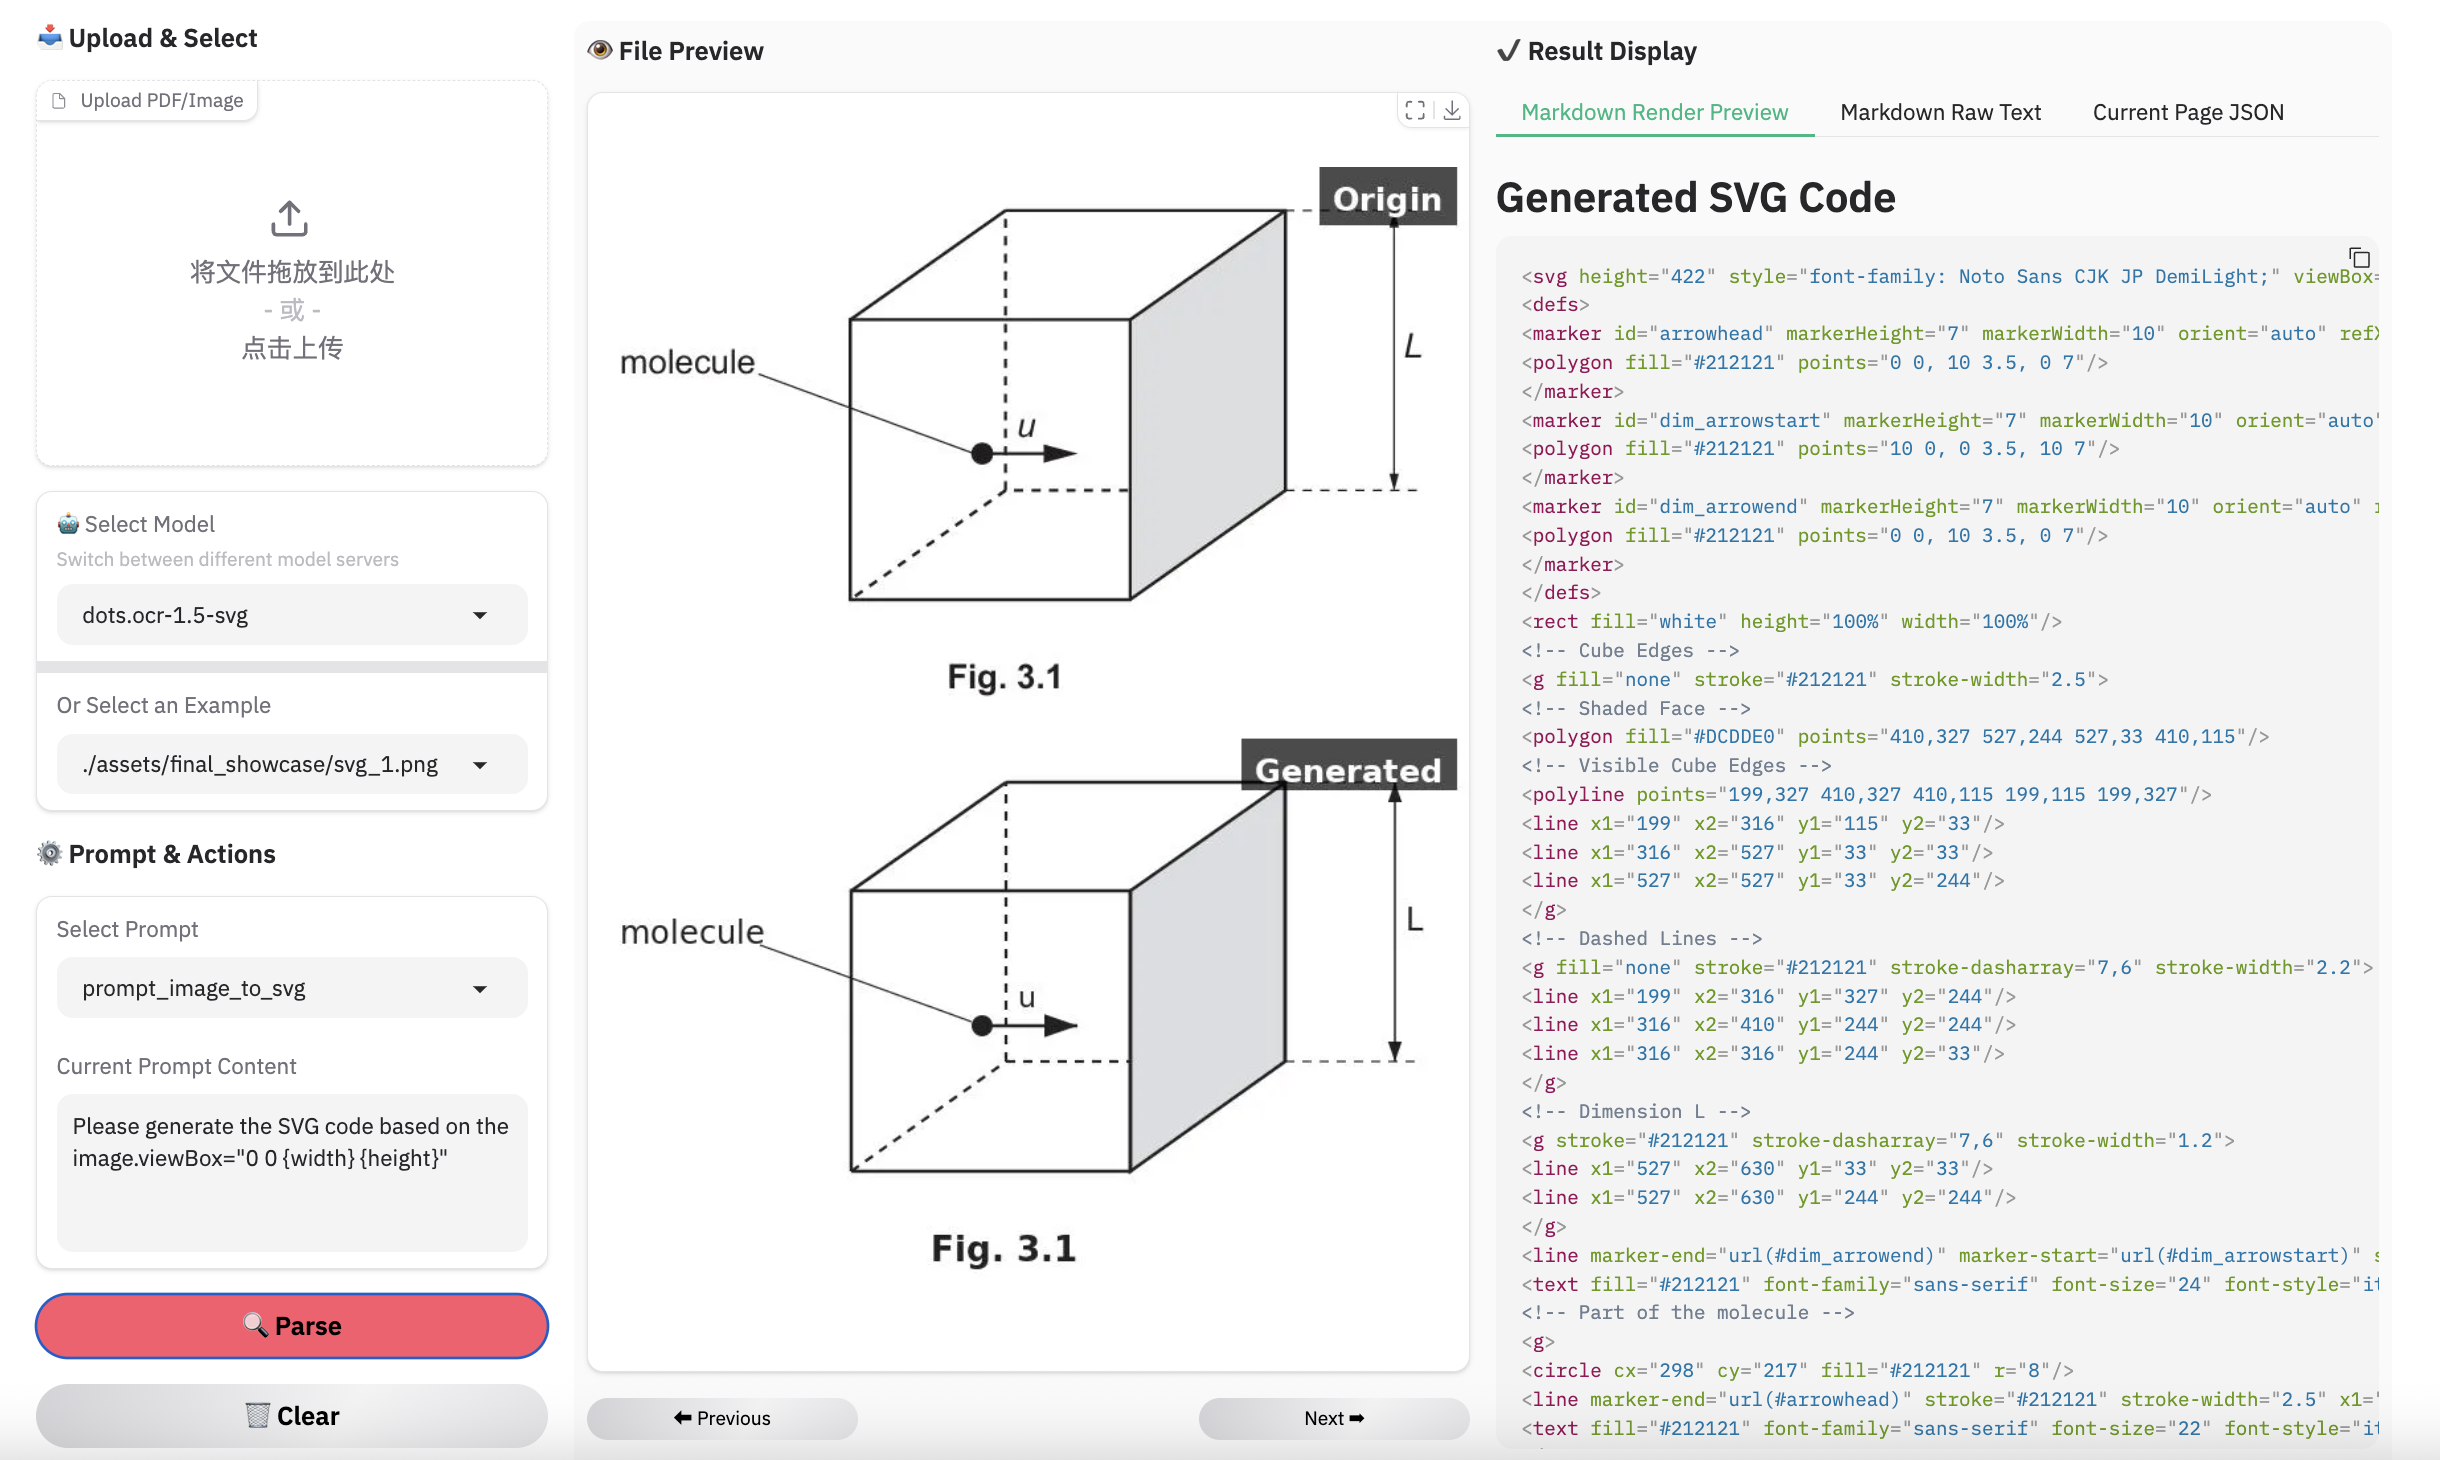
图源:项目官方示例。中间上方为原图、下方为生成预览,右侧显示SVG代码;界面仍用更名前的1.5-svg名称。本文未运行模型,也未下载该例SVG检查编辑行为。
图中的箭头、虚线、阴影面与文字需要一起表达。SVG出口因而有不同于文字提取的价值:后续程序可以处理图形代码,而非只保存一张截图。是否便于改字、改颜色或继续编辑,还要看实际生成文件的元素组织,不能凭一张渲染图保证。
官方用prompt_image_to_svg描述这一任务,并提供专用svg型号;普通文档解析命令不是自动替所有插图重画矢量图。复杂化学结构、细节很多的图形,也不能因为已有一个立方体例子就推定都能正确还原。
把阅读版本与定位版本一起留下
文档解析产物包括布局JSON、拼接文本生成的Markdown和带区域框的预览图。另有去掉页眉页脚的Markdown版本,用于相关评测;整理真实文档时,应先确定那些页脚是否含有自己需要的来源信息,再决定采用哪份。
本地流程需要相应Python、模型与推理服务。代码与当前模型卡标MIT,输入图形的使用权不由模型许可代替。作者也明确保留复杂表格、公式和图形鲁棒性的限制,不能把榜单表现当成每份材料都准确的承诺。
对带图资料,先问清要留下什么:可搜索的文字、可定位的区域,还是能继续处理的图形代码。把目标选对,比把所有任务都叫“识别这张图”更容易得到有用成果。
以上为编辑整理,功能、许可与使用条件以官方说明为准。