
Elicit 把论文检索和提取合进 Agent,表格仍能带着新增列导出
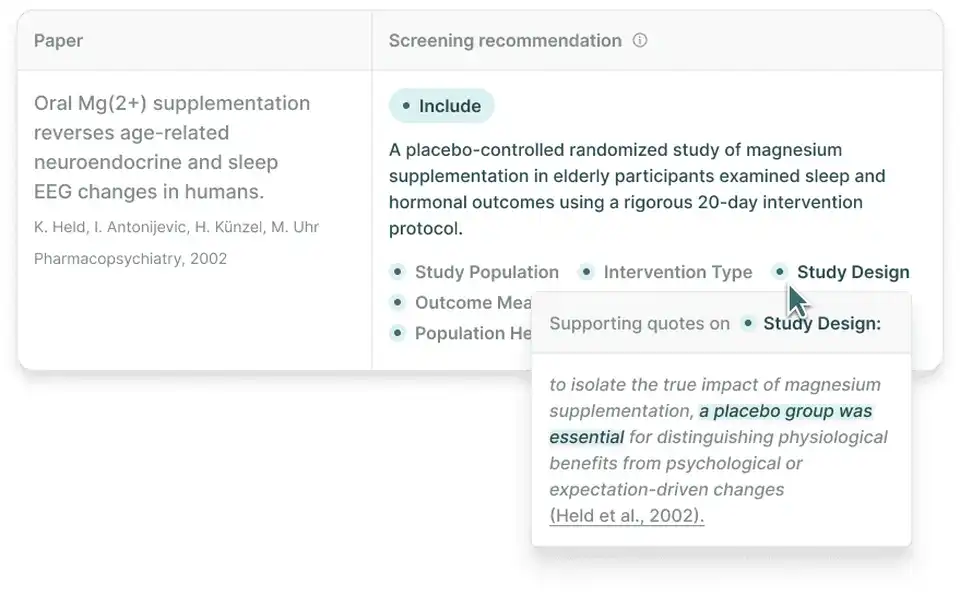
为什么值得关注
将检索论文与数据提取放在同一Research Agent会话中,表格可继续补列并导出。
适合谁:需要横向比较多篇论文并把结果交到表格或文献管理器的研究者
这次有哪些亮点
- Research Agent可继续旧论文集合和提取表上下文
- 按权益导出CSVExcel及文献RISBIB
使用前需要知道
旧独立会话已只读并计划在2027移除;图像数据提取与增强PDF解析有套餐差异,表格导出也有计划要求。
如果照着旧教程寻找Elicit的Extract Data独立入口,现在可能会找不到。官方在2026年9月30日将Find Papers、Extract Data和Chat with Papers整合进Research Agent:找论文与提取数据变成技能,之后可以在同一个会话里继续追问、补列或增加论文。
这个变化值得单独看,因为横向研究通常不会一次结束。官方迁移说明明确,代理生成的表可通过Add column补列,也可以直接告诉它需要哪些字段。
一组论文,不必每换任务就重新交代
以比较“大学生如何使用学习反馈”的研究为教学情境:先找一组相关论文,再要求按研究对象、方法、观察周期与主要发现整理表格。第一轮发现不同文章对“反馈”的定义不一致,下一轮就增加定义列,而不是把所有材料重新搬到另一个工具。
旧提取会话也可以逐个转入Agent:来源论文与提取表成为新会话上下文;旧聊天则作为背景记录,并非重新执行一遍。已有工作因此能继续使用,但不会在后台自动全部转换。
旧会话目前还能读和导出,无法新增或编辑。官方计划于2027年移除,具体日期尚未确定。因此,长期依赖旧会话的用户需要按官方入口迁移或导出,而不能把只读页面继续当作正常更新中的研究项目。
表格里的数字,可能来自正文之外
官方表格与图形提取说明指出,列答案会考虑论文中的表格,使用表格信息时会引用该表;但复杂格式仍可能提取失败。打开论文后可以查看系统读到了哪些表。
图表图片又是不同能力:需要增强PDF解析,并在系统综述设置中启用Extract from figures,当前限Scale与Enterprise。其他符合条件的套餐可以改善解析,却不能由此推断也能从图片中抽数据。增强解析默认关闭,开启后影响每份PDF的用量,不只影响当前难读的那一篇。
这会实际改变采用方式。正文中的样本数量、表格中的分组数据、曲线图中的变化值,不应被当成完全相同的输入。
交付文件时,列和出处都要接得上
官方导出说明列出,Plus及以上可导出Research Agent表格,包括新增列,格式为CSV或Excel;部分来源表可以导出RIS或BIB。报告的PDF、Word出口与表格导出则是不同规则。
把文献送到Zotero后,可以再按需要生成参考文献格式;把比较表送到Excel后,也能继续人工补列与核对。Elicit最有用的产物因此不只是一次“文献综述答案”,而是一组可以反复修订、再交到其他研究工具的材料。开始时先确定要比较哪几个字段,再让Agent的后续对话围绕表里真正缺的那一列继续。
以上为编辑整理,功能、许可与使用条件以官方说明为准。