
ESM3:给出蛋白质的一部分,让模型补出序列与结构
为什么值得关注
允许保留已知局部,并以多种蛋白质属性约束未知部分,让研究者从完整结构预测转向候选设计。
适合谁:关注 AI 科研、想读懂蛋白质设计流程的读者和生命科学学习者
这次有哪些亮点
- 联合建模序列、结构与功能条件
- 通过迭代补空生成序列与结构候选
- 公开小模型支持本地使用,当前入口由 Biohub 提供
使用前需要知道
候选结构不等于目标功能已成立;本地公开小模型与其他规模型号、平台服务范围须分开判断。
已经知道蛋白质中一段重要区域,想保留它,再为周围设计新的部分,这是比“预测这条序列长什么样”更进一步的问题。ESM3 接受不完整的序列、结构和功能条件,在这些信息之间补空,提出新的蛋白质候选。它让人看到,蛋白质模型的输入可以从完整答案的一端,移到设计约束的一端。
这篇适合对 AI 科研感兴趣、希望读懂蛋白质设计案例的人。ESM3 最初由 EvolutionaryScale 推出,当前官方入口已迁至 Biohub;ESM 仓库首页主要介绍 ESMC、ESMFold2 和 Atlas,阅读 ESM3 要进入专门文档,避免把同一家族的新模型能力混在一起。
“提示”是几条可以留空的信息轨道
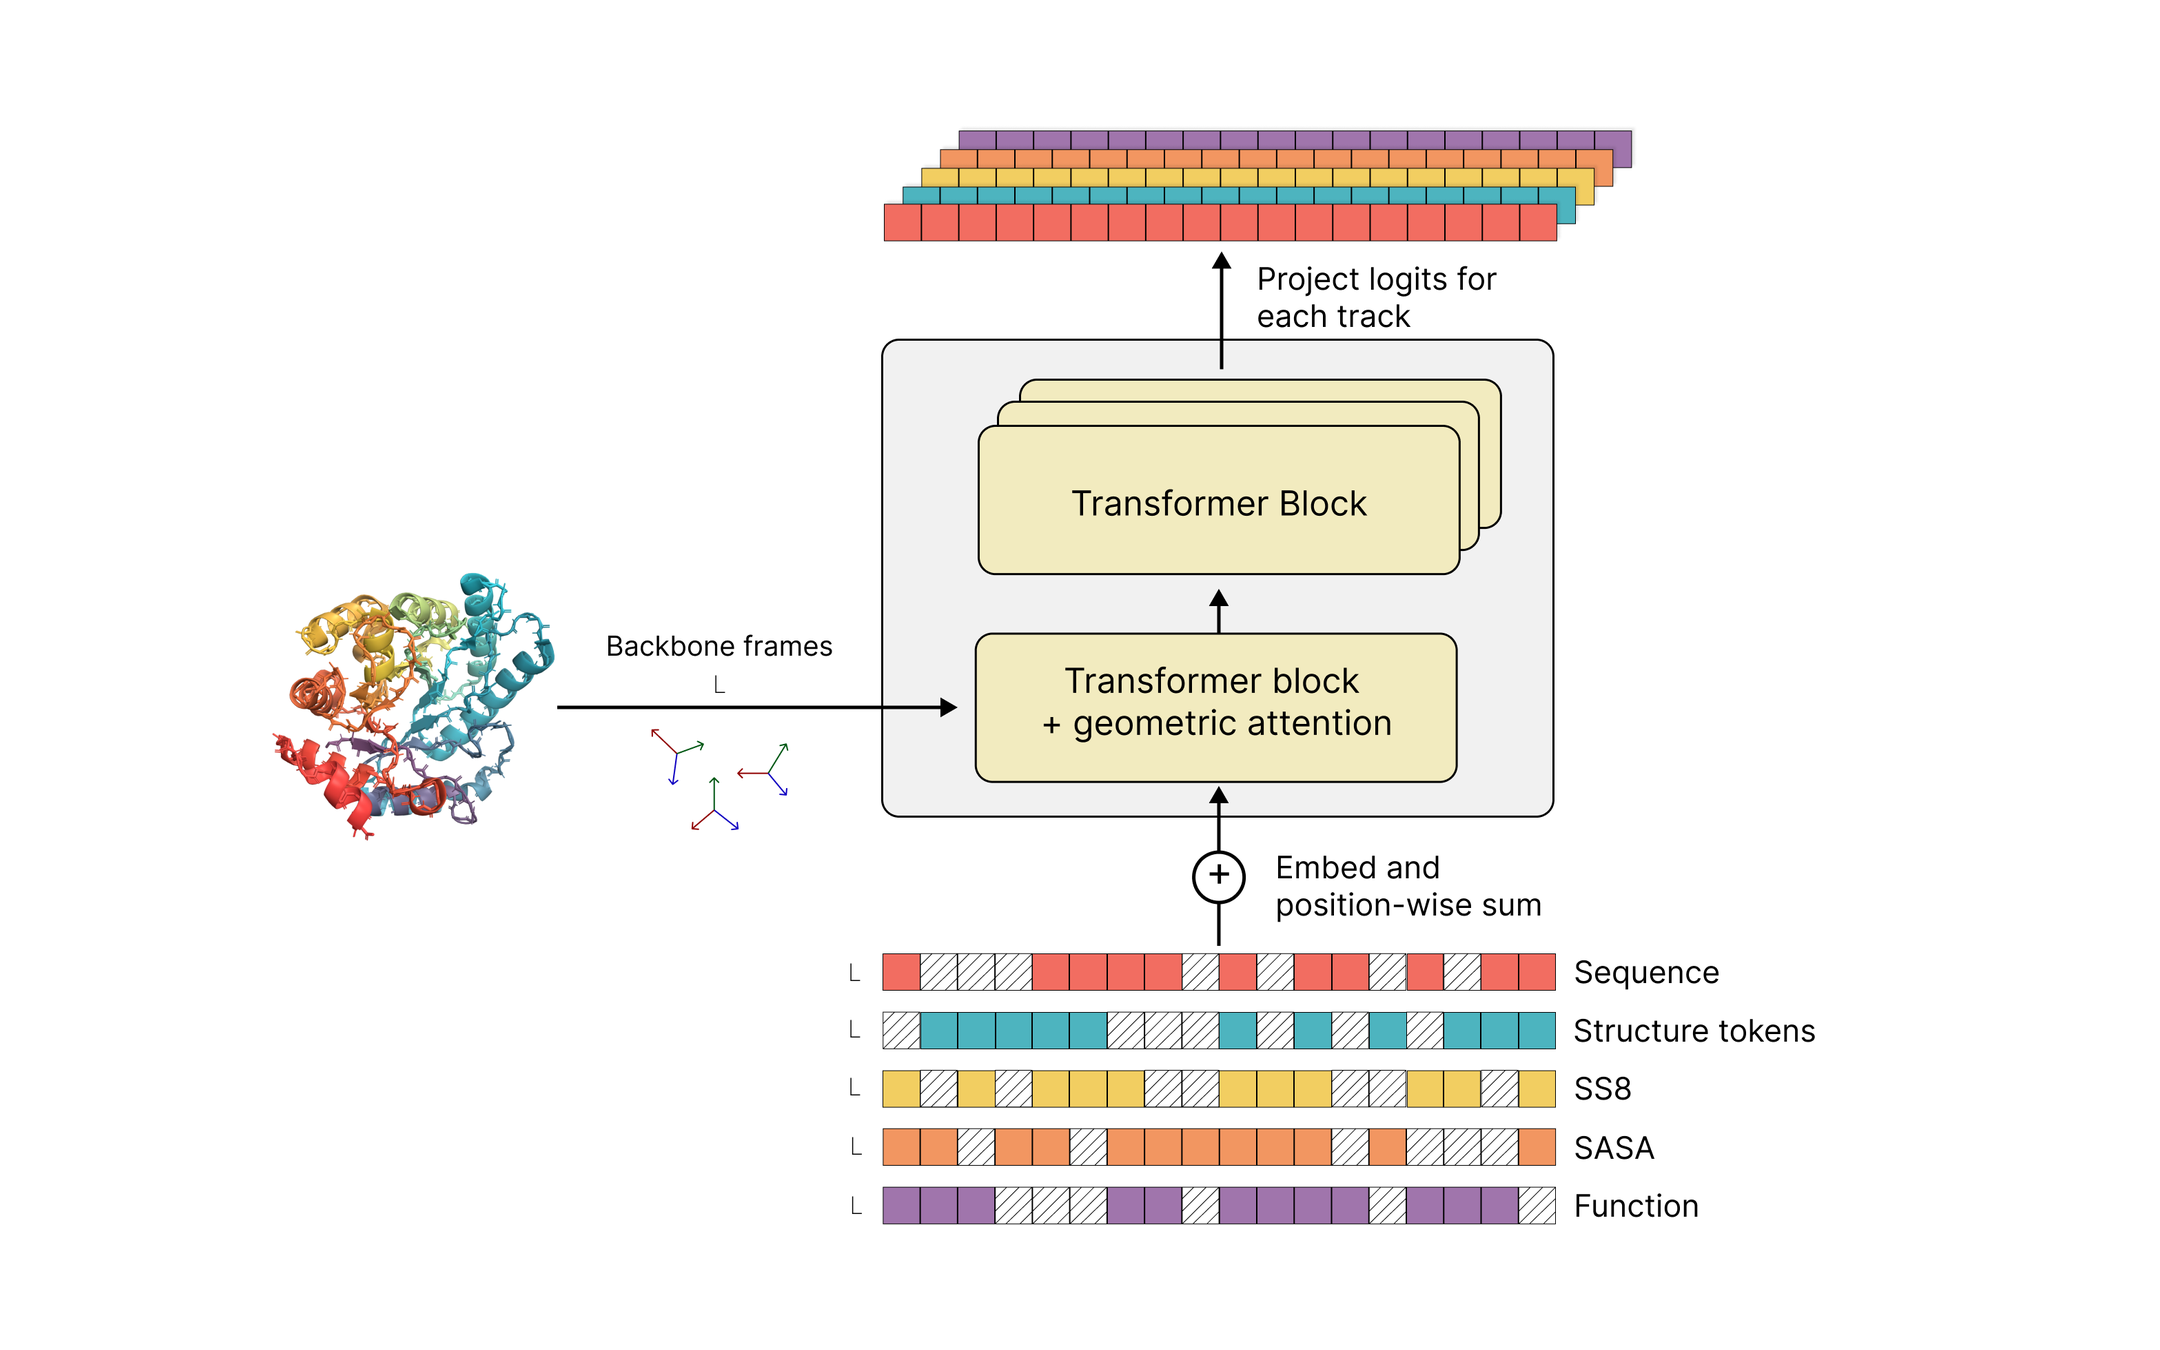
序列描述氨基酸的排列,结构描述它们在空间中的组织,功能信息则为设计提供生物学条件。ESM3 把这些信息表示成可被遮住、可被预测的符号。在生成时,模型逐步填入未知位置;输入中已经提供的信息,构成它补全其余部分时的条件。
因此,给它一个功能关键词,与对聊天机器人说“设计一种万能蛋白”有很大距离。功能条件要与序列、位置和结构等信息一起解释,输出依然是待检验的候选。官方早期介绍中的 PETase 例子就同时给出活性位点的结构与氨基酸,再加入水解酶相关功能条件,让模型提出周围的支架。这个例子展示条件怎样组合,并未证明生成物已经能处理现实中的塑料废物。原始发布说明还说明,部分训练结构与功能信息来自预测数据,不能把训练条目数全当成实验验证数。
官方模型示意。底部不同颜色的轨道分别承载序列、结构及其他属性,斜线格表示遮住的位置;模型在联合条件下预测各轨道。左侧结构信息也参与处理。来源:ESM3 专属文档。打开原图可查看细节。
顺着官方补全示例走一次
专属文档给出了碳酸酐酶的部分序列提示:中间保留一段已知氨基酸,两端用空位表示。第一步让模型补全序列轨道,得到一条完整候选;第二步为这条候选生成结构,再导出 PDB 文件,供结构查看软件继续使用。这是一条从残缺输入到可查看三维模型的连续路径,本文未运行该示例。
示例随后还有一次“往返”:清掉序列,只保留结构条件,重新生成序列;再清掉坐标,用新序列重新预测结构。这个安排值得记住,因为它让“符合某种形状的序列有哪些”与“这条序列会形成什么形状”进入同一套交互流程。输出是否足够接近、能否表达和具有目标活性,还要另行比较和实验确认。
从这段材料出发,我会把 ESM3 看作探索候选空间的工具:研究者能够保留确定的局部,把不确定部分交给模型提出可能方案。它真正改变的是提问方式和候选形成过程。单凭一份漂亮的 PDB 文件,尚不能跨过结构预测到功能成立之间的距离。
看清自己拿到的是哪个 ESM3
ESM3 是一个模型家族。专属文档分别列出大、中、小型号;论文中的最大型号与本地可下载的小模型需要分开看。公开权重 esm3-sm-open-v1 是本地起点,其他型号的获取方式以当前 Biohub 平台为准。不要把旗舰型号的研究结果,自动写成本地小模型能复现的表现。
当前小模型卡和专属文档将该模型及相关代码列为 MIT 许可,允许按条款开展商业使用;模型训练用过的数据及其他型号的服务条款应分别核对。旧介绍里的许可与平台名称可能已经变化,选用时应回到当前对应型号的页面。
如果只是想理解怎样组合条件,可以从Biohub 的 ESM3 页面进入生成与蛋白质对象教程;要实际生成,还需要本地计算环境和权重访问,或平台 API 权限。对普通 AI 读者,最值得带走的发现是:这里的“提示”不只是一句话,它可以是一块需要保留的分子结构,以及围绕它尚待填写的空间。
以上为编辑整理,功能、许可与使用条件以官方说明为准。