
Florence-2:先写图片说明,再把“汽车”和“建筑”落到具体区域
为什么值得关注
适合给图片库建立可检查描述与位置标注的开发者。
适合谁:图片库开发者、素材管理团队、视觉应用开发者
这次有哪些亮点
- 任务标记控制说明、检测、OCR和短语定位等输出
- 官方串联案例显示描述可以继续作为短语定位输入
使用前需要知道
官方保存样例不等于当前权重重跑保证,large卡已标继续预训练更新;描述可能增添未证实细节;中文OCR效果未在这组英文案例中验证
图片库只有文件名时,很难知道一张图里有哪些可用元素。Florence-2可以先生成整图说明,再把说明里的短语映射到具体区域,让“这张图有什么”与“它在哪里”连接起来。对素材管理或视觉工具开发,这比只得到一段无法定位的描述更有用。
官方notebook用一张青绿色甲壳虫汽车停在黄色建筑前的照片串起多项任务。<CAPTION>给出简短说明;之后把这句话交给<CAPTION_TO_PHRASE_GROUNDING>,返回汽车与黄色建筑两组框和对应标签。两步共享同一张图,文本不只是最终答案,也能成为下一步的输入。
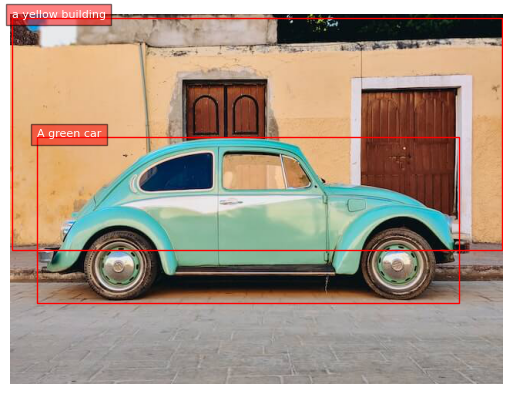
微软官方notebook保存结果,汽车与建筑分别对应框和文字。这里展示官方已有运行,不是当前环境重跑。
先选任务,才能知道会收到什么
模型卡使用特殊任务标记控制输出。整图说明是一段文字;<OD>返回对象框与标签,示例里包括car、door和wheel;<DENSE_REGION_CAPTION>给区域更详细的描述,例如青绿色甲壳虫或木制双门。它们服务的编辑界面也不同:整图说明可帮助检索,区域描述可以挂在可点击的对象框上。
若已有一段想定位的短语,就用短语定位任务;若要识别图中文字,<OCR_WITH_REGION>提供四边形坐标与文字。后处理时要提供原图宽高,才能把模型序列转换成图像上的坐标。框、四边形与分割多边形不是同一种格式,接到标注或裁图工具时应保留任务类型。
描述更长,不代表信息更可靠
官方汽车例子本身就能帮助判断这一点。简短说明称green car,详细说明称blue Volkswagen Beetle,更长的说明还增加了车门、建筑状况等细节。读者不应因为段落变长就把每个描述都当成事实。对于素材检索,短描述可能已经够用;用于公开图注或产品信息时,车型、颜色与细节仍应人工核对。
同理,这份notebook的OCR演示是英文书封,不能用来证明中文票据、中文海报或复杂表格的效果。若任务需要中文,应另准备有标注的实际样本,比较文字与位置;任务列表里有OCR入口,只说明模型提供这种能力类型。
模型名还需要跟着具体版本走
Florence-2有base、large及各自的-ft版本,规模和训练设置不同。尤其本次核验时,large模型卡开头已标明它是继续预训练、4k上下文的版本,并提醒继续训练数据较少,可能训练不足;旧notebook保存输出和旧评测不能直接当作这一权重的复现结果。开发时应固定仓库修订和权重,并留存处理器版本。
模型卡与许可标注MIT,示例采用可执行远端模型代码的加载方式,实际接入需审查所固定的代码。对图片库来说,最可交付的中间成果是“原图+任务标记+文字或区域坐标”,使检索结果既有描述,也有能回到画面核对的位置。
以上为编辑整理,功能、许可与使用条件以官方说明为准。