
Grounding DINO:用文字找照片里的对象,先得到可核对的框
为什么值得关注
适合给素材筛选、标注和局部编辑寻找目标位置的开发者。
适合谁:视觉应用开发者、数据标注团队、设计工具开发者
这次有哪些亮点
- 图片与文字共同输入,输出框及词语相似度
- 对象框可交给后续分割器,DINO本身不等于精细抠图
使用前需要知道
本篇介绍原仓库公开权重,不混入1.5商业API能力;阈值和提示词影响结果,模型相似度不是事实证明
想在照片里找到椅子、狗或一件特定外观的物体,传统检测器通常要求预先约定类别。Grounding DINO把文字也作为输入,让程序按短语寻找图中对应位置。它适合接在素材筛选、对象标注或局部编辑前面,先解决“应该处理哪里”。
官方README用“两只狗和一根木棍”的图文对照解释输出。模型产生一组候选框,每个框对输入词语有相似度:两只狗附近的候选与dogs更相关,木棍附近的候选与stick更相关。示意中的数字用于讲解关系,不能当作本文测出的置信度或识别准确率。
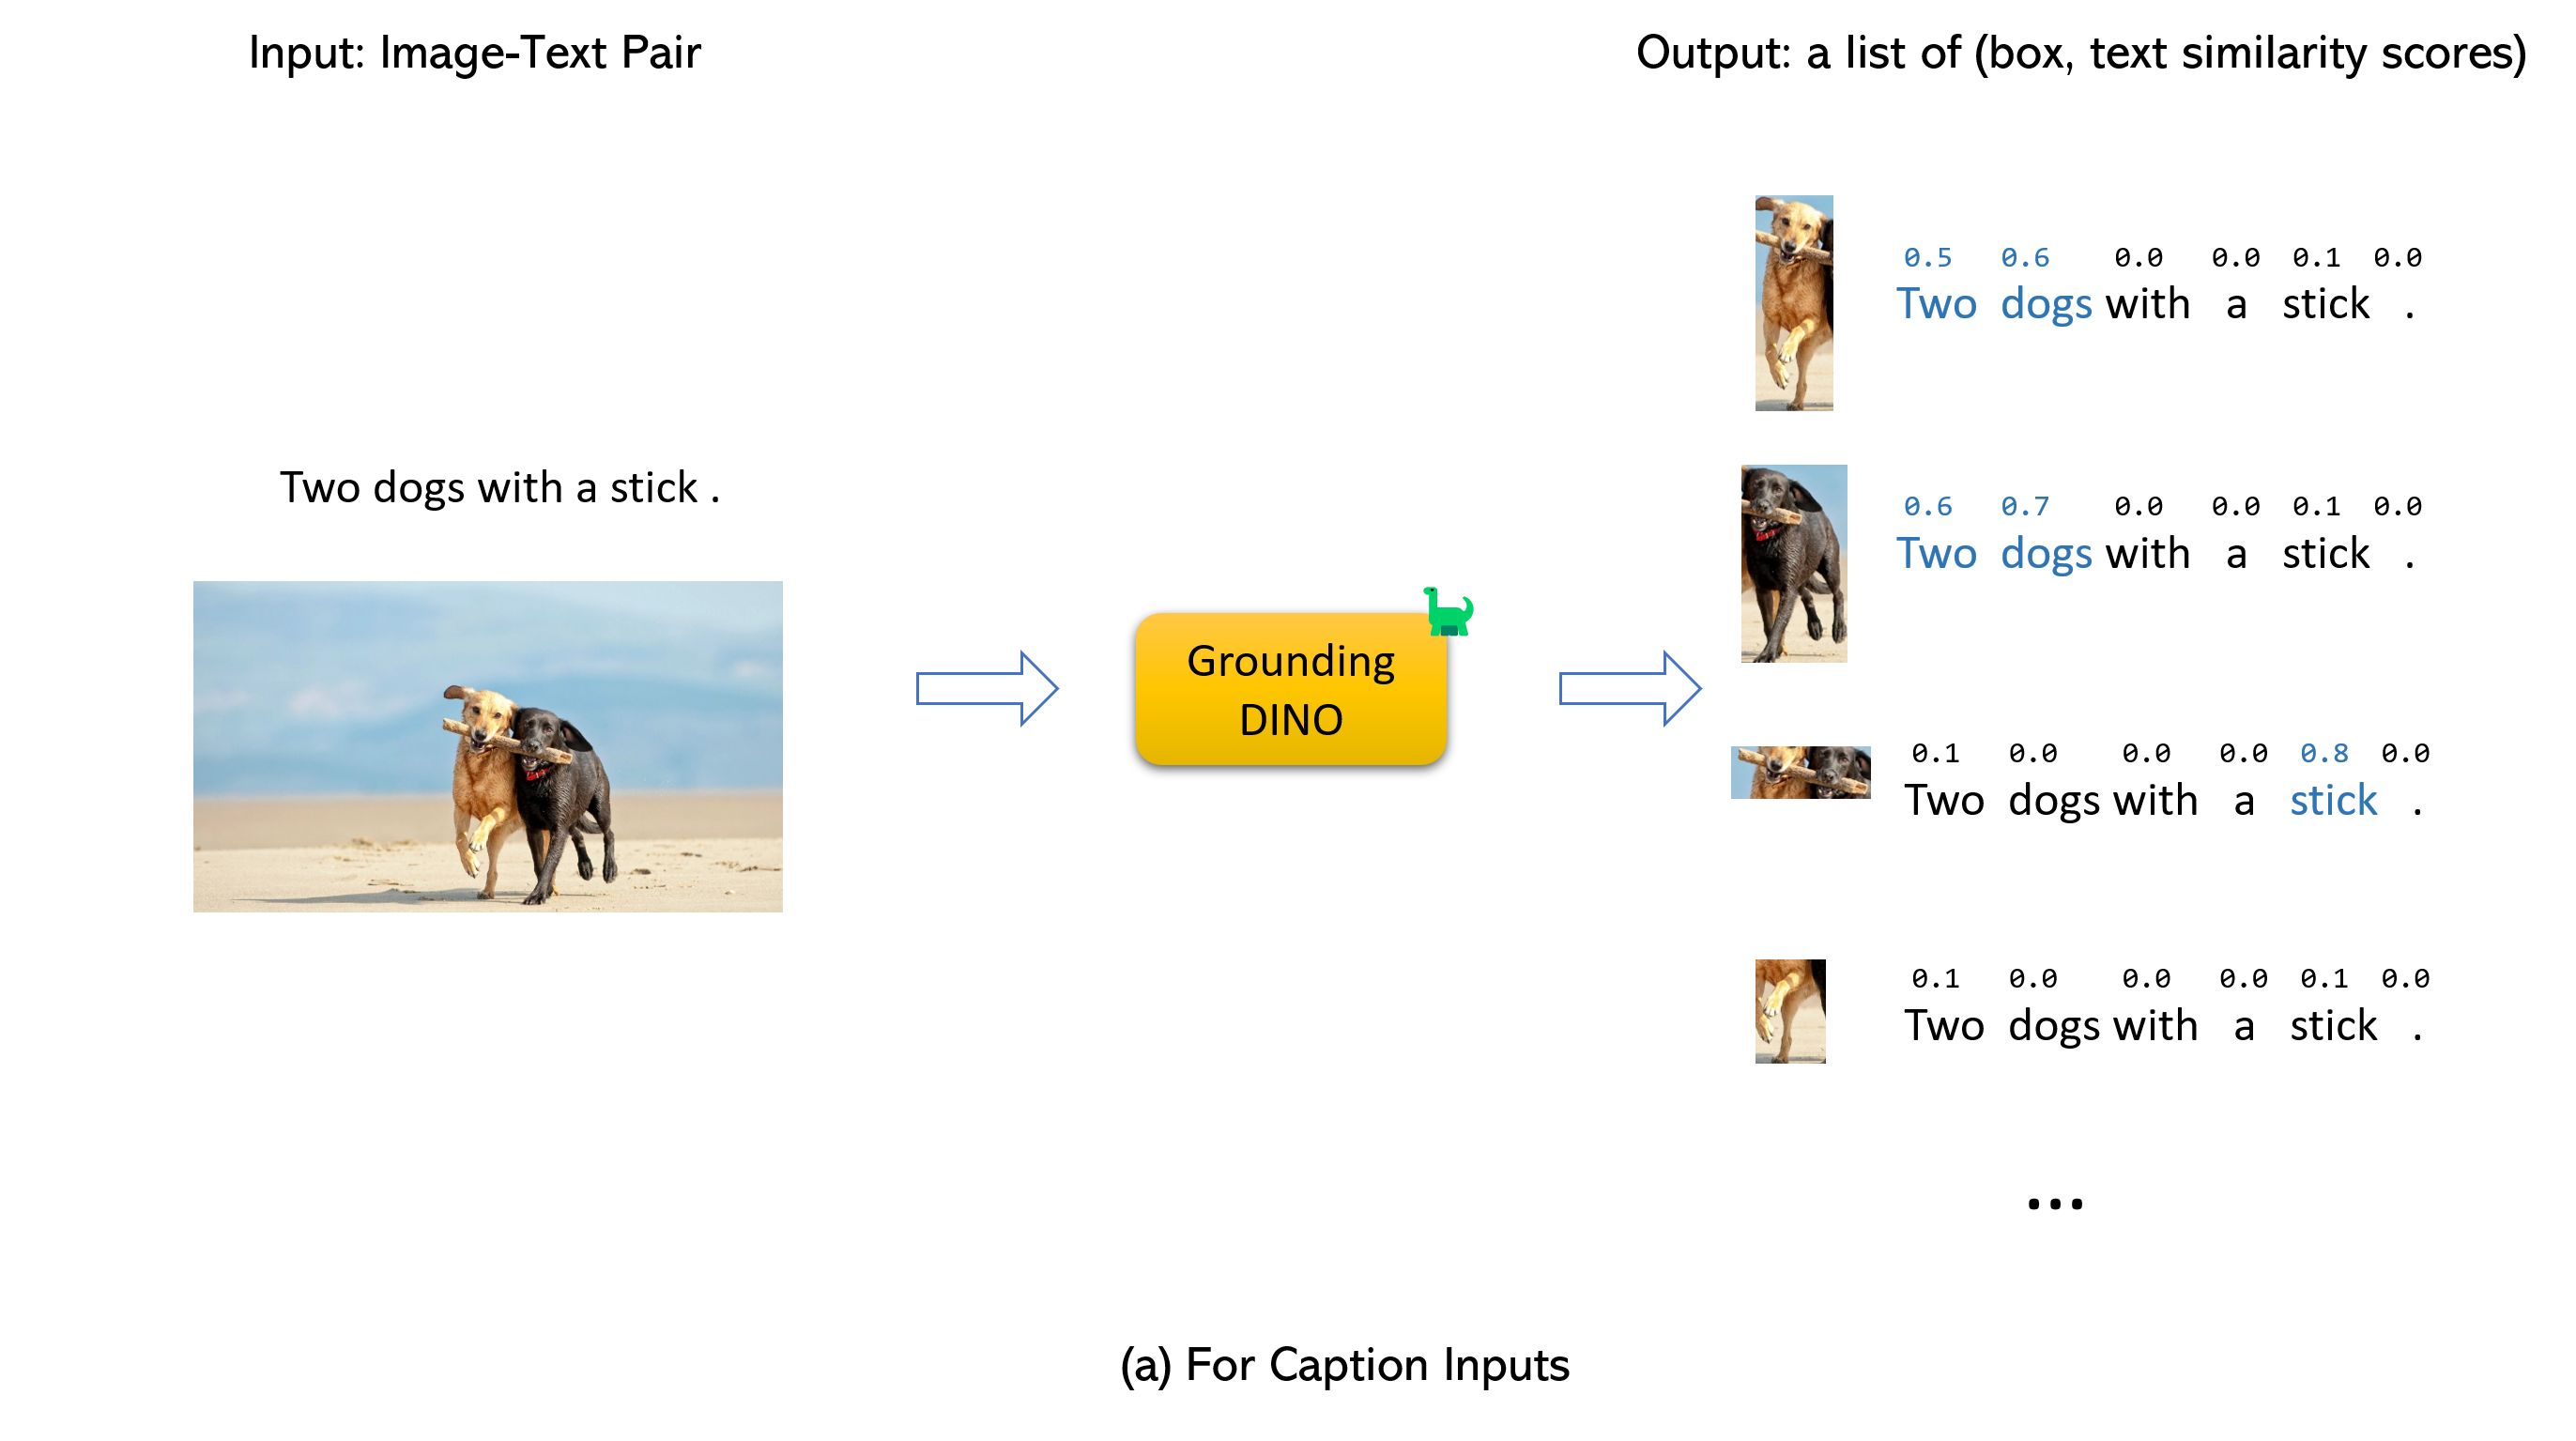
IDEA官方输入输出解释图。右侧展示候选区域与各词的相似度,并非分割后的透明图层。
两个阈值管的是不同事情
仓库说明,默认会产生900个候选框,再按box_threshold筛选;text_threshold决定哪些词被选为预测标签。若筛掉太多,可能漏目标;放得过低,又可能保留无关框。它们调整的是筛选规则,不能把一个较高数字直接解释为某个对象真实存在的业务保证。
多类别提示建议用句点分开,例如官方Python例子的chair . person . dog .。若在完整句子中只关心某个短语,还可以指定文字跨度。官方另给猫和狗的句子,用token_spans明确“A cat”和“A dog”的范围。这比把所有词挤成一个含糊类别更容易看懂标签来自哪里;文本分词也意味着词数不必等于token数。
检测框能接着做什么
官方推理脚本保存原图和带框的pred.jpg,帮助你把结果叠回原画面核对。开发者也能保留框坐标与短语,作为裁切候选、人工确认入口,或交给后续分割模型。示例画框函数里产生的是矩形范围,并不是沿毛发或物体轮廓的透明蒙版。
仓库确实展示与SAM、Stable Diffusion、GLIGEN的组合,但抠图、补景和生成属于组合里的其他环节。若要把“找到一只狗”变成“只改狗的颜色”,还需要从检测框得到合适遮罩,再进入编辑器。把这些步骤分清,才知道误差发生在找目标、分边缘,还是生成修改上。
本篇针对原GroundingDINO公开仓库及Swin-T等检查点。README同时链接Grounding DINO1.5 API,那是另一入口,不能把商业API能力套到本地权重。原代码采用Apache 2.0;仓库支持CPU-only,也提供CUDA安装方式,选用权重、依赖和运行硬件仍需匹配,CPU可运行不等于互动速度已经足够。
对创作工具,比较实用的第一版成果是能回到原图查看的候选框列表。先让人确认哪些对象值得处理,再接入分割和生成,比只留下一个类别名称更能支撑后续编辑。
以上为编辑整理,功能、许可与使用条件以官方说明为准。