
LangExtract:抽出文档字段,还能回到原句核对
为什么值得关注
结构化结果保留原文位置,并能生成交互式核对页面,适合整理大量文本时保留可追溯出处。
适合谁:需要从文本批量整理人物、关系等资料,并回看依据的内容研究与数据处理团队
这次有哪些亮点
- 规则和少量标注样例定义抽取目标及属性
- 抽取结果可对齐原文字符区间,并生成高亮 HTML 页面
- 长文可分块并行与多轮抽取,保存 JSONL 供后续处理
使用前需要知道
无字符区间的结果不能视为已定位;定位到原句不证明推断属性正确。实际质量取决于模型、样例与任务,中文效果未验证;Apache-2.0 代码与模型、输入文档条件分开确认。
把一部小说整理成人物、情绪和关系资料,难处不只是让 AI 列出一张表。人物是谁、情绪从哪句话判断、关系是不是模型自行补充,都得能回到文本中检查。LangExtract 是一个用大模型抽取结构化信息的 Python 库,它把抽取结果与原文位置对应起来,并提供交互式高亮页面,方便逐条看依据。
它适合需要批量整理材料、又不能丢掉出处的内容研究和数据处理团队。值得关注的成果,是一组可以继续处理的结构化记录,以及帮助人工核对的原文视图;它本身不是开箱即用的文档办公软件。来源:LangExtract 官方说明
把“摘出来的词”和“对它的解释”分开
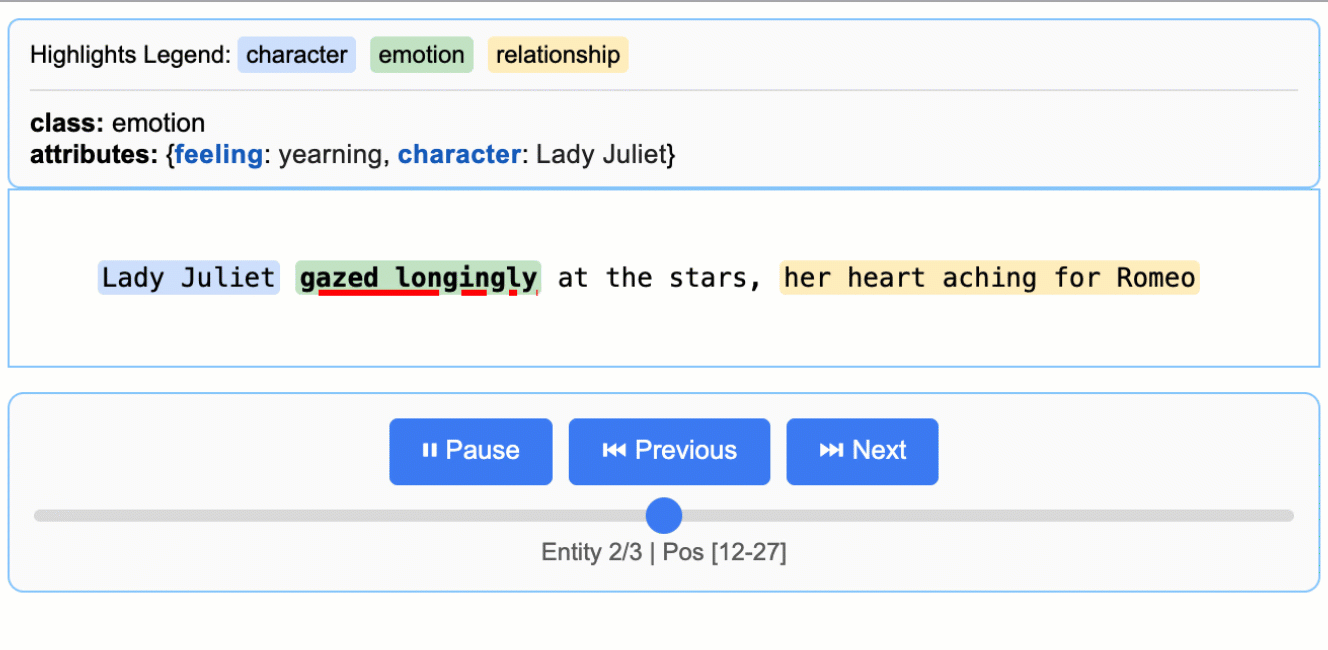
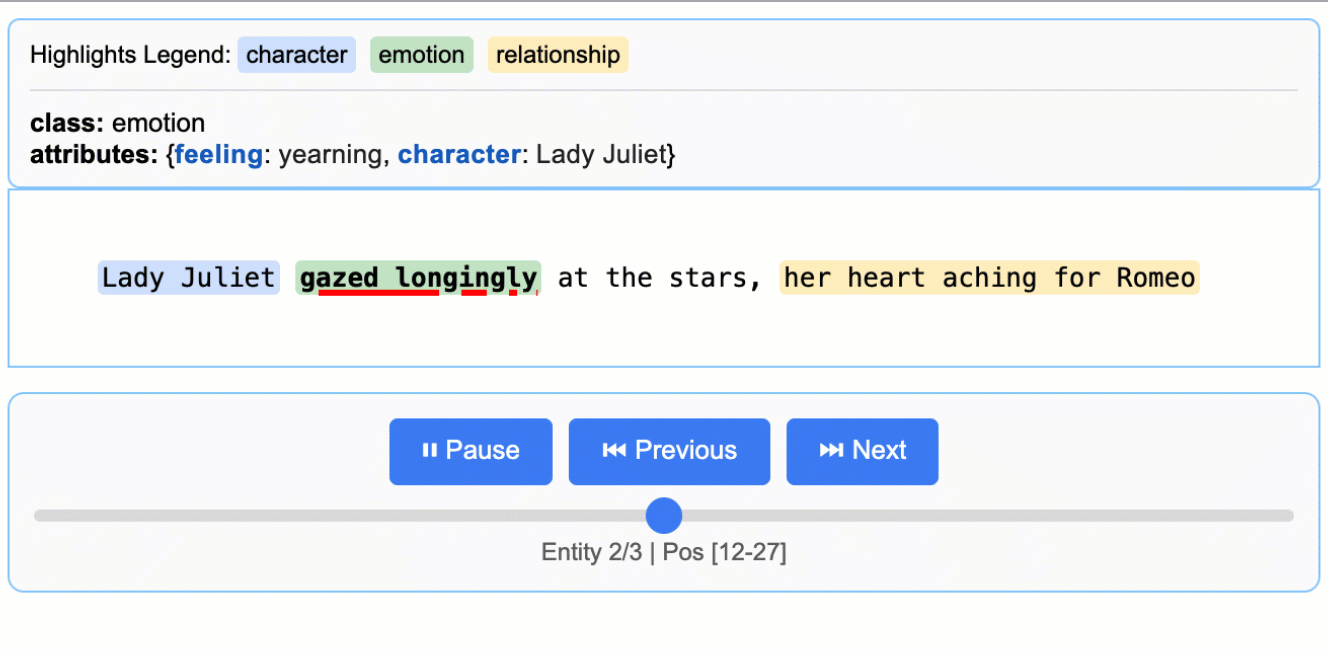
官方入门示例先提供规则和标注样本,要求按出现顺序抽取人物、情绪与关系,摘录文字应与原文一致。随后输入一句描写朱丽叶望着星空、思念罗密欧的英文文本。模型依据示例抽取片段,库再把结果对齐到输入中的字符位置,最后可保存为 JSONL,并生成 HTML 核对页面。
下面是官方动画的一帧。蓝色标出人物,绿色标出带有渴望意味的凝望,黄色标出与罗密欧有关的关系片段;当前选中的是情绪,顶部显示它的类别和解释属性,底部显示对应的字符区间。它是英文官方演示,没有展示中文抽取效果。
官方演示动画第 18 帧静态提取,未改写画面;来源为上述项目说明。打开原图。
这张图最值得看的,是绿色原句与上方“渴望”属性之间的区别:原句是可定位的文字,情绪标签是模型对这段文字的解释。找到原句,能帮助判断解释是否合理,却不能自动证明解释正确。 同理,如果提示要求补充人物家族、文学身份等背景,属性可能来自模型知识,而非这句话本身。官方也明确区分了贴近文本的抽取和借助外部知识的推断。
还有一种更直接的失败:模型可能把示例里的词当成输入内容。当前文档说明,无法在输入中定位的抽取会没有字符区间。因此,结果中“有一条记录”和“这条记录能回到输入原文”需要分别检查,不能把所有生成字段直接当成有出处的数据。
长文抽取,靠分块与多轮补漏
官方还给了《罗密欧与朱丽叶》全文示例。输入是完整文本,处理时按较小文本块并行抽取,再用相同规则进行多轮独立抽取,合并不重叠的结果。遇到位置重叠的实体,文档描述的是优先保留首轮结果,再补入后续轮次发现的独有片段。来源:官方全文抽取示例
这解释了它为什么不只是“把整本书扔进一个提示词”。分块让每次调用面对较小材料,多轮则增加发现遗漏片段的机会,但也会带来额外模型调用。首轮优先的合并办法更不等于多个模型投票纠错。文档里的实体数量是该示例报告的产物,不能用来证明所有作品的识别准确率。
对真正要做人物资料的人,接下来值得看的,是同一个名字的多种写法是否要合并、比喻是否应该算关系、情绪标签是否过度推断。LangExtract 提供了逐条核对的入口;最终采用什么标注标准,仍由任务决定。
先定好样例,才谈批量整理
开始使用前,需要写清抽取类别,并给出能代表任务的样例。样例里的摘录应该来自对应原文,否则模型会学到错误的输出习惯。输出的 JSONL 适合后续统计,HTML 适合回看文本,两者解决的是不同环节。
代码采用 Apache-2.0 许可;所接模型与输入文档的使用条件仍需分别确认。它支持云端模型,也能通过 Ollama 接本地模型,实际质量取决于模型、任务与样例。项目注明它并非 Google 正式支持的产品。来源:代码许可
如果你需要的只是读懂一篇文章,直接对话可能已经够用;如果要把一批材料变成能统计、能追问出处的资料,LangExtract 的吸引力就在这个可回看的抽取过程。中文任务也应先拿自己的短材料核对结果,再决定是否扩大规模。
以上为编辑整理,功能、许可与使用条件以官方说明为准。