
LightRAG:同一份资料,既能问具体细节,也能追整体关系
为什么值得关注
同一批资料既有细节追问也有跨文档归纳;真实小样本把实体种子、关联关系、召回片段和回答接起来,让开发者据实际缺失选择检索模式。
适合谁:准备搭建知识检索、需要检查细节问答与跨文档归纳依据的开发者。
这次有哪些亮点
- 三份自拟中文访谈实际抽出22个实体、32条关系
- 归纳题local仅召回一份,global与hybrid召回三份,保留环节与建议边界
- 提供输入、检索来源及六次查询原始回答,图为实际结果局部重绘
使用前需要知道
仅三片段、每题每模式一次,非中文质量或性能排名;关键词由模型生成,CLI适配器不是原生HTTP接口。构图错误需回到索引修正,默认存储仅适合小规模测试;未做naive/mix基线。
同问“三份访谈反映了哪些退款问题”,LightRAG 的 local 只取回一份,global 则找齐三份,并把入口难找、交接通知慢、进度不透明分开回答。这是本次中文小样本实际运行的结果。对准备做知识检索的开发者,有价值的是看清差异怎样发生:从哪些实体或关系出发,最后拿到了哪些原文。
LightRAG 由 HKUDS 维护,建库时用模型抽取实体与关系,保留原文片段,查询时将这些材料交给模型作答。下面沿三份自拟访谈,把输入、图谱和两类问题接起来看。
输入:三个人谈的是不同环节
样本中的商城、人物与访谈均为作者自拟,不是真实调研。三个文件分别导入,每份在本次运行中形成一个片段。以下为原文关键段落,完整输入见文末记录。
A,林岚,客服组:
顾客陈禾说,订单页只有“联系商家”,找不到“申请退款”。林岚建议给订单页增加独立退款入口,由产品组负责改版。这份访谈没有讨论到账时限。
B,周宁,仓储组:
青禾商城的退款流程要求仓储组先确认退货入库,再由财务组审核退款。周宁说,两组用表格交接,曾有退货已经入库但财务组两天后才收到通知。周宁建议入库后自动通知财务组;没有建议取消审核。
C,许澄,财务组:
青禾商城的退款流程在财务组审核通过后,由支付平台原路退回。许澄说,到账还要一至三个工作日,顾客却看不到审核状态与预计到账时间。许澄建议在订单页显示退款进度,由产品组与财务组共同确认状态文案。许澄没有提出缩短支付平台到账时间。
本次最终图谱有 22 个实体、32 条关系。B 被抽出了“周宁”“仓储组”“财务组”“退款审核”等实体;“仓储组—财务组”的关系描述保留了表格交接及两天通知延迟。“周宁—退款审核”这条边的关键词是“未建议取消”,没有把否定变成取消审核的建议。
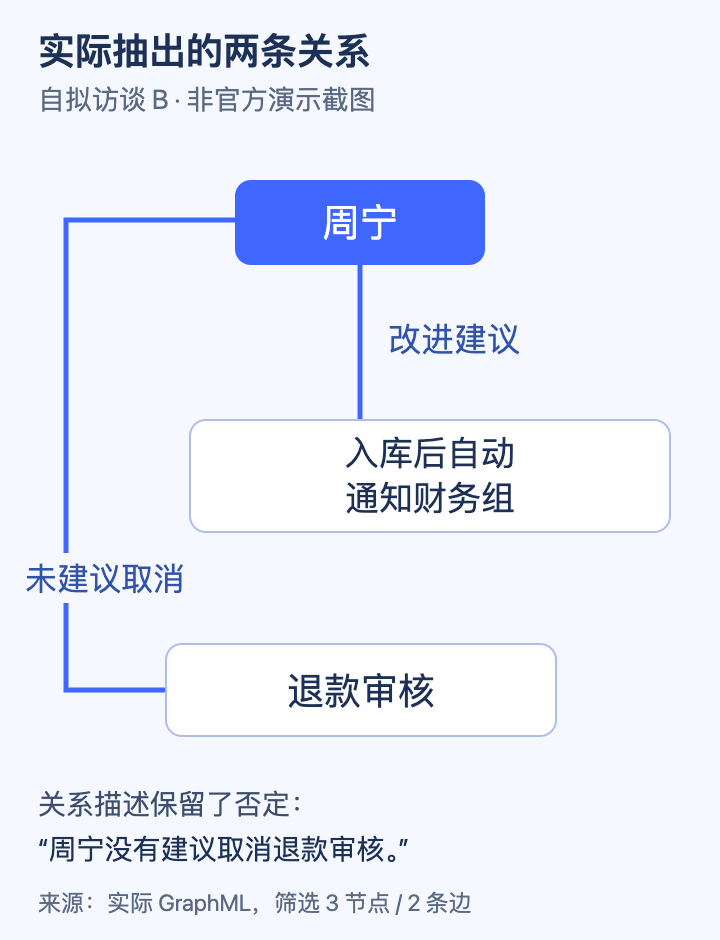
据本次 GraphML 筛选三个节点、两条关系后编辑重绘,非官方界面截图;线不额外表示方向。原尺寸 PNG · 矢量原图。
细节问题:先看它有没有保住限定
第一问是:“周宁指出退款流程在哪一步卡住?他建议怎样改,是否要取消审核?”
local 的两个候选实体实际是“退款审核”和“退款流程”,随后扩展出 11 条关联关系,带回 A、B、C 三个片段。回答准确落到 B:卡在入库后的通知交接,建议自动通知财务组,“没有建议取消退款审核”,并引用 02-周宁.txt。
global 这次取到四个实体、两条关系,也带回三份原文,回答同样保住了限定。这里没有显示哪种模式回答更好;更值得记住的是,local 并不保证范围窄。命中一个连接很多材料的流程实体,也会把多份原文带回来。
归纳问题:缺材料与答不好要分开
第二问是:“这三份访谈反映退款流程的哪些共同问题?应由哪些部门分别改进,哪些环节不能混为一谈?”
这次 local 以“三份访谈、退款流程”为低层关键词,却命中了“许澄”“退款进度”,最终只有 C:两个实体、四条关系、一个片段。回答开头明确说,现有材料只包含许澄的一份访谈,不足以判断三份的共同问题。它没有完成归纳,但失败位置可见:送给回答模型的依据已经缺了 A、B。
global 使用“退款流程共同问题、部门改进分工、流程环节区分”等高层关键词,命中“财务组—退款流程”“退款审核—退款流程”两条关系,经关联实体取回 A、C、B。回答分别列出三人的问题与建议,并保留一个有用的空白:“材料未明确改造责任部门”,没有擅自替周宁指定自动通知的开发负责人。
它最后区分了退款入口、入库通知、财务审核、支付到账和进度展示;没有把通知延迟说成支付平台到账慢,也没有把显示进度改写为缩短到账时间。hybrid 合并两路后也取回三份,完成了相同方向的区分。
因此,这次归纳题我会选 global 或 hybrid 继续检查;细节题用 local 已能回答。依据是本次召回材料与答案,而不是“global 天生更聪明”。
模式选择解决不了所有问题
当前代码中,local 从实体向量库出发扩展关联边,global 从关系向量库出发带回端点,hybrid 合并两路。global 仍是有限检索,不代表通读全库;local 也不表示模型部署在本机。
本次在隔离环境运行 main 提交 aaebfe1,包内版本 1.5.8;用既有 Codex CLI 默认模型承担抽取与生成,用 Xenova 转换的 BGE 小型中文 v1.5 量化 ONNX 在 CPU 上真实生成向量,模型及配置下载约 24.6 MB。查询统一设 top_k=2、片段上限 3,关闭重排,每题每模式只跑一次;关键词自然生成,未人工指定。输入、六次检索及回答原始记录可逐项核对。
这三段短文只能演示检索路径。local 的归纳回答还自行给许澄加了原文没有的“她”,说明有引用仍需审读。构图错误也不会因换模式消失。正式采用还要评估索引成本与存储:官方默认存储以内存为主、本地文件持久化,定位于小规模测试;换向量模型需重新生成向量。代码为 MIT,模型与资料许可另核。本次未做 naive/mix 基线或性能排名。
以上为编辑整理,功能、许可与使用条件以官方说明为准。