
LlamaParse 解析完一份 PDF,可以分别拿走 Markdown、元素树和图片
为什么值得关注
让复杂PDF成为可阅读Markdown与可编程元素,同时保留页级对应关系。
适合谁:既要把文档交给模型,也要单独取表格图片的研究工具开发者与资料运营
这次有哪些亮点
- 网页可并排看PDF和解析结果,API按expand选择内容
- 同任务可后取其他表示,items与Markdown按page_number对应
使用前需要知道
商业云端解析服务需账号密钥与额度;旧llama_parse仓库已弃用不代表服务关闭;下载链接会过期,结果可能含失败页,输出需要对应源PDF复核。
一份PDF解析以后,写作工具想要Markdown,表格处理程序想要结构,人工复核还需要看原页。LlamaParse把这些成果分开返回:同一个解析任务,可以按需要读取逐页文字、Markdown、标题表格等元素树,以及保存过的图片。
当前完整入门指南同时提供网页与接口路径。普通读者可先在网页选解析档位、上传文件或选择官方样例,运行后并排查看原PDF与结果,不必先写程序。
从双栏论文,看输出保留了什么
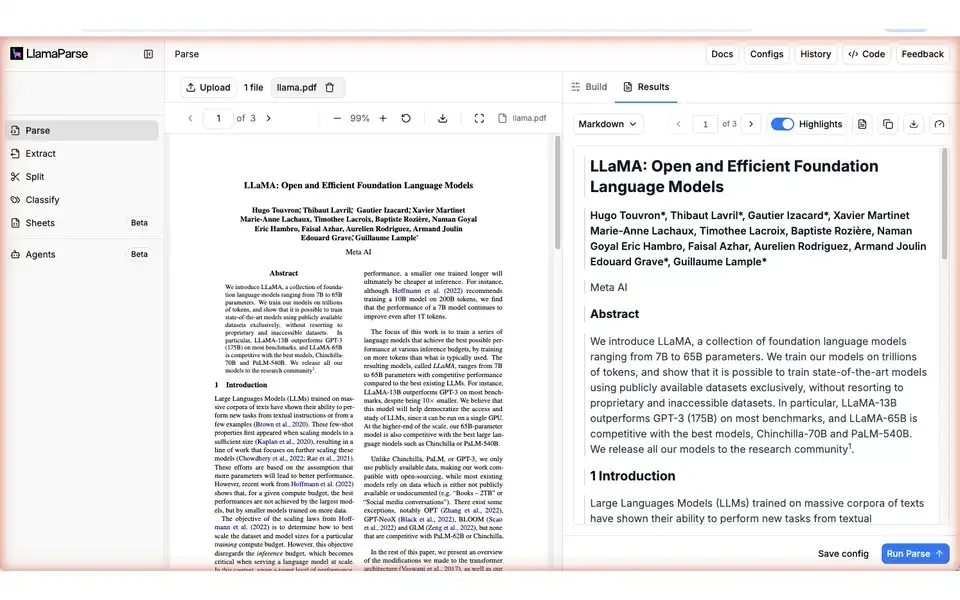
官方指南展示了一份LLaMA论文:左侧是原PDF,右侧为解析后的Markdown,依次呈现标题、作者、摘要与正文。这个样例能直观说明,得到的不是一张页面截图,而是可以继续交给笔记或模型处理的文字结构。
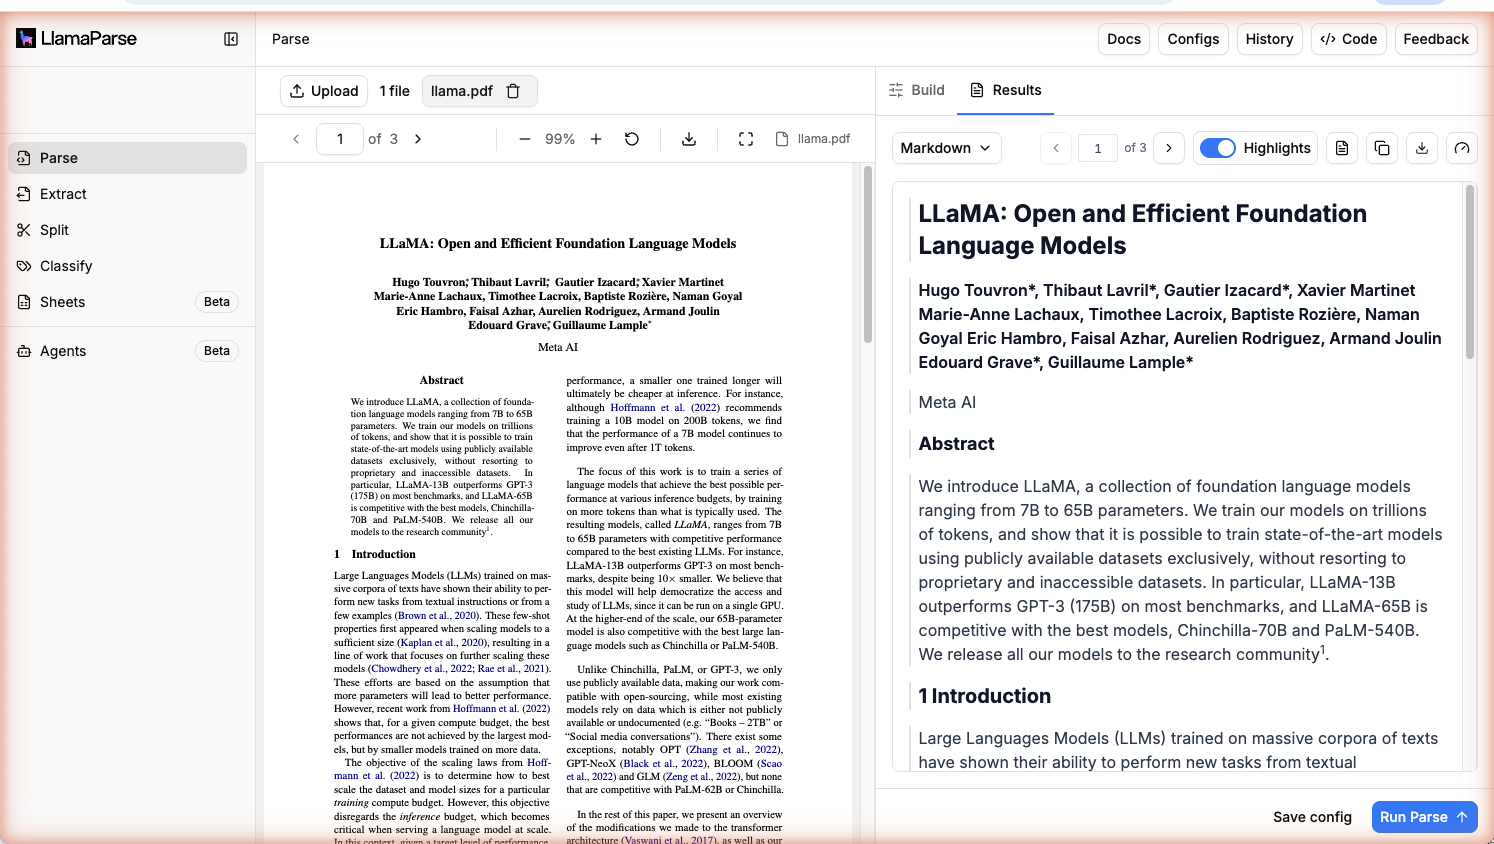
官方入门指南样例:左侧是 LLaMA 论文,右侧依次呈现标题、作者、摘要与正文;这是项目方展示的解析结果。
对需要准备论文资料库的人,可以先观察这一层是否够用:摘要与正文顺序是否对应,表格是不是被当成一组有关系的数据。样例展示的是项目方输出,不能由此推成任何复杂PDF都会得到同样质量。
如果还要单独处理表格,接口可以请求items元素树,其中区分标题、表格、图等对象。已经有可阅读Markdown,也不意味着程序获得了全部结构;要按最后需要的成果选择相应表示。
结果不是只有一种拿法
完整结果读取指南把expand作为关键参数。默认接口只返回任务状态等信息,请求markdown、items或其他选项后,才带回相应内容。
一开始只要Markdown,后来发现还要元素树,可以对同一个任务再次读取其他表示,不必为了改变返回字段重新解析文件。逐页表示都带page_number,程序应按页号关联;某页处理失败时,数组中的对应条目仍可能存在,却没有内容,不能简单按数组位置拼接。
需要图片或表格工作簿时,也有单独下载入口,但前提是解析任务实际生成了这些成果。下载链接带有效期,适合及时保存,或稍后重新取得链接,而不是当永久公共文件地址引用。
当前产品,与旧 SDK 分开认
旧llama_parse代码仓库目前保留弃用通知,要求迁到新的LlamaCloud包。现行Python指南已经使用llama-cloud;看到旧安装例子,不能据此判断云端解析服务已关,也不应继续把旧包当当前推荐接入。
LlamaParse是商业云端服务,与同品牌开源框架或本地LiteParse有不同处理位置和费用条件。上传文件、所选档位与解析版本都要按当前账号确认,不能把本地开源项目的许可当成这项云服务免费离线的承诺。
它最实用的成果,是让一份解析过的材料能被不同后续工作继续使用:Markdown负责阅读与模型输入,元素树负责程序处理,页号与图片则帮助把它们重新放回原来的文档。
以上为编辑整理,功能、许可与使用条件以官方说明为准。