
让应用里的文字变成声音,LocalAI 可以交回一份本地音频文件
为什么值得关注
把本地语音模型接成应用可调用的服务,明确生成文本怎样交付成音频。
适合谁:希望为自己的应用增加本地朗读或音频导出能力的开发者
这次有哪些亮点
- /tts接文本与模型名,返回音频文件
- 声音目录来自已安装模型,非WAV格式转换需要ffmpeg
使用前需要知道
语言、声音和资源需求取决于具体后端与模型;代码MIT不覆盖模型权重,首次模型和后端下载需准备,接口兼容不代表具备某云服务全部能力。
给自己的应用加一个朗读按钮,除了能选语音模型,还要回答一个交付问题:输入一段文字后,程序到底拿回什么,怎样播放或保存?LocalAI 的 TTS 文档,把这条链路落在一个音频返回接口上。
它负责组织本地推理后端与 API。具体声音来自所安装的模型,LocalAI 本身不是一套能保证所有语言、所有声线表现的通用权重。
请求里写文字,响应里拿声音
官方示例向 /tts 发送 input 和 model,使用一段 Hello world 文本,返回 audio/wav 文件。应用可以接住这段数据,保存为文件,再交给播放器。
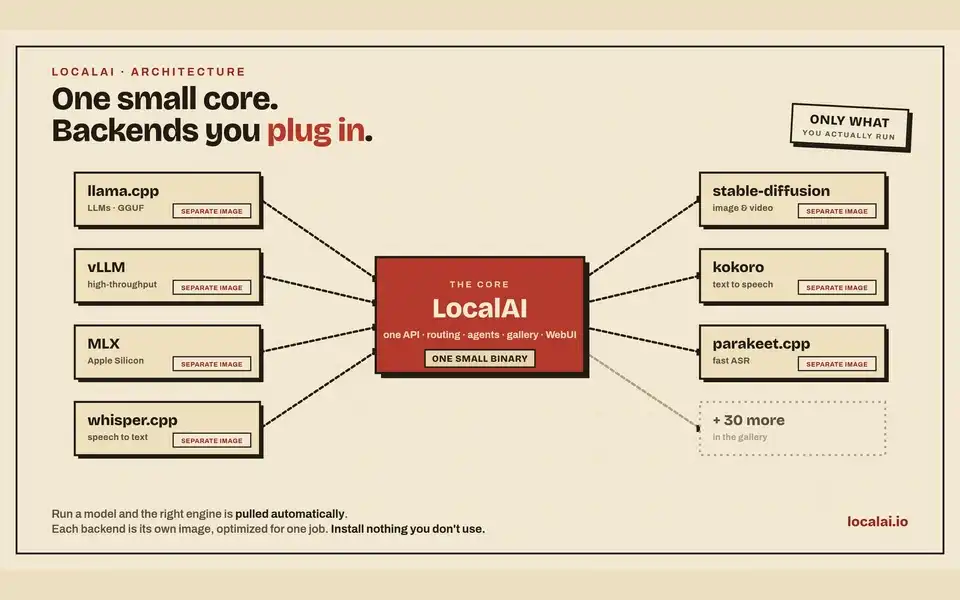
model 在这里指已配置的本地模型名,不是随意填写就能下载的产品代号。README说明,后端按需拉取;部署时需要把模型、相应后端及运行资源接好,再谈文字如何变成声音。
教学情境中,页面生成一段讲解稿后,可以先让用户编辑,再将确认文本发给 TTS,保留原文与音频对应。这个流程有助于回查读错的名称或数字;它不是一段已经完成的中文语音效果演示。
声音列表,也取决于模型是否提供
文档给出 /v1/audio/voices,可按 model 查询已安装模型的声音。条目可以含语言和性别等元信息;其他模型也能在 YAML 中声明目录。
有一个实际边界:没有声音元数据的模型,不会出现在不指定模型的列表响应里;请求未安装的模型则返回404。因此,“列表里没看到”与“服务完全没有TTS能力”不是同一件事,应用最好区分未安装、无目录和真正调用失败。
界面提供的声音选项应当来自该模型实际目录。不能把几个云服务常见的 voice 名称都放进下拉框,再期待每个本地后端理解相同参数。
扩展名与真正编码要一致
默认返回 WAV。如果需要 mp3、aac、flac 或 opus,文档说明要借助 ffmpeg 转换;指定非 WAV 格式却没有 ffmpeg,调用会失败。把 WAV 内容改名为 .mp3,不等于完成转换。
这处细节会直接影响成果能否继续使用:浏览器能否播放、剪辑软件怎样导入、下载文件名是否正确,都与实际响应格式有关。应用应该用响应和所选格式组织文件,而不是只显示一句“生成成功”。
LocalAI 代码采用 MIT,模型权重、参考音频与声线条件仍需分别核对。它在这项任务中的用途,是让应用通过稳定的输入输出调用本地语音:给文字和模型,取回声音,同时保留足够信息解释这份音频由什么生成。
以上为编辑整理,功能、许可与使用条件以官方说明为准。