
Mem0:从聊天里留下事实,再为下一次回答挑选记忆
为什么值得关注
把对话中可复用的事实单独保存并按当前问题检索,减少持续对话产品反复交代背景;也让新旧信息的选择成为可检查环节。
适合谁:正在开发持续对话助手、客服或个性化产品,需要接入长期记忆的产品与开发团队
这次有哪些亮点
- 官方流程先检索相关记忆再回答,之后提取本轮新事实
- 当前自动提取采用单次模型调用、只新增事实,不自动覆盖旧偏好
- 可融合语义、关键词与实体信号,对语义候选进一步排序
使用前需要知道
身份范围需应用正确传入;只新增不等于自动消除冲突。混合检索依赖组件,图记忆已移至托管平台,平台自报分数不能视为开源实测;默认外部模型和嵌入调用并非全本地处理,中文质量未验证。
一个写作助手已经知道你喜欢“先给结论,再举例子”,换个话题后却又从头询问偏好;如果每次都把全部聊天记录重新附上,材料又会越来越长。Mem0 做的是中间这一层:从对话中提取值得保存的事实,按用户等范围存储,再在回答新问题前检索相关记忆。
它主要面向在开发助手、客服或持续对话产品的团队。普通使用者得到的是更连贯的交互,开发者则需要把存储、检索和回答衔接起来。Mem0 提供开源库、自托管服务和托管平台,三者的功能范围与数据部署方式需要分开看。来源:Mem0 开源概览
一段对话怎样进入下一次回答
官方代码中的基本循环很清楚:先拿当前问题检索同一用户的相关记忆,把找到的事实加入回答所用的上下文,再调用模型生成回复,最后把本次对话交给记忆层提取新事实。来源:官方基本用法
用一个中文教学情境解释:用户先说“以后讨论文章,先告诉我你的判断,再展开例子”。系统可以把它作为偏好保存;以后用户要求审一篇稿,先按这个用户的身份检索相关记忆,再把偏好与当前稿件一起交给回答模型。最后得到怎样的审稿意见,仍取决于模型与提示。这是流程说明,没有实际运行,也没有验证中文抽取质量。
这里有一个容易忽略的分工:Mem0 返回的是相关记忆,最终回复由应用所接的模型生成。记忆层不会自动接管整段对话,也不能仅凭“搜到偏好”就证明回答遵循了偏好。用户标识同样得由应用正确传入;记忆过滤条件不等于用户身份认证。
当前写入方式,已经不是旧教程中的更新与删除
当前官方迁移指南说明,自动提取改为单次模型调用、只新增事实。处理时先取相关旧记忆作为去重背景,抽出新事实,再做嵌入、精确去重与批量存储。过去让模型判断新增、更新、删除的流程,已经改变。来源:当前算法迁移指南
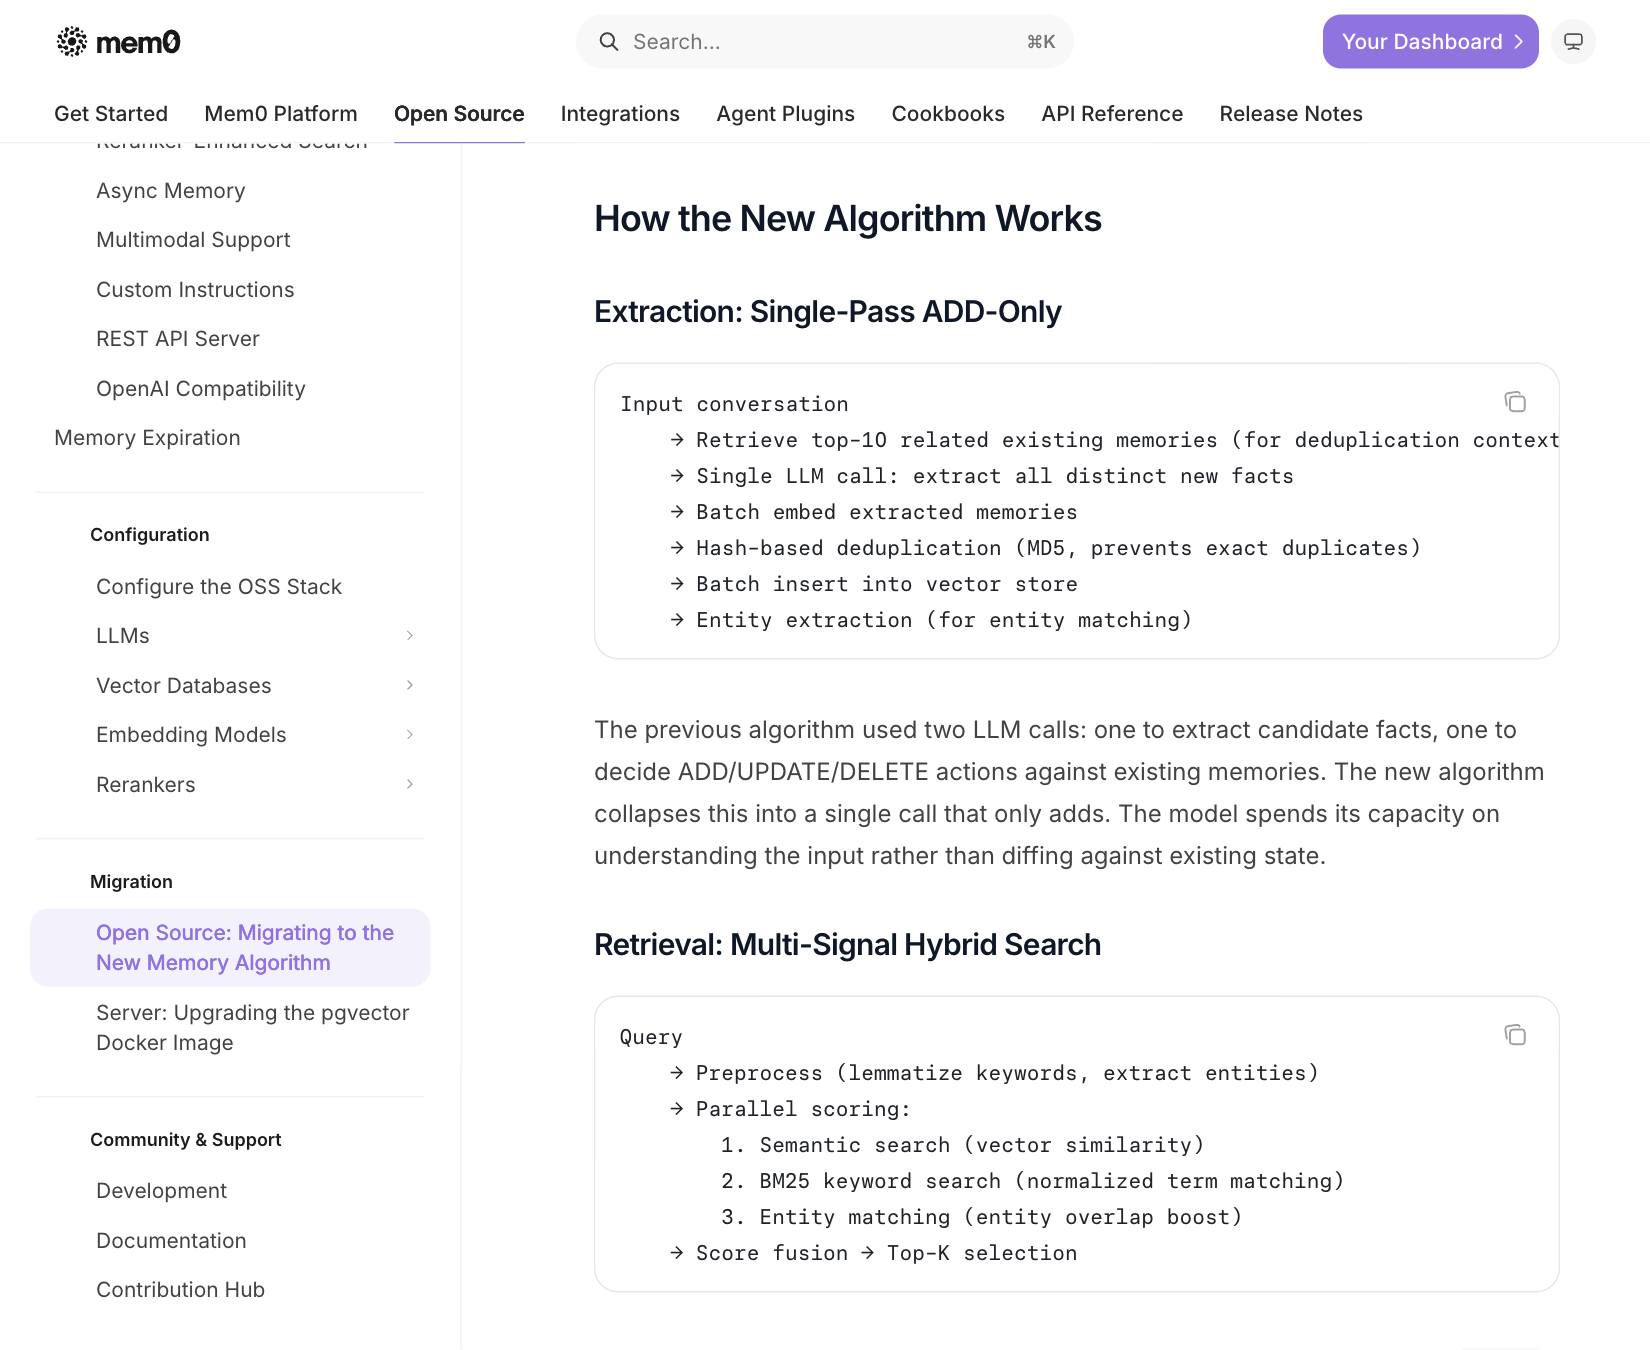
下图来自这份迁移文档的算法小节。重点看提取流程中的“只新增”,以及后面的检索流程;这是编辑对公开页面的真实截图,不是运行成绩或效果测试。
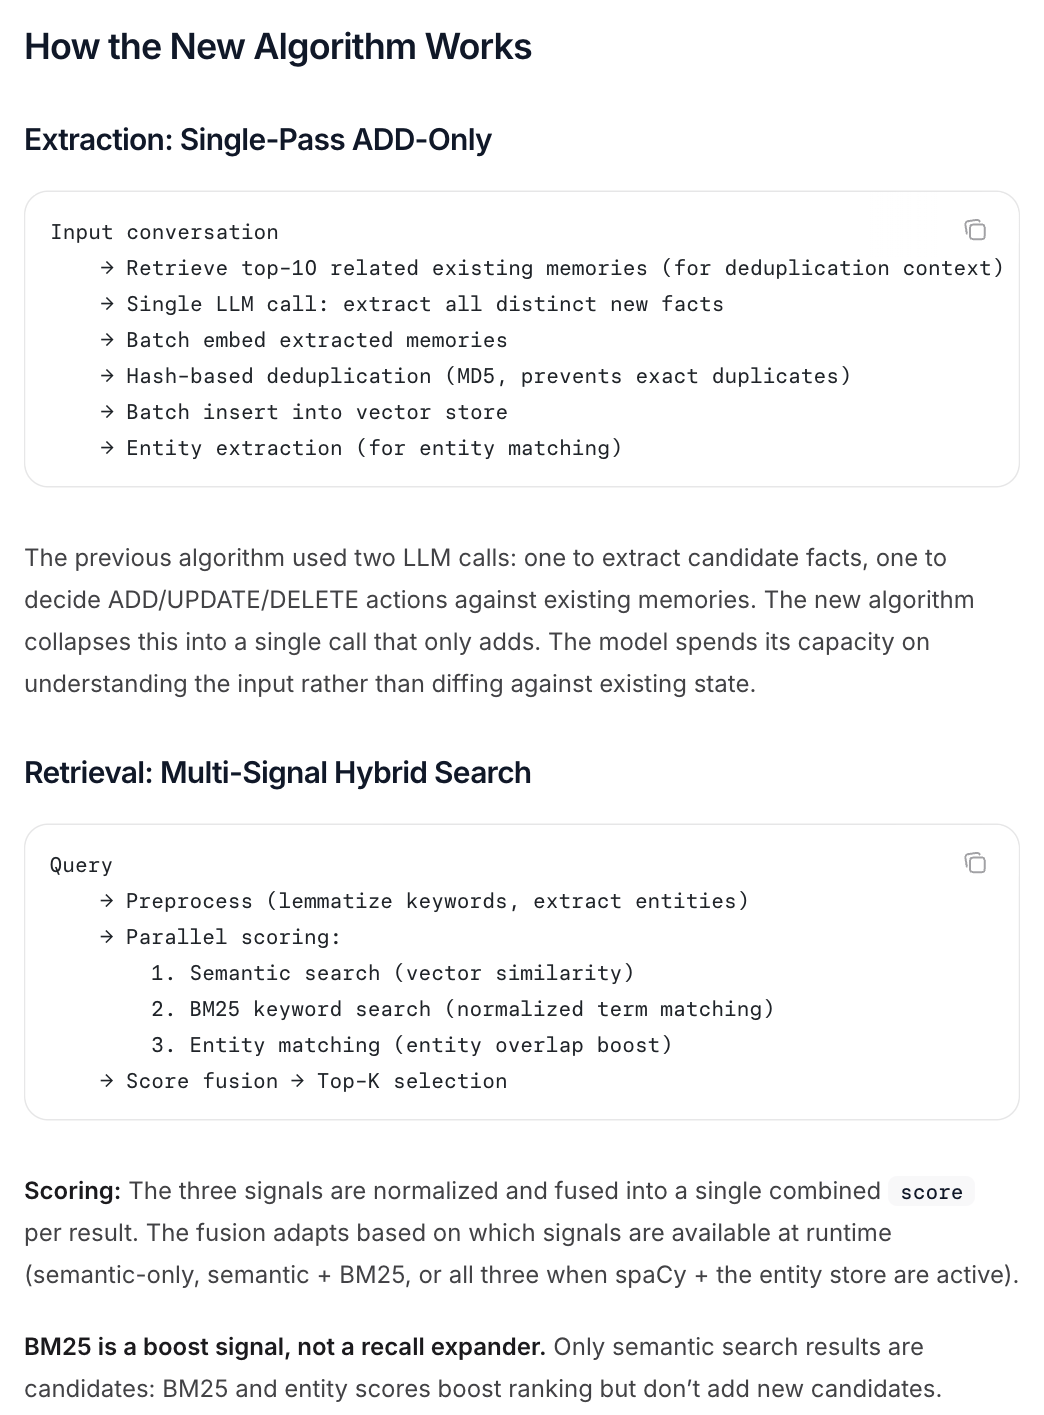
编辑真实截图:Mem0 官方文档,未改写页面内容。打开原图阅读流程。
假设那位用户后来改口,希望“先看原材料,再看判断”,新偏好会与旧事实一起留下,自动写入流程不会先删除旧偏好。官方把选择相关、当前信息的责任更多放到了检索阶段。
这改变了采用时最该看的问题:不能只检查“有没有记下来”,还要看面对新旧事实时,系统是否找回了适合当前问题的那一条。对于会变化的习惯和项目状态,保存历史有价值;如何解释时间和冲突,也随之成为真实负担。“只新增”不是“永远记对”。
多种检索信号,也有明确边界
当前开源文档描述了语义、关键词和实体匹配等信号的融合,但有一处尤其值得留意:候选仍由语义检索提供,关键词与实体信号用于提高候选的排序,不会另外补进新的候选。如果语义阶段漏掉了目标事实,后续加分本身救不回来。
混合能力也依赖额外组件;缺少部分依赖时,会退回较少的检索信号。README 展示的托管平台成绩还包含开源 SDK 没有的专有优化,不能把那些数字视为本地安装后的成绩。当前图记忆也已移至平台,开源版不再提供旧的外部图存储集成。
开源代码采用 Apache-2.0 许可,但自托管不自动意味着模型调用留在本机:默认组件使用外部模型与嵌入服务,需要按自己的数据要求配置。来源:代码许可
对希望减少重复交代背景的产品团队,Mem0 值得看的,是“先找相关事实,再回答”的循环。开始时可以选一组会重复出现、也会变化的偏好,检查提取、身份范围和冲突检索三个环节;只有下一次回答用对了记忆,保存才真正产生价值。
以上为编辑整理,功能、许可与使用条件以官方说明为准。