Milvus:先用本地路径验证检索,再决定怎样上服务器
为什么值得关注
通过同一客户端入口先验证本地向量检索,再按所需功能评估远程服务,减少在召回尚未验证时就决定集群架构。
适合谁:准备验证资料检索、愿意维护嵌入模型和数据,并计划评估后续服务方式的 Python 开发者
这次有哪些亮点
- MilvusClient 以本地 .db 路径使用 Lite,以 URI 和凭据连接远程实例
- 检索可返回 text、subject 等字段,便于检查原文
- Lite 数据可导出后导入其他 Milvus 部署
使用前需要知道
Lite 是本地小规模后端,功能与隔离能力不等同服务器;3.x 不能直接打开 2.x 数据文件。嵌入模型另选,Python 与依赖兼容性需按版本核对。
想给一批资料做检索,未必一开始就知道该怎样部署数据库。Milvus 提供了一个可分阶段验证的入口:Python 的 MilvusClient 既能接本地 Lite 后端,也能用 URI 和凭据连接远程实例。先确认能否找回有用原文,再考虑服务规模,对还在试验检索的开发者更有意义。
本地路径背后是什么
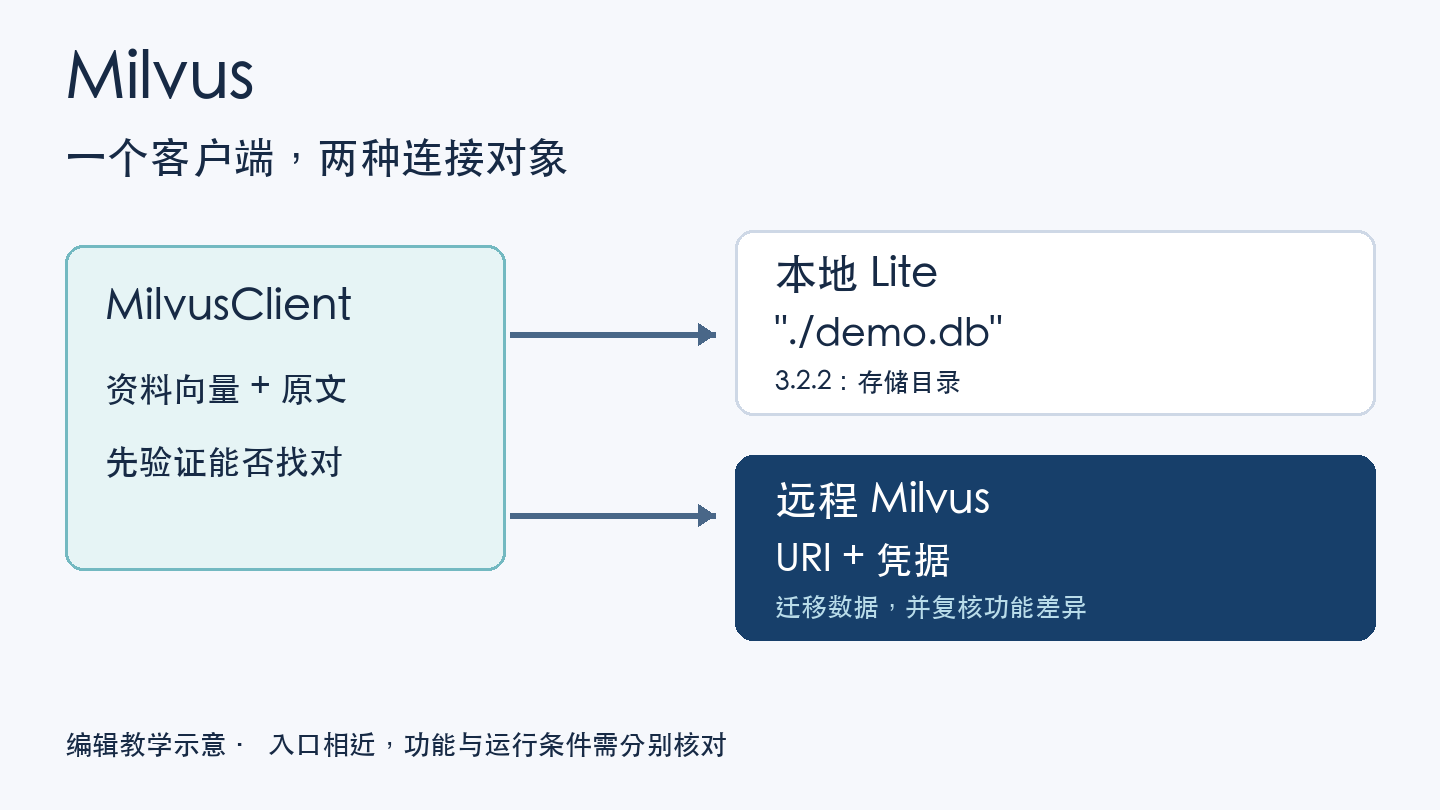
仓库 Quickstart 给出 MilvusClient("milvus_demo.db") 的写法,并明确 Lite 需要相应的可选安装依赖;远程示例则传入 endpoint 和 token。入口相近,连接对象不同。它让受支持的操作可以沿用熟悉的客户端方式,不能据此认定本地与服务器拥有全部相同能力。
这里要纠正一个容易从旧教程带来的理解:官网 Lite 指南明确区分了 3.x 存储方式;在 Lite 3.2.2 中,以 .db 结尾的路径创建的是存储目录,并非一个可随手复制的单文件数据库。Lite 3.x 也不能直接打开 2.x 的旧数据文件;升级包不会自动完成存储格式迁移。版本与备份方式应一起确认。
先验收原文,后考虑答案
以教学情境说明,把一组产品说明段落转成向量,同时保存段落文本和主题。查询也要由嵌入模型编码,再交给 Milvus 搜索。README 的示例用 limit 指定返回条数,用 output_fields 请求 text、subject 等字段;这些原文信息才是判断“找得对不对”的依据。
Milvus 在这里负责组织向量、搜索相似记录,不会因为数据库接通就自动生成可信答案。尤其要留意,当前 Lite 指南中的随机示例向量只演示 API 流程,不表达文本语义。将随机数字换成真实模型编码,并用已知答案的问题核对候选,才进入语义检索验证;中文效果还取决于所选模型和资料。
增长后的决定需要重做
Lite 面向本地开发与小规模任务。3.2.2 文档要求一个进程独占存储目录,同一 collection 的写入要串行;本地适配器也不支持认证、角色权限或 TLS。这些条件意味着,单人原型可用的方式,不能直接作为多人服务的保障。
需要转到远程部署时,除了修改 URI 与凭据,还要核对支持的功能、迁移数据和重验结果。官方提供 dump 导出再导入自建 Milvus 或 Zilliz Cloud 的路径;旧 2.x 数据应在能打开它的原版本环境中导出。不要把“同一个 API”理解成“复制路径即可迁移”。
Milvus 项目采用 Apache 2.0。本篇依据动态 README、官网文档及 Lite 3.2.2 资料整理,未运行项目。下一步可从官方 Lite 指南建立独立测试目录,准备一小组有预期原文的查询;如果召回有价值,再选择 Standalone、Distributed 或托管服务,评估相应配置与成本。
来源:
以上为编辑整理,功能、许可与使用条件以官方说明为准。