
Moirai:时间序列共用一个模型,新版为什么反而做了减法
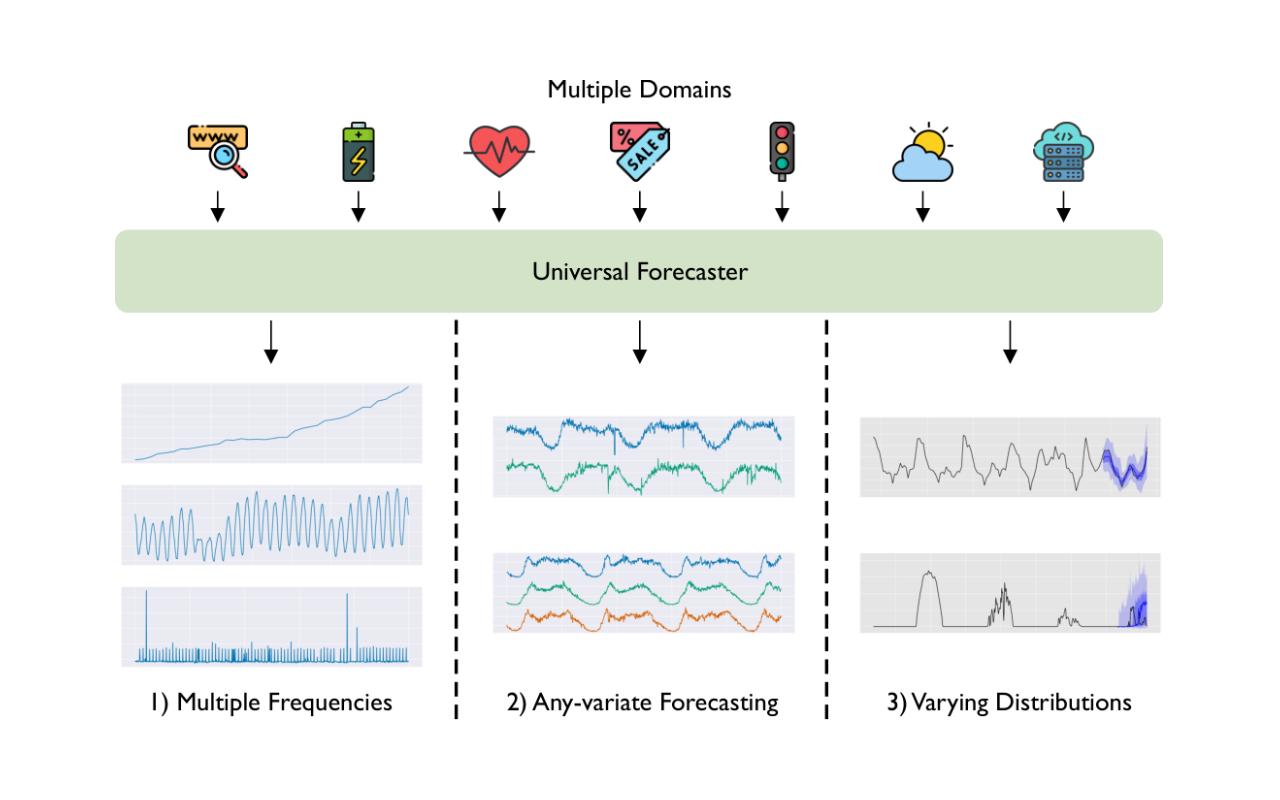
为什么值得关注
Moirai 展示了时间序列模型跨频率复用的思路,同时 2.0 明确移除了多变量和协变量支持,帮助读者把预测需求与正确的版本对齐。
适合谁:需要理解不同频率预测、正在比较单变量与多变量模型的分析学习者和时序研究人员。
这次有哪些亮点
- 初代用多种片段大小与变量注意力处理不同频率及变量数
- Uni2TS 提供预测、微调和评估入口
- 2.0 改为解码器架构、分位数损失和多词元预测
- 2.0 明确撤去多变量与协变量支持
使用前需要知道
2.0 只做单变量,不能沿用初代多变量承诺;公开 1.1 与 2.0 权重均标 CC-BY-NC-4.0,不能由代码 Apache-2.0 推导可商用;2.0 长预测范围表现较弱。
一份数据按天记录网站访问量,另一份按小时记录设备负载;希望换一份数据也能先做预测,而不是每次重新训练模型。这是 Salesforce 的 Moirai 家族要探索的问题:把跨领域学到的时间变化规律,带到新序列上。但打开当前项目时,还要知道一个会影响选择的变化——新版 2.0 已经移除了多变量预测和协变量支持。
Uni2TS 是承载这一家族的 PyTorch 库,不是另一个预测模型。仓库同时保留 Moirai、Moirai-MoE 和 Moirai 2.0 的入口,最新列出的 2.0 权重是 moirai-2.0-R-small。本文解释这些材料,没有运行自己的预测实验。当前官方仓库
初代怎样面对不同频率和变量数
小时曲线和月度曲线,一个点代表的时间尺度不同;同样长度的一段数值,包含的模式也可能不同。初代 Moirai 用多种片段大小处理序列,并设计变量注意力,让模型能够接收不同数量的变量,而不把输入永远固定为几列。
论文图 2 给了一个连续例子:三个变量中,前两个是需要预测的目标,第三个是未来值已经知道的动态辅助变量。每条曲线被切成片段,未来目标所在片段加遮罩;辅助变量在未来仍可见。模型结合时间位置和变量关系处理它们,最后把目标位置的输出转成预测分布。初代论文第 3 节与图 2
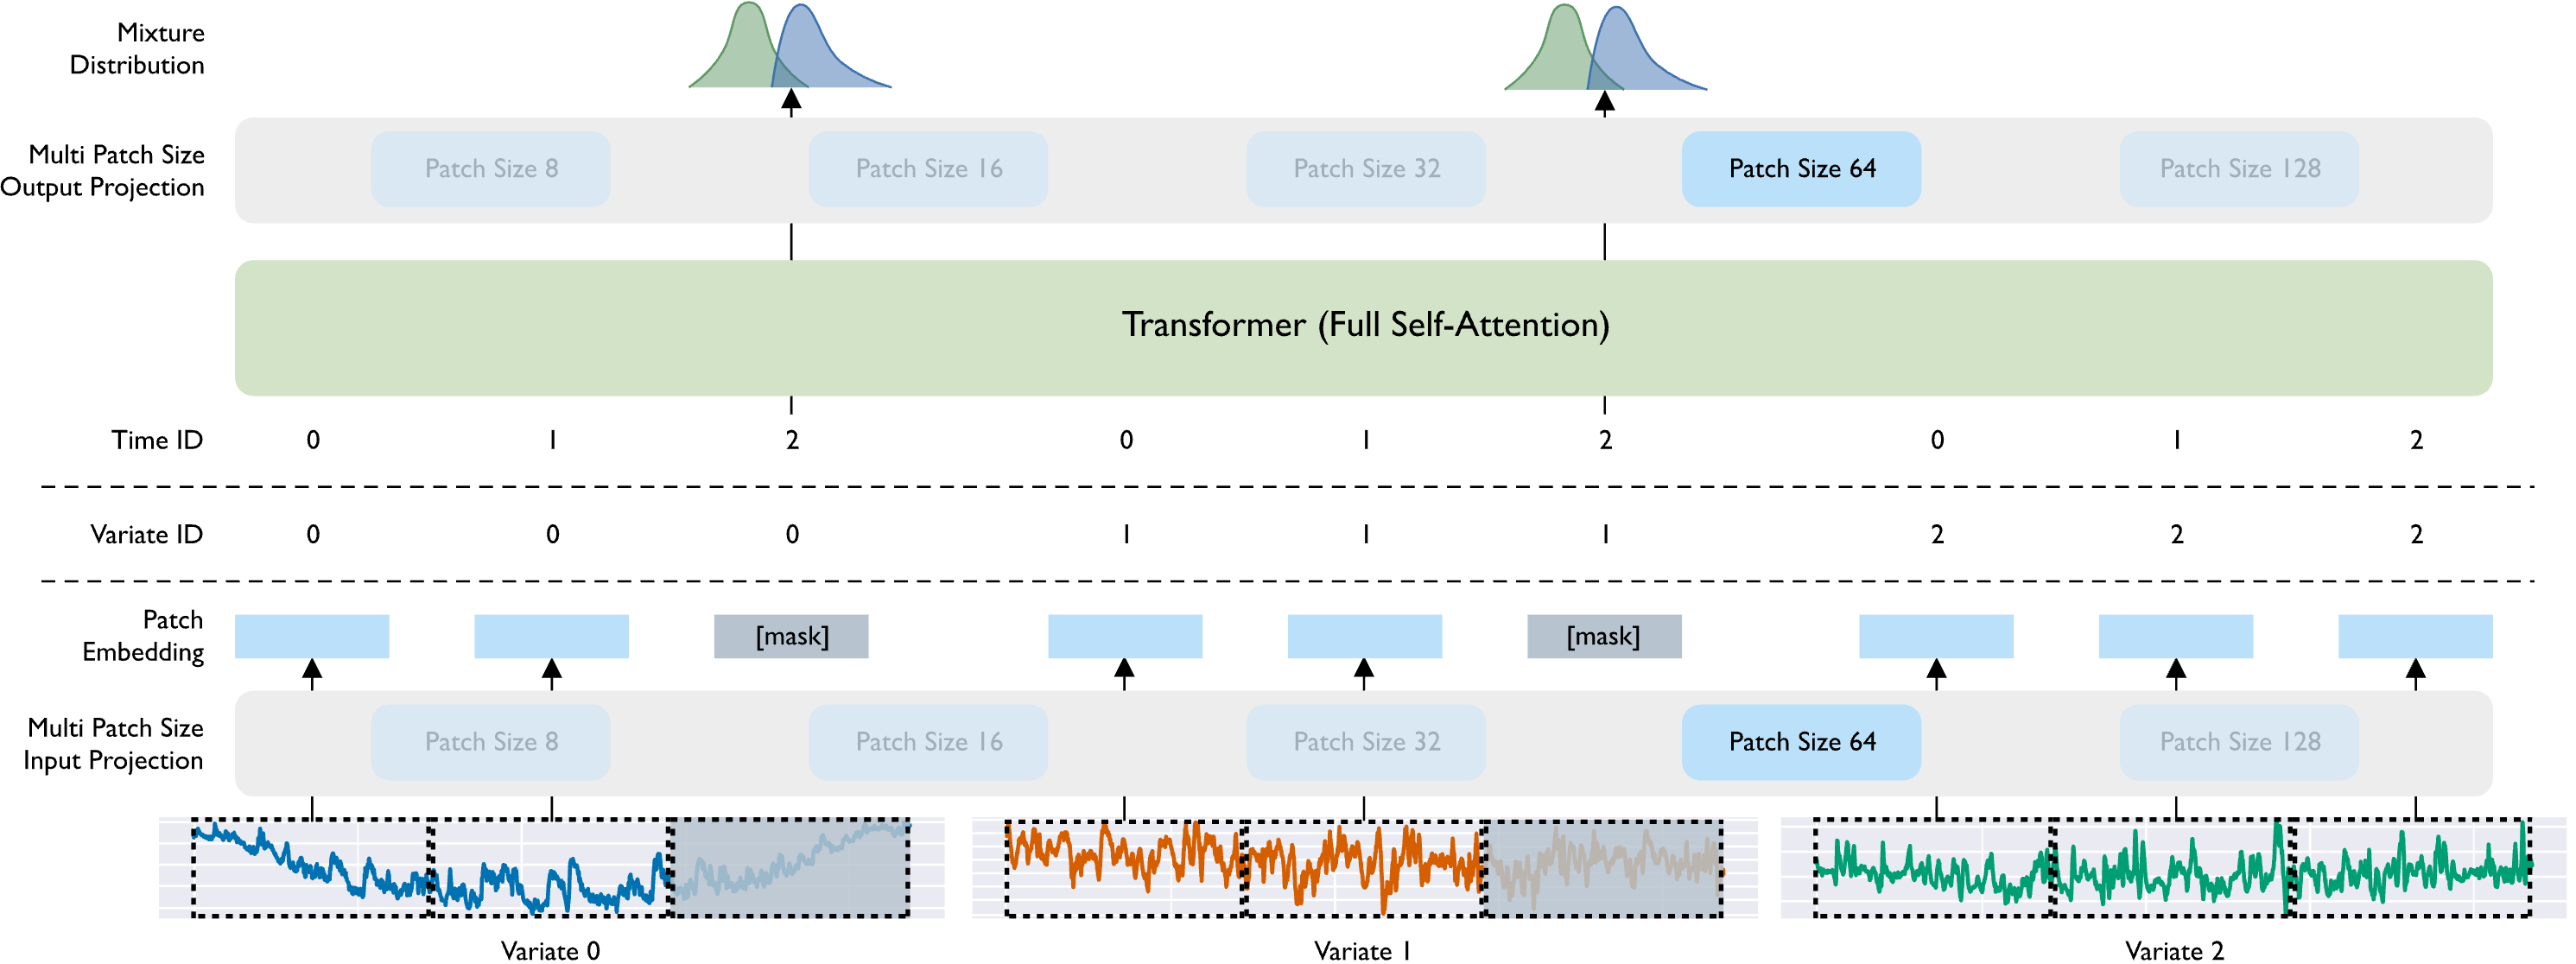
官方示意,属于初代 Moirai。底部前两条曲线末段被遮罩,第三条仍提供未来输入;图中选用片段大小 64,并非所有任务固定用这个值。原 SVG 经浏览器渲染。打开清晰原图
“跨频率”也不是把小时、日、月的错位数据随手并排就能预测。它说的是模型能在不同任务和采样尺度间复用,任务内部仍需明确每一步的时间意义、预测多远、哪些变量事前可知。对想同时预测温度和负载、又提供已知排班的研究任务,初代的结构与新版是否相同,就会直接影响采用决定。
2.0 为什么没有继承全部能力
2.0 改用了仅解码器架构、分位数损失和多词元预测,并用单一片段大小替代初代的多片段方案。它尝试以更精简的设计改善预测和计算效率,不能继续用初代“混合分布输出”的图解释新版内部过程。
更关键的是,2.0 论文第 6 节明确说,作者因为观察到收益有限,去掉了多变量预测和协变量使用;高质量相关数据不足是他们提出的可能原因。这不是“暂时没找到示例”,而是发布版本本身的能力取舍。若任务依赖多个目标互相参考,或依赖未来排班,不能仅因为版本号更新就直接切到 2.0。2.0 技术报告与限制
2.0 的实验主要在 GIFT-Eval 上展开,覆盖 55 个数据集的 97 种任务配置,按该基准协议评价点预测和概率预测。作者报告较初代的改善,也指出随着预测范围变长,其相对表现变弱。这些结果支持研究新版的单变量预测路线,不能证明每一种数据频率都提升,更不能把当时榜单排名称为今天的固定名次。
从自己的数据开始,先决定预测问题
仓库用宽表读取数据,再转换成 GluonTS 数据集,保留末段作为测试,并构造滚动预测窗口。这样能看见模型在不同预测起点上的表现,而不是只挑一段好看的曲线。对按小时记录的教学任务,可以先明确“用过去一段负载预测后续若干小时”;输出应与留出的真实负载逐点对齐,再讨论误差与分位数是否有用。
我的取舍是:先按是否需要多变量、是否有未来辅助信息来选路线,再比较新旧版本在同一份测试数据上的结果。版本变化提供了研究方向,不能替代这两个任务条件。
最后还要把代码与权重分开。Uni2TS 代码为 Apache-2.0;公开的 1.1 与 2.0 模型卡都标注 CC-BY-NC-4.0,研究权重不能因代码开放而推导成可直接商用。2.0 的训练材料还包括内部 Salesforce 运营数据,不能声称训练数据全部开放。2.0 官方模型卡
以上为编辑整理,功能、许可与使用条件以官方说明为准。