
MusicGen:带着一条旋律,试出不同的编曲方向
为什么值得关注
旋律音频与风格描述可共同引导生成,适合围绕同一条音乐线索比较编曲方向,而不是每次换一首随机片段。
适合谁:想用自有旋律学习编曲方向、能接受英文描述与非商业权重条件的音乐爱好者
这次有哪些亮点
- melody 型号支持文字加旋律音频条件
- 官方提供同旋律、多种风格描述的成对示例
- 提供多种规模、立体声型号及 WAV 保存示例
使用前需要知道
权重CC-BY-NC4.0,代码MIT;不能生成逼真人声,非英文描述较弱,旋律条件不保证逐音复刻。中型模型建议16GB显存。
脑中有一小段旋律,却不知道它配摇滚吉他还是合成器更合适,可以先认识 AudioCraft 里的 MusicGen。它接受音乐描述,也有接收旋律参考音频的型号,把同一条音乐线索放进不同风格里生成片段。对想尝试编曲方向的爱好者,比起只写“来一段好听的音乐”,这种有参考的探索更容易比较。
官方示例怎样使用同一条旋律
MusicGen 官方演示页的 Melody-guided music generation 部分,选了 Bach、Ravel 和 Lucille Crew 三组旋律材料。每组都配了三种描述:电吉他与重鼓的九十年代摇滚、带合成器铺底的八十年代流行,以及合成器和强低音驱动的嘻哈。页面把原始旋律播放器与 MusicGen 1.5B melody 输出并排放置。
这个组织方式很有参考价值:先固定旋律材料,再换风格描述。你比较的是同一条线索进入不同编曲方向后的变化,而不是三首互不相关的随机成品。这里解析的是官方示例的输入和展示方式,本文没有在本机生成或作听感测评。
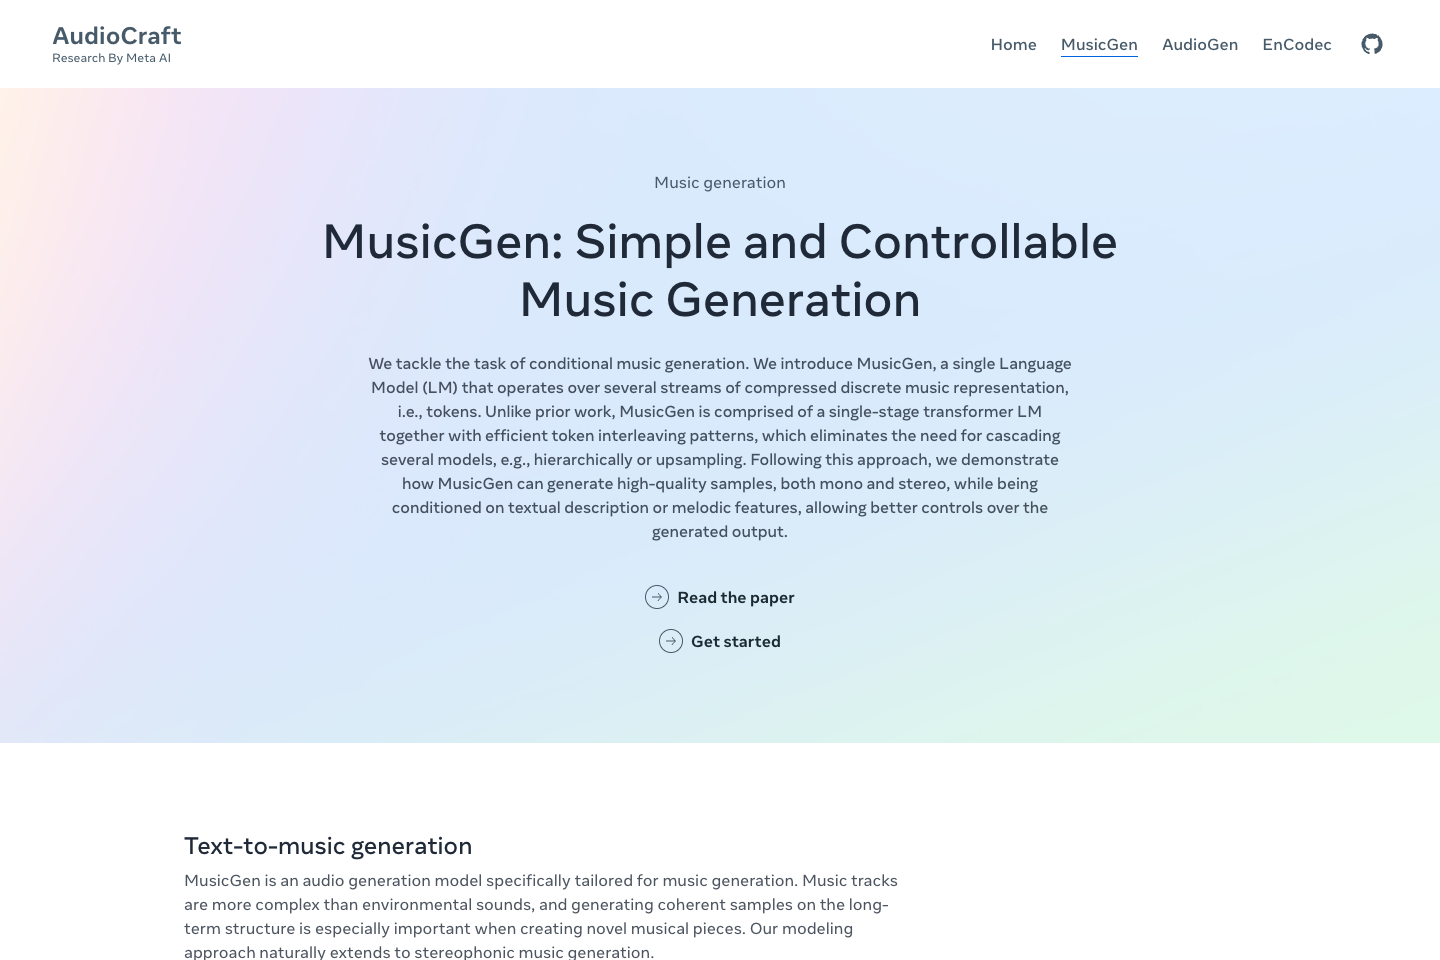
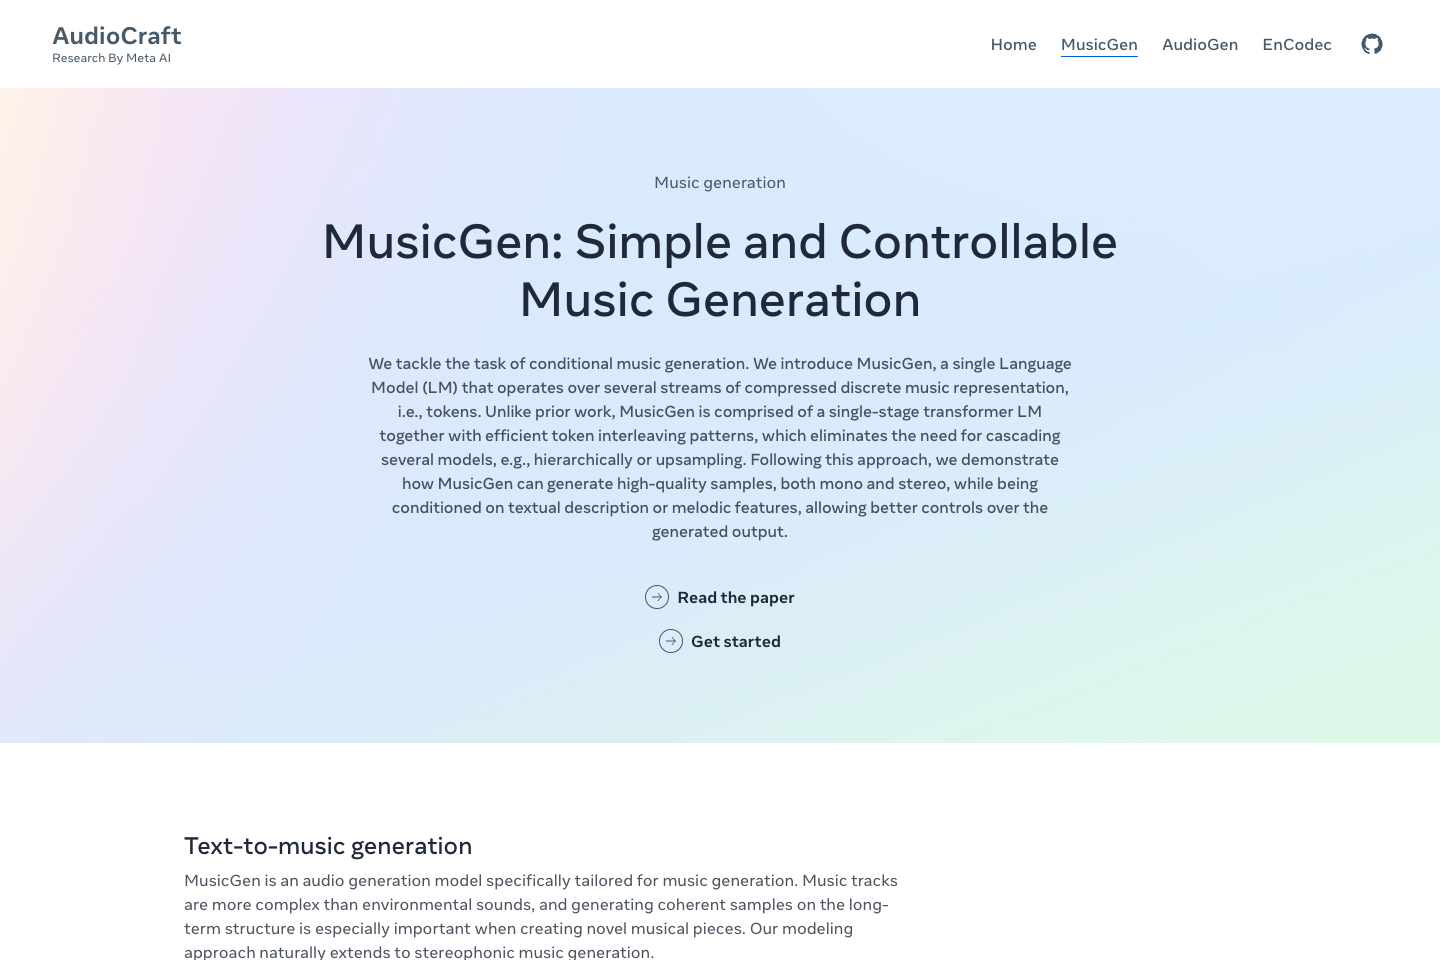
图中可看项目身份、文本与旋律条件说明,以及 Get started 入口。它是官方介绍页截图;真正的旋律对照播放器在页面下方,截图本身不能说明音乐是否好听,更不是本文中文输入的输出效果。(打开原图)
哼唱可以作为尝试材料,别把它当逐音照抄
官方说明的关键是 chromagram:从参考音频提取与音高、和声有关的特征,再与文字描述共同引导生成。它不是先保证完整抄下乐谱,再给每一个音符配器。因此,“沿着参考旋律生成”不能直接理解为原录音每个音符、节奏和音色都会原样保留。
如果你手头是自己哼的一段旋律,可以把它作为待验证的参考输入,再用文字指定乐器与风格。这是根据音频条件接口设计的尝试路径,不是已经验证过的哼唱案例。更稳妥的起点是先听官方同源对照,理解它能控制到什么程度,再换上自己的短素材。
文档中的程序示例也很清楚:读取 bach.mp3,把同一份旋律分别配上 happy rock、energetic EDM 和 sad jazz 三种描述,调用旋律条件接口,最后保存为 WAV。这里的成果是可播放的音频文件,适合拿来比较配器方向;它没有交付独立乐器轨,也没有承诺把你的哼唱整理成精确乐谱。
选型号时,melody 不是可有可无的后缀
MusicGen small、medium、large 的常规模型用于文字生成音乐;要给旋律参考,应选择 musicgen-melody 或相应的大型、立体声旋律型号。官方文档把 medium 与 melody 作为质量和计算量之间的折中推荐。只是试文字音乐,可以从更小型号开始;手里已有旋律,先确认型号支持这类条件,再谈调参数。
中文用户还要注意它的任务边界。模型卡明确说,训练描述主要是英语,其他语言表现较弱,而且不能生成逼真人声。它适合探索配乐和编曲,不适合输入一段中文歌词后,期待它逐句唱出完整中文歌。为英文描述补出清楚的乐器、节奏和风格信息,比反复换中文歌词更符合这个模型的用途。
从演示开始,再决定是否本地运行
官方演示页 适合先看成对样例,文档还链接了 facebook/MusicGen Hugging Face Space 与本地 Gradio 演示。在线演示是否排队或可立即生成,要以当时页面为准;已有公开样例不等于云端服务始终可用。
本地 AudioCraft 文档要求 Python 3.9、PyTorch 2.1.0,并建议安装 FFmpeg;中型模型推理建议至少 16GB 显存,较小显卡可尝试小模型或较短片段。代码是 MIT,模型权重则是 CC-BY-NC 4.0,不能把“代码可商用”扩成“这些权重可直接用于商业配乐生产”。如果目的是个人学习和比较音乐方向,这是一条清楚的尝试路线;若要给商业项目正式供曲,应先解决权重使用条件。
参考:
以上为编辑整理,功能、许可与使用条件以官方说明为准。