
Nougat 把英文数学页转成标记,公式不必只剩一张截图
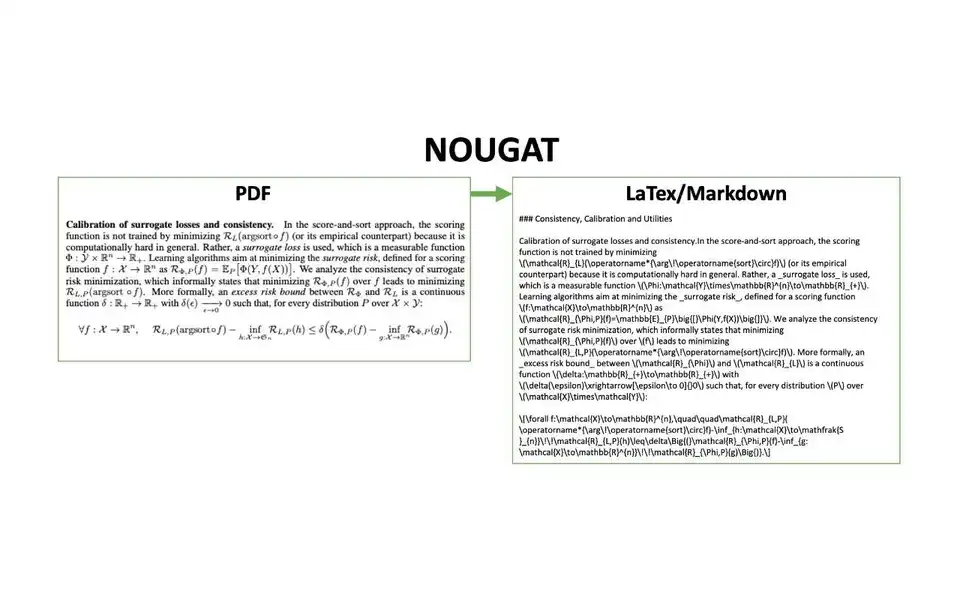
为什么值得关注
将英文科学文档页面转换为带LaTeX数学表达的MMD,方便后续编辑与数字化研究。
适合谁:处理英文论文或旧数学书数字化、需要可编辑公式材料的研究者
这次有哪些亮点
- 每份PDF输出.mmd,保留数学与表格标记
- 可选择页范围,官方样例可在渲染与RAW之间切换
使用前需要知道
2023研究项目,当前仓库未归档但最近推送2025-02;代码MIT权重CCBYNC非商用,官方明确不支持中文日文等,输出可渲染不保证公式正确。
旧数学书扫描成PDF以后,普通文字识别或许能恢复正文,分式和极限却常常难以直接编辑。Nougat要恢复的不只是可搜索的字,而是带数学标记的文本:标题、说明段落与LaTeX公式,可以继续进入可编辑材料。
完整官方README说明,每份PDF会生成.mmd文件,主要兼容Mathpix Markdown,并使用LaTeX表格。它是2023年的科学文档研究项目,不能因为今天重新介绍就叫成刚发布的新模型。
从一页旧微积分书,看输出是什么
官方项目页的Example Pages第一项,使用March与Wolff的1917年《Calculus》第43页。左侧是泛黄的扫描页,右侧显示提取结果,还可点击RAW查看原始标记。
在这页“常数的导数”一节里,结果保留了章节标题、y=c的说明,以及\frac{dy}{dx}=0这类公式表达。它们不必作为一张整体截图被搬走,而能分别成为标题、正文和数学表达,放进支持相应语法的阅读或编辑环境。
接下来的“两个函数和的导数”也保留了一串推导形式,说明输出不只是最终一句结论。这个样例来自项目方,不是本文运行生成,也不能用于保证别的扫描书获得同样识别效果。
能渲染,与公式已经校对不同
RAW入口值得看,因为它能让读者直接检查模型究竟写出了什么命令。比如同页输出中可以看到带横线的dx等标记,需要与原页逐式对应;一段文本成功显示成数学排版,并不能证明符号与原书完全一致。
对准备数字化资料的人,比较合适的成果是一份有待校订的标记稿。选取需要的页段,保留扫描原页,逐项检查公式中的上下标、括号与等号;修订后的表达再进入教材笔记或文本分析流程。它不是拿到输出就完成学术内容校勘。
这条路线主要面向英文科学材料
README明确说,模型训练来源是arXiv与PMC科学论文,最适合英文,中文、俄文、日文等不支持。对中文读者,这项介绍的使用对象是英文文献数字化,而不是中文古籍或日文讲义转换。
命令行能处理单份PDF、目录或文件列表,也可选择页范围。遇到[MISSING_PAGE]时,官方提到失败检测在部分CPU或旧GPU上可能误判,可调整相关检测设置;关闭检测只是改变处理行为,并不证明页面内容已正确恢复。
采用条件还要分开看:代码是MIT,模型权重是CC-BY-NC,不能把代码开源理解为权重可自由商用。当前仓库未归档,GitHub显示最近推送在2025年2月,也没有依据把它写成持续推出新版本的热门工具。
Nougat仍提供了一种值得理解的产物形态:英文科学页面可以先变成带公式的标记稿,再由人校订、编辑和使用。若你的材料正属于这一范围,官方旧书对照样例是判断这条路线是否适合的具体起点。
以上为编辑整理,功能、许可与使用条件以官方说明为准。