
Onyx:把团队应用里的资料,接成能追来源的问答入口
为什么值得关注
把资料来源同步和索引纳入问答流程,便于团队反复查找与复核已有知识。
适合谁:需持续同步团队资料、维护索引和权限,并希望从回答追到来源的团队。
这次有哪些亮点
- 连接应用并建立知识索引
- 来源标记帮助从回答返回材料
- 社区版涵盖核心 RAG、聊天、代理与 Actions
使用前需要知道
文档索引需要 Standard 路线,Lite 不支持;ee 目录采用企业许可,生产使用要求有效授权;模型、服务器和云服务费用另算,中文效果需验证。
交接一个项目,答案往往散在说明文档、工单和历史讨论里。Onyx 希望先把这些来源接入并建立索引,再让团队用一个问题找回有关材料、获得整理后的回答。对于需要反复回答“这件事当时怎么决定的”的团队,这比每个人重新上传一遍文件更有持续价值。
连接资料之后,还要持续建立索引
官方仓库把 Onyx 称作团队与 AI 代理的知识上下文层:连接应用,拉取内容及元数据,再供检索和问答使用。它的特点在于把收集资料变成系统的一部分,而不是只在当前聊天临时附上几份文件。
官方文档将内部搜索、连接器、聊天和自定义代理放在同一条使用路径里。对采用者而言,连接器负责“材料从哪里来”,索引负责“怎样找回来”,模型负责“怎样组织回答”。同步范围、索引状态和模型选择,任何一处变化都会影响最终答案。
一份项目交接,应当怎样读回答
例如,假设客服要查“退换货政策为什么从 7 天改为 14 天”。接入材料里有新版政策、旧版说明,以及一条仍在讨论中的工单。希望得到的成果是:指出适用版本,概括已经确认的变化,并能回到相关文件核对。这是中文教学情境,不是官方中文演示或本次运行结果。
这里有一次不能省略的判读:新版政策能证明当前条款,讨论工单只能证明有人提出过某个理由。假如 AI 把工单里的猜测写成正式决策依据,就算引用链接真实,答案也没有完成交接任务。因此,这类工具最值得接入的是“能找到、能打开、版本可辨”的资料;尚未确认的讨论要在回答中保留其性质。
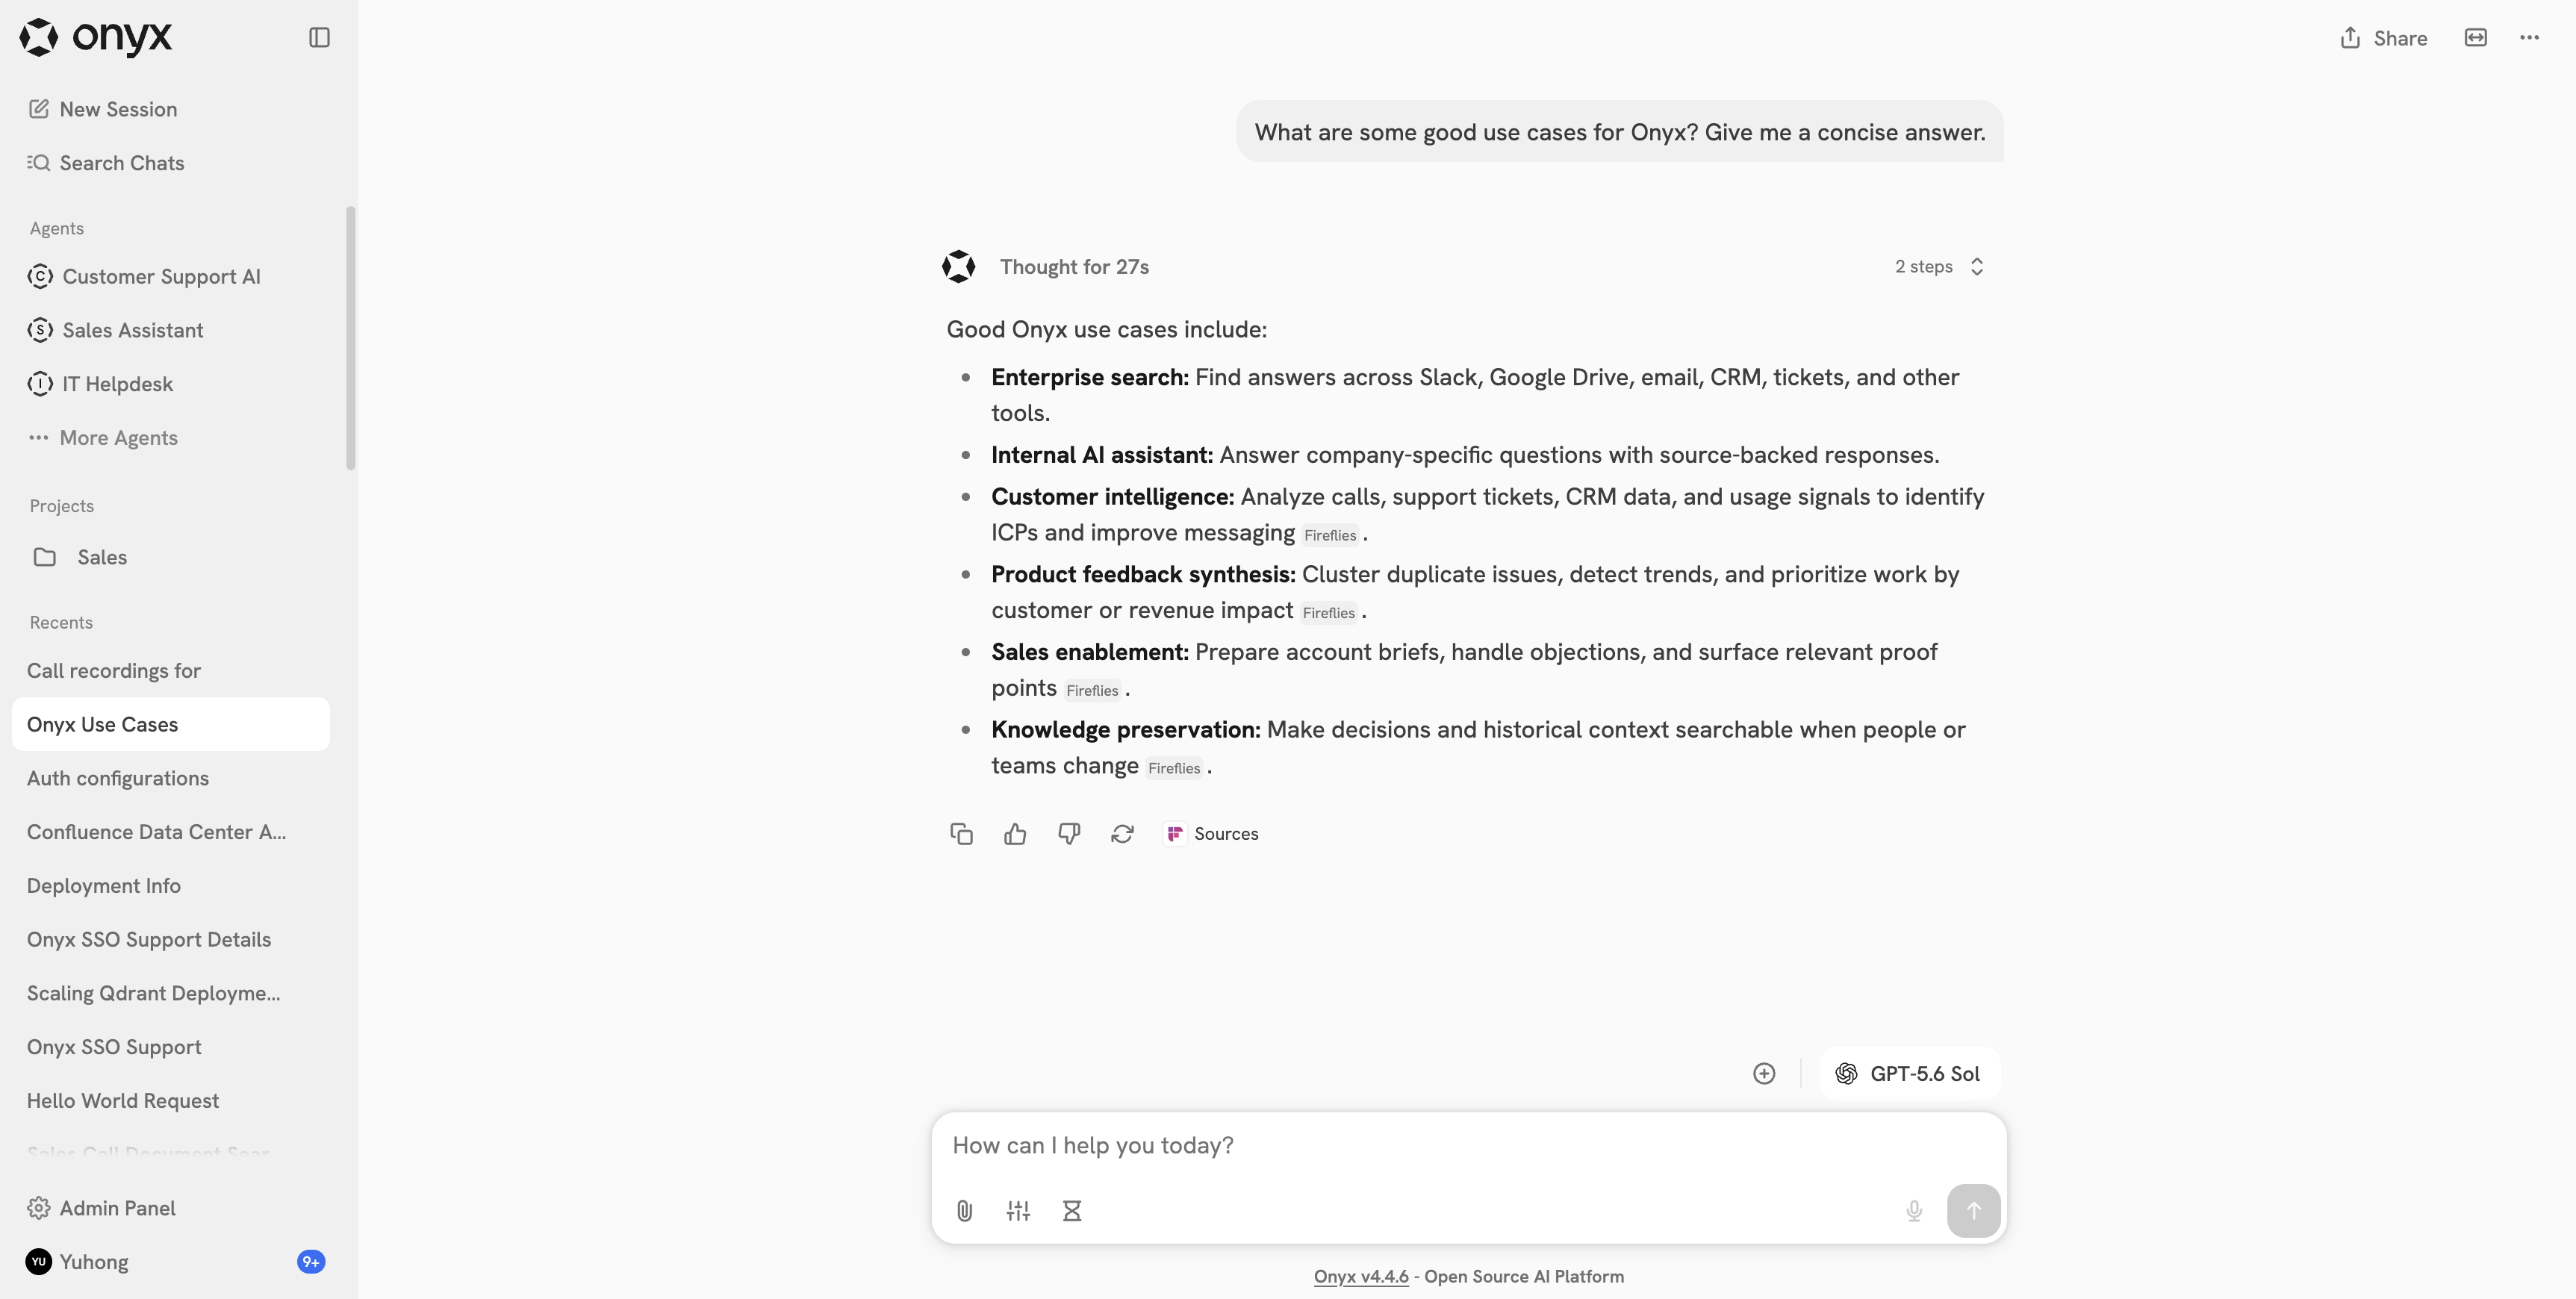
来源:官方 README 界面图。演示问题是在问 Onyx 的用途,可看到来源标记及 Sources 入口;它展示复查关系,不证明上述政策案例已经跑通,也不能证明中文回答或引用准确率。
这张图中,有些论点旁带着来源名称。值得学的是沿着论点返回材料,而不是把“有引用”整体当成可信度结论。交接任务需要逐条确认版本、适用对象与结论,引用只提供了做这一步的入口。
要查文档,不能选错 Lite 模式
仓库区分 Standard 与 Lite。Standard 包含面向 RAG 的向量与关键词索引、同步任务等组件;Lite 主要提供较轻的聊天与代理界面,明确不能索引文档。想实现本文的跨资料问答,应沿 Standard 路线规划,不能拿 Lite 的轻量资源描述估算整个知识系统。
部署入口在官方快速开始,README 也链接了 Docker、Kubernetes 等部署说明。首次验证不妨只接一个资料来源,选几道已有明确答案的问题,检查能否找到正确原文。连接成功不等于内容已同步齐全,回答顺畅也不等于资料覆盖完整。
社区核心与企业能力要分开看
README 说明,社区版的核心 RAG、聊天、代理与 Actions 采用 MIT 许可;根许可证进一步排除了 ee 目录及相应第三方部分。ee 目录采用 Onyx Enterprise License,其生产使用要求有效企业授权,开发测试的允许范围另有条款。
SSO、SCIM、使用分析、查询历史等出现在仓库的企业能力介绍里。团队真正依赖这些能力或细粒度资料权限时,应逐项核对当前版本与套餐范围,不能从“社区核心 MIT”推出整套企业能力免费开放。
自托管还要决定模型端点
Onyx 可以自托管索引、数据库和处理服务,也允许选择本地或外部嵌入模型、语言模型。若选择外部端点,相应文本与上下文会进入该服务处理;云部署则还涉及托管方。软件许可不包含模型权重授权、API 用量和服务器费用。
我会把它列入有稳定资料来源、愿意维护同步与权限的团队候选。若只是偶尔问两份文件,系统成本可能大过收益;若同一批资料持续更新、多人反复追问,集中索引与来源复查就更有意义。中文检索与回答仍需用自己的材料验证,不能由这张英文界面图担保。
以上为编辑整理,功能、许可与使用条件以官方说明为准。