
PaddleOCR-VL 1.6:整页生成Markdown,单张表格另有识别入口
为什么值得关注
区分整页解析和表格、公式等局部识别,为已有文档流程选择真正需要的一层。
适合谁:希望处理中文报告、表格或公式,能配置模型环境的文档工具开发者
这次有哪些亮点
- 官方PaddleOCRVL管线按v1.6运行并导出JSON/Markdown
- transformers示例仅处理元素识别和文字定位,任务提示明确分开
使用前需要知道
需对应PaddlePaddle及PaddleOCR至少3.6.0,模型卡对macOS建议Docker;局部示例不代替整页解析,长结果受输出token上限约束,权重Apache-2.0。
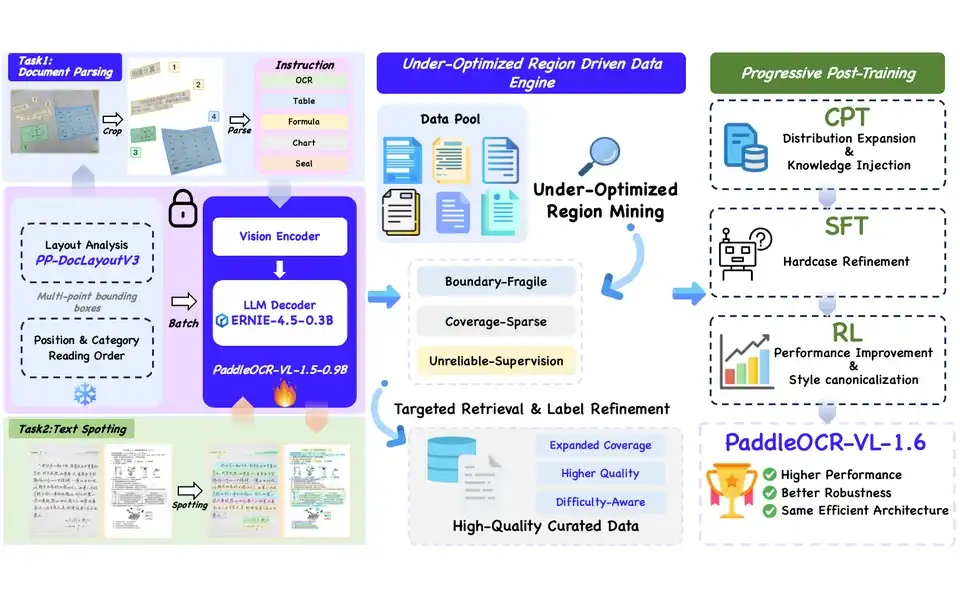
一页报告要变成完整Markdown,与只想识别其中一张表,交给模型的任务并不相同。PaddleOCR-VL 1.6把这两个入口放在同一份模型卡里:官方管线负责页面解析,直接调用模型则可以限定表格、公式、印章等元素。
它是独立的视觉语言文档模型,与此前介绍的PP-StructureV3及表格处理路线有不同的模型与调用方式。本篇限定1.6,不把旧管线操作或其他型号的指标搬进来。
整页报告,走页面管线
官方型号卡的示例用PaddleOCRVL(pipeline_version="v1.6")加载管线,将页面交给predict,然后分别保存JSON与Markdown。一个留结构化结果,一个留便于阅读和继续处理的文档表达。
这适合先把报告页组织成可使用材料,再接检索或编辑工具。模型卡同时给出识别服务与页面管线分开的部署方式:VLM可以由推理服务器承接,前面的文档管线仍负责完整处理。只启动模型服务,不等于整页解析系统已经全部准备完毕。
已经裁好的表格,不必伪装成整份文档
transformers部分的任务选项包括ocr、table、formula、chart、spotting与seal,分别配有明确提示。给一张公式图片请求公式识别,与把它当普通文字读取,目标格式和解释范围都不同。
假设你只需要重录公开报告里的一张比较表,这是教学情境。可以先裁出完整表头、数据与脚注,再用表格任务;如果某行的归属要靠上一段正文才能解释,则仍应保留整页或相应上下文,不能期待局部裁图自动知道被剪掉的条件。
官方特别注明:这份transformers代码只支持元素级识别和文字定位,页面级解析推荐走前面的官方方法。因此,局部表格能出结果,也不能证明整页的阅读顺序和图文组织已完成。
参数改变的是输入与输出边界
文字定位示例会在图片两边都小于指定阈值时放大输入,并为spotting设置不同的像素上限。它不是对所有任务统一执行同一种缩放。自己接入时,应保留任务名称与实际输入处理,才知道一份坐标或文字结果由哪条路径产生。
样例还设置了生成token上限。长表格、密集文字的结果若被截断,应检查输出长度与任务范围,不能只因返回了一段可读文本就判断所有单元格都已取完。源码里的演示值不是任意文档的最佳配置。
1.6在2026年5月发布,模型卡介绍了针对薄弱区域的数据优化与渐进后训练。这是训练方法,不能被误解为用户上传文档后自动得到一个人工校正界面;本文也没有复测其榜单分数或中文生僻字准确率。
采用时还需要对应的PaddlePaddle与PaddleOCR版本;模型卡列明PaddleOCR至少3.6.0,并对macOS给出Docker环境建议。权重标注Apache-2.0,但另接服务与输入资料仍按各自条件处理。
最值得先定下来的选择是:需要整个页面的文档结构,还是某个区域的识别结果。把这两层分开,原有工具就能增加缺少的能力,而不是为了认一张表重新搭完整系统。
以上为编辑整理,功能、许可与使用条件以官方说明为准。