
Prithvi-EO-2.0:让同一块农田的多期卫星影像一起参与识别
为什么值得关注
用官方三期作物分割材料说明时序影像怎样参与像素分类,避免把影像重建演示误作任务识别效果。
适合谁:手头有遥感影像或标注材料、需要研究多时相分类与分割的学习者。
这次有哪些亮点
- 三维切块把时间与空间一起编码
- TL型号加入时间和地点信息
- 提供作物分割等任务的TerraTorch配置与notebook
使用前需要知道
基础权重需配下游训练,非开箱即用的当地作物识别;美国作物案例不代表中国农田效果;30米预训练影像及跨分辨率评估不等于超分辨率真实还原。
同一块地在春夏秋的颜色不同,只看一张卫星照片,可能看不出作物差异。Prithvi-EO-2.0 把同一地区在多个时刻的多光谱影像一起处理,为农作物分类、地表覆盖和灾害痕迹识别提供可微调的底座。它由 IBM、NASA 与于利希超级计算中心等机构合作开发,重点是地球观测影像,不是根据文字生成地图。
这个项目最值得认识的能力,是让时间也成为影像的一部分。模型除了看“这里是什么样”,还可以利用同一位置随时间怎样变化的信息;任务结果则需要通过相应的下游训练获得。
三期影像怎样变成一张分类图
官方仓库提供美国多时相农作物分割的配置。按这份配置理解一次任务:输入同一区域的三期影像,每期保留蓝、绿、红、窄近红外与两个短波红外波段;模型把它们组织成带时间维度的数据,再由预训练骨干提取特征,交给分割解码器输出像素类别。
这份任务设置有 13 个类别,包含玉米、大豆、冬小麦,也包含森林、水域等地表类型。训练时还要提供对应标签,让模型学习哪些像素属于哪一类。最终目标是一张按像素区分类别的图,不是让模型直接写一段“这片农田长势良好”的评价。官方配置与示例
以上解析的是公开配置与任务材料,并未实际运行训练。基础权重不等于已经完成当地作物识别:换到另一地区、季节或影像来源,仍需要检查波段、标签与数据分布,不能把美国案例直接当作中国农田的效果证明。
为什么架构图的左右两边都是影像
下图左侧是一叠多期影像,经过三维切块后,一部分片段被遮住,编码器处理可见部分,解码器再重建缺失内容。时间、经纬度信息通过上方的编码路径加入。图右侧的重建影像说明的是预训练任务,并不是已经分好作物类别的结果。
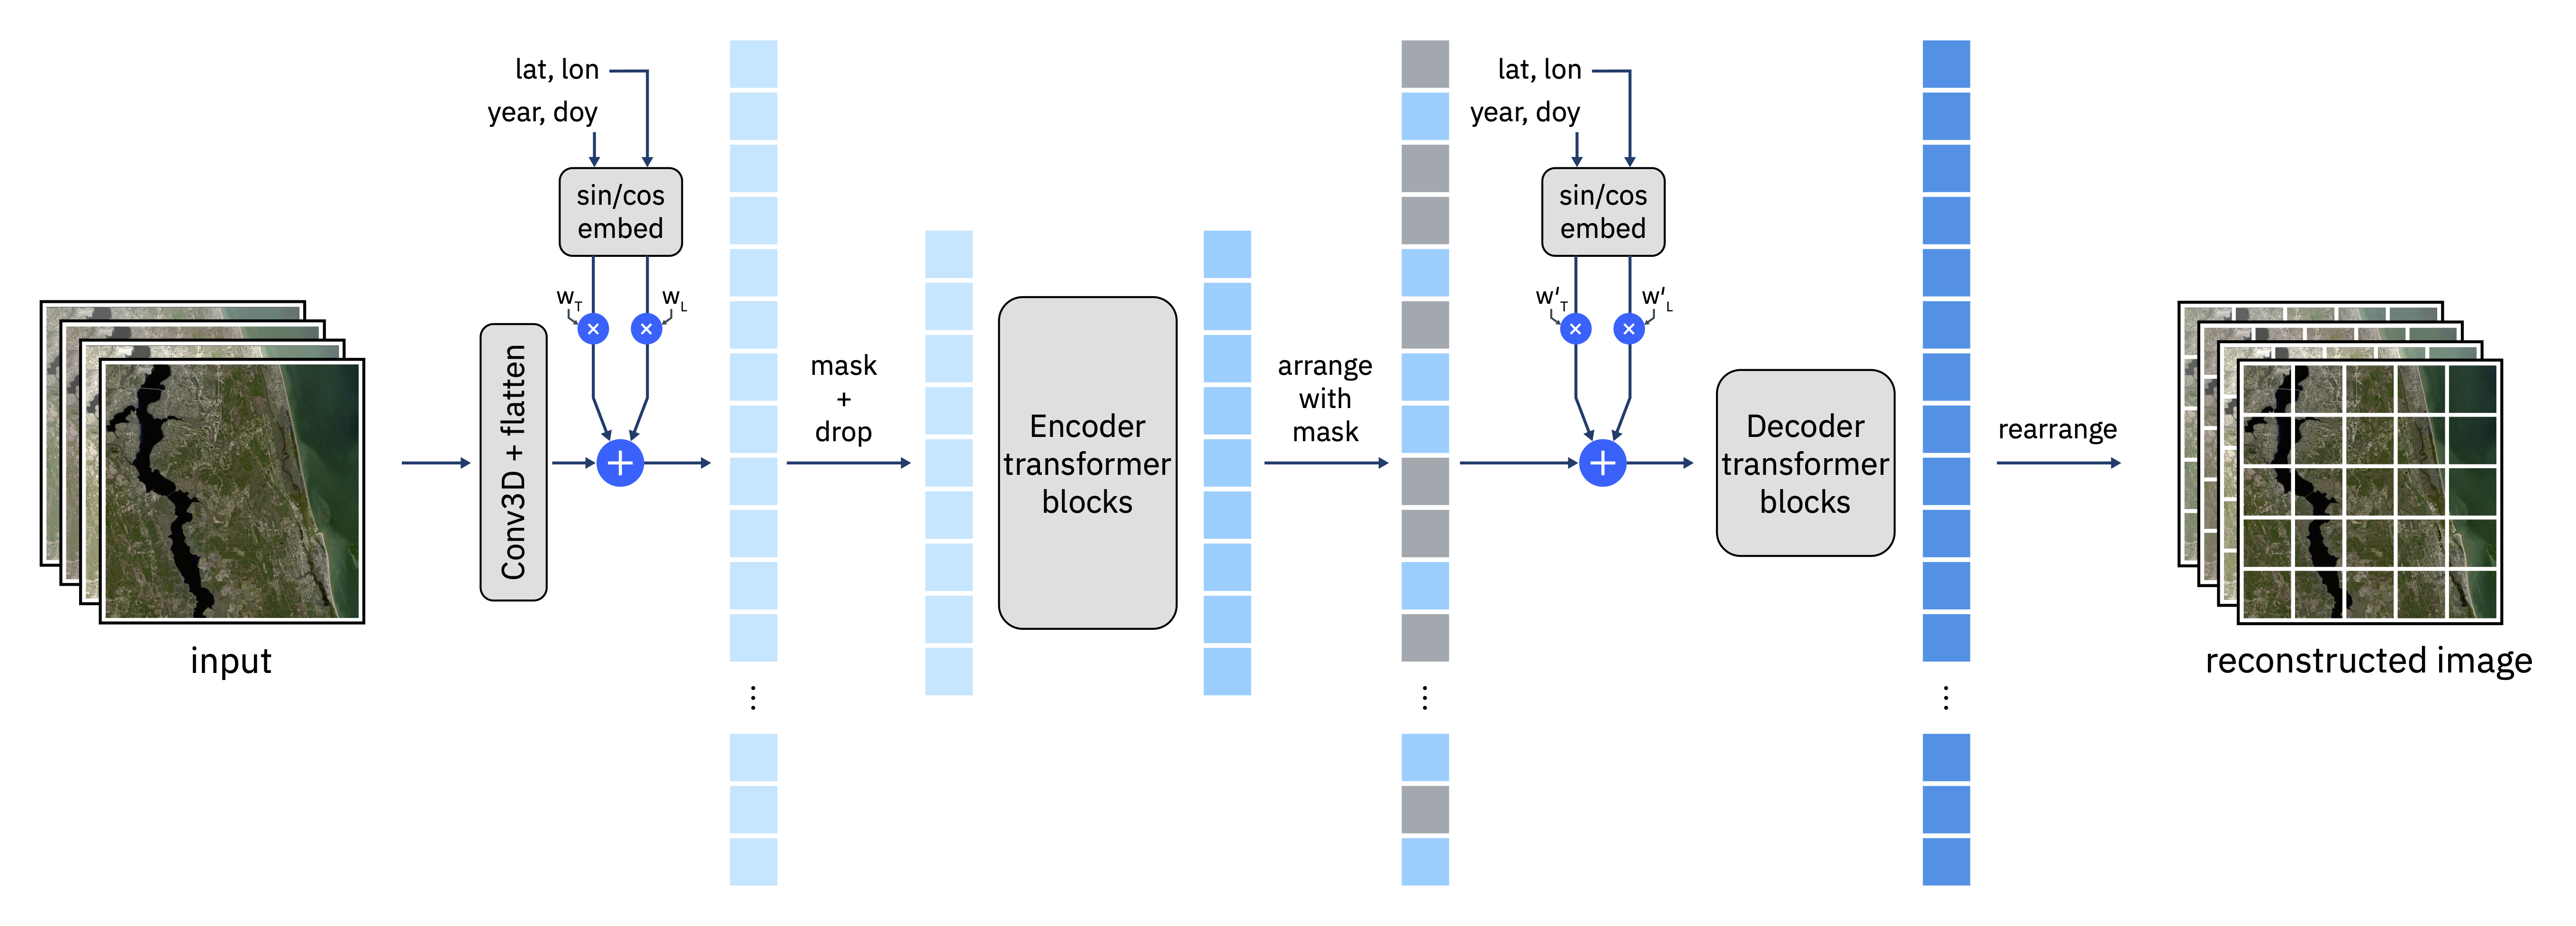
官方架构示意,来源:NASA IMPACT 项目仓库;英文标注,可打开原图查看完整流程。
这种遮罩重建训练先教模型利用影像的空间与时间关联,下游任务再利用学到的表示。三维切块同时包含时间与空间维度,所以多期材料不是随手叠放的几张独立图片。
也要注意型号后缀:TL 版本加入时间与地点编码;预训练时还会随机丢弃这类元信息,让模型学习处理元信息缺失的情形。不能把 TL 的特性无差别写到所有型号上。当前模型卡还列有不同规模的权重,选择时应核对具体型号。
研究成绩不等于影像变得更清晰
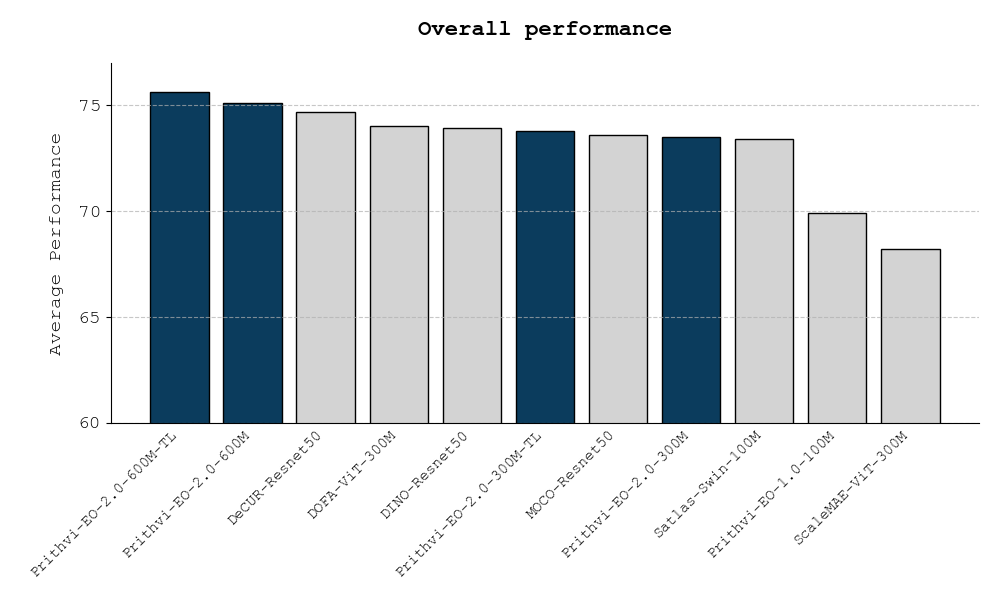
模型使用 NASA 的 HLS 多时相样本预训练,材料的空间尺度为 30 米。论文当前版本描述了全球采样、预训练以及 GEO-Bench 和具体下游任务的评估。GEO-Bench 比较需要为不同任务接上分类或分割部分,并进行微调,评估的是这些任务上的结果。
封面使用的官方汇总图,比较的是一组遥感任务的平均表现;它没有回答模型在某块新农田上能否分对。
所以,即使论文讨论了不同分辨率数据上的迁移表现,也不代表模型能把 30 米卫星影像凭空还原成亚米级真实细节。重建演示、作物分割、洪水识别是不同任务;看到漂亮的重建图,不能顺手推导出分割已经准确。
我会把它推荐给需要比较多期遥感表示、或手头已有标注影像的学习者:先选官方同类任务,理解从影像序列到标签图的转换,比直接套一串性能数字更有收获。只想浏览某个地点的最新卫星图,则不需要从这个训练框架开始。
代码、权重与数据,各有自己的入口
项目仓库提供 TerraTorch 配置和 notebook,代码采用 MIT;所引 300M 权重模型卡标注 Apache 2.0,两者允许依条款商业使用,但不是同一份许可证。HLS 原始资料与各下游标注集也要分别查阅条件,不能从权重开放推出全部数据都可不受限制地使用。
需要开始研究时,沿农作物分割 notebook 选定具体权重、准备同一地点的多期多波段影像与标签即可。它降低的是从头学习遥感表示的起点,具体地区能识别到什么程度,仍要由对应任务的验证结果回答。
以上为编辑整理,功能、许可与使用条件以官方说明为准。