
两版提示词逐题放在一张表里,Promptfoo 还能检查输出条件
为什么值得关注
让提示词调整拥有重复输入与清晰检查项,不再只靠手工粘贴问题比较聊天记录。
适合谁:需要批量比较提示词或模型配置、希望把输出要求写成测试条件的开发者
这次有哪些亮点
- 每个提示词、模型和测试输入形成组合,网页查看输出
- contains/icontains或模型rubric可写成断言,结果可导出
使用前需要知道
CLI仓库MIT,当前README说明项目已加入OpenAI;调用外部模型仍需凭据、费用并向提供方发送输入。断言通过只证明对应条件,成本和延迟断言检查已完成调用,不会封顶预算或中止慢请求。
同一个问题试两句提示词,再换两个模型,手工打开聊天窗口很快就会失去对应关系:这条答案用了哪版模板?上次输入是否完全相同?Promptfoo 把这些组合写进配置,并把逐题结果放到一起比较。
当前仓库说明写明项目已加入OpenAI,同时继续以MIT许可开放CLI代码。开源工具本身与所调用模型的服务条件,需要分别看。
先固定输入,再比较模板
入门文档用翻译任务举例:prompts放提示词模板,使用双花括号变量;providers放要调用的模型或应用;tests提供language、input等具体值。
运行eval后,工具测试每个提示词、模型与用例的组合。若同一输入配两版提示词和两个provider,就有四种输出可比较;增加用例,矩阵也随之扩展。这里描述组合关系,没有实际发起这些模型调用。
它最直接的价值是把问题固定下来。修改模板后可以重跑同一组输入,减少“新版用了更简单问题,所以看起来进步了”的错觉。
给明确要求写断言,也留出阅读空间
文档中的法语例子使用contains,检查是否包含指定译文;西班牙语例子使用icontains,忽略大小写检查。测试可以带断言,也可以只产出回答供人查看。
对于必须返回某个字段、包含某条约定文字的任务,明确条件有助于快速筛出失败项。但一句译文包含目标词,不等于语义、语气和上下文全部正确。断言通过,应该被理解为这一条检查通过。
更复杂的要求可用llm-rubric等模型评分方式表达,这会引入另一层模型判断和调用成本,不能把它当成不花费用、毫无波动的程序规则。
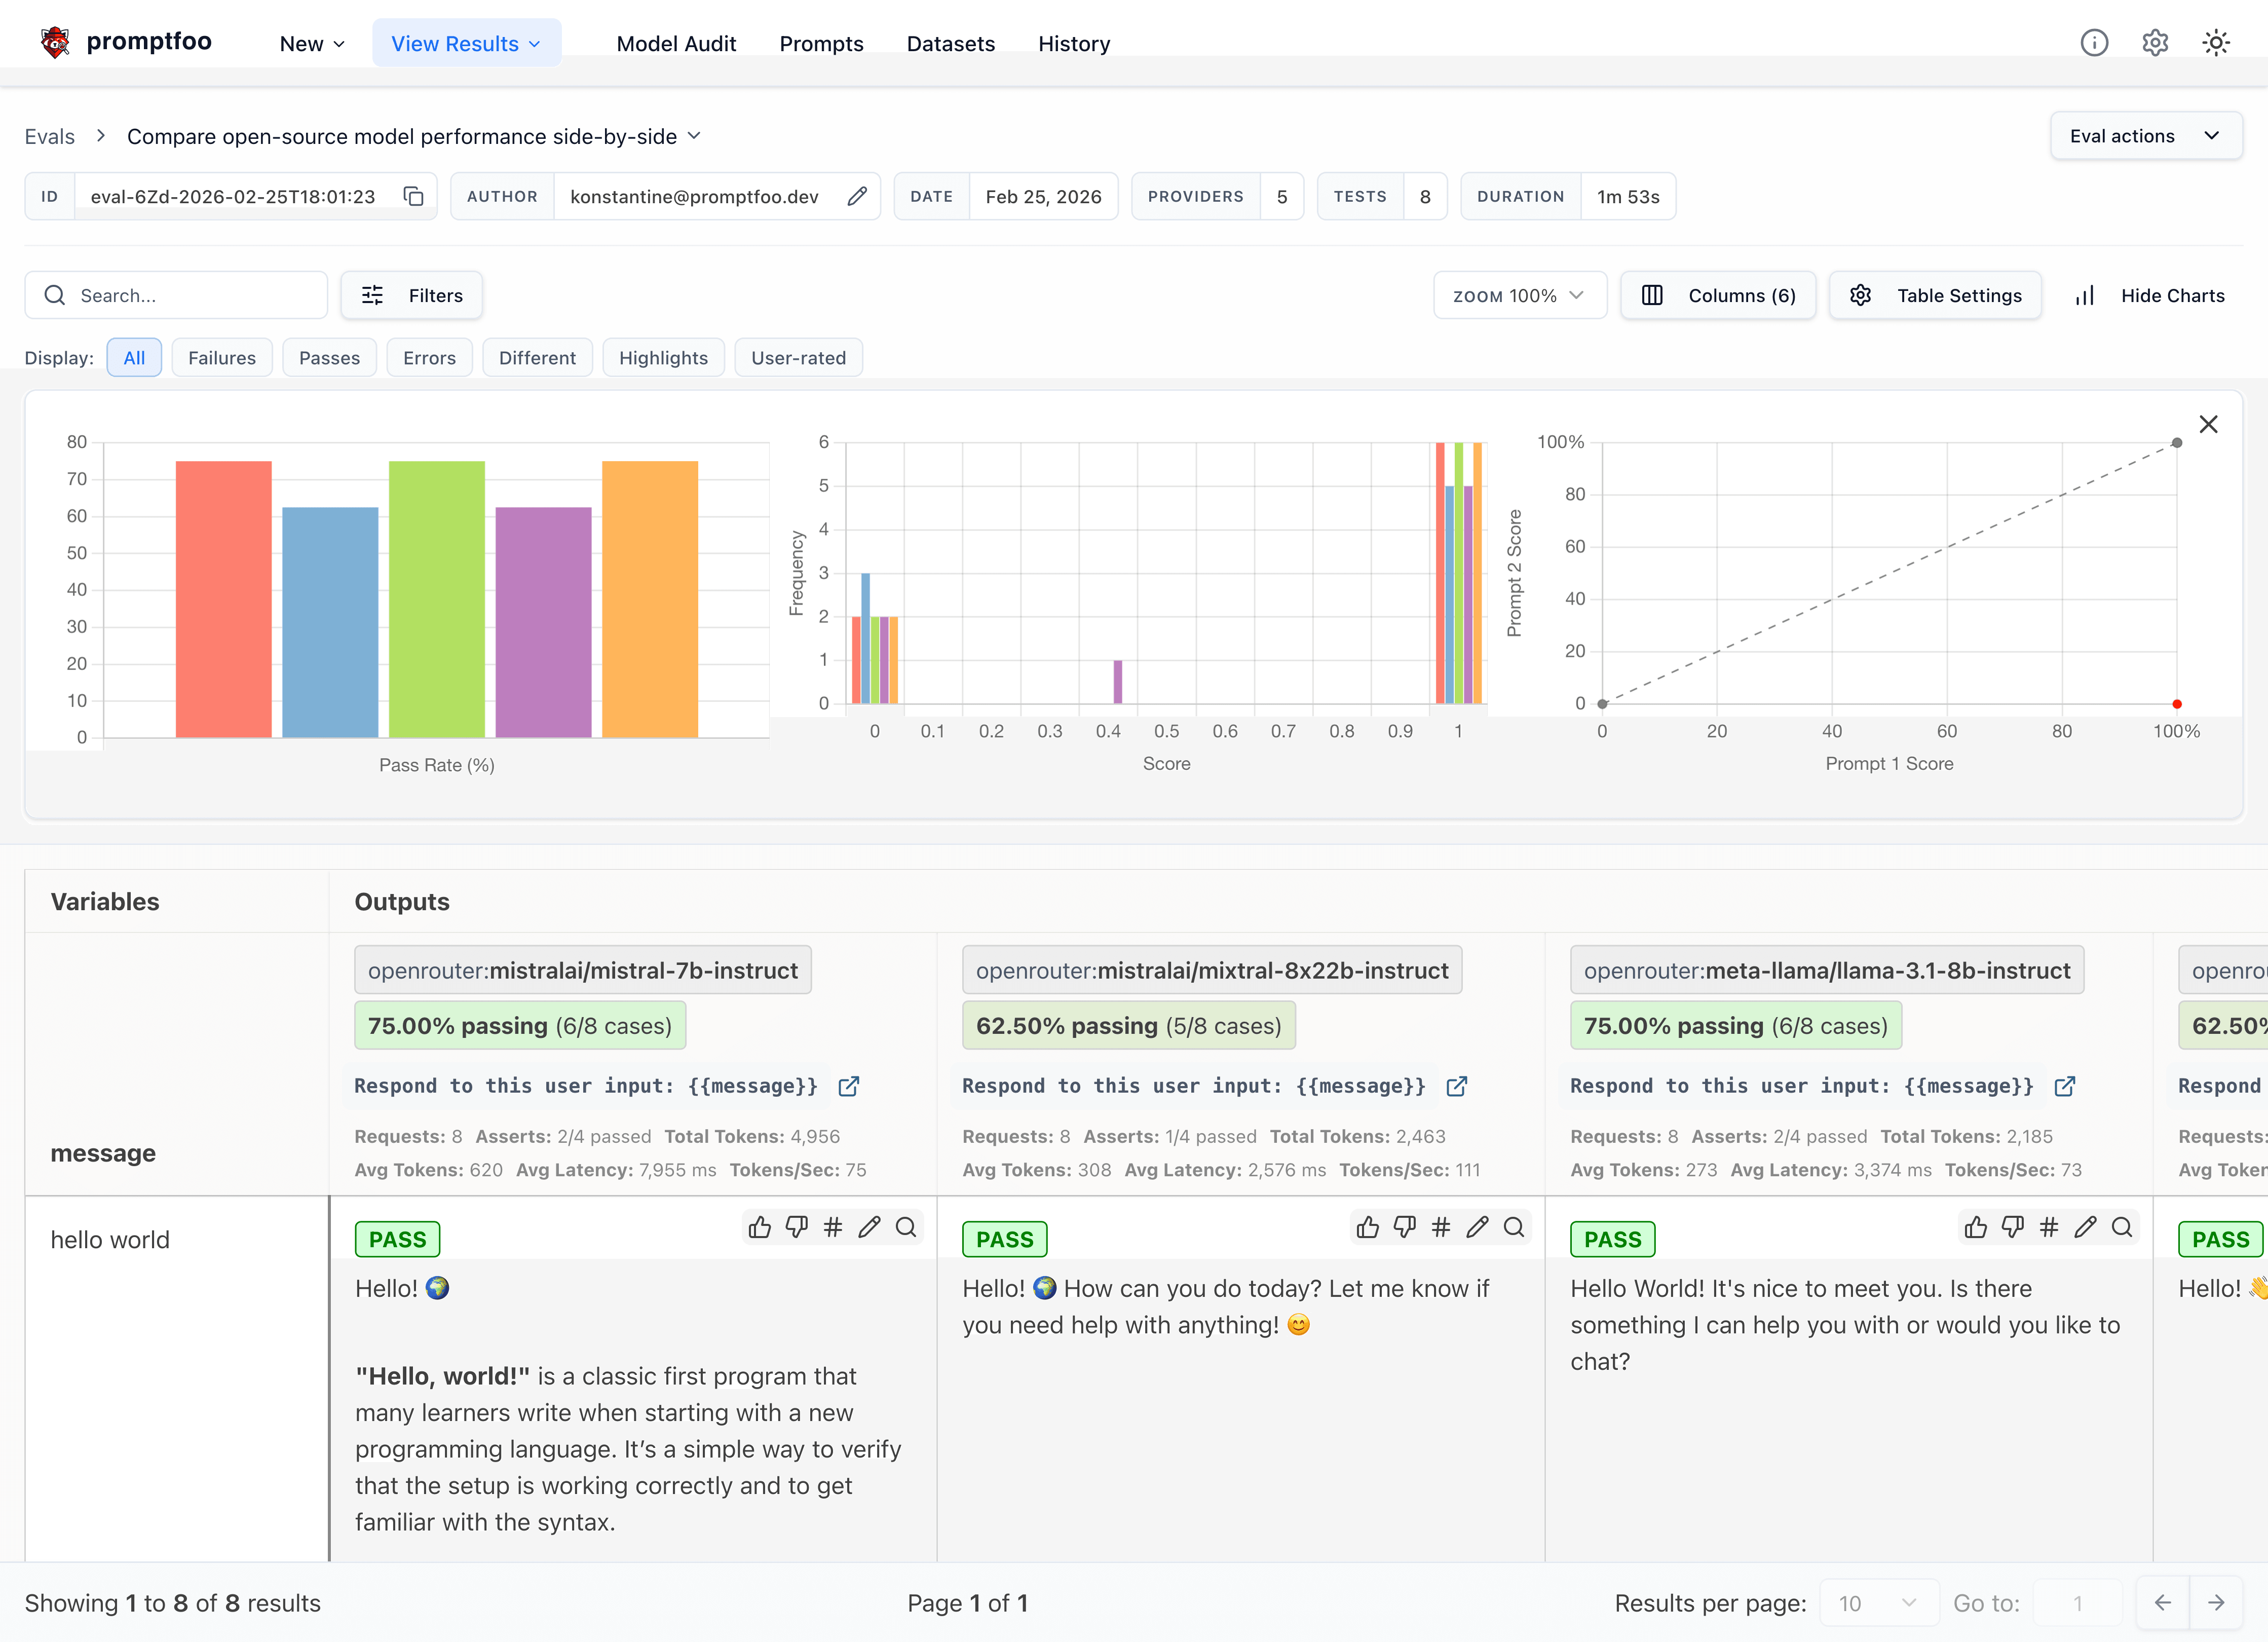
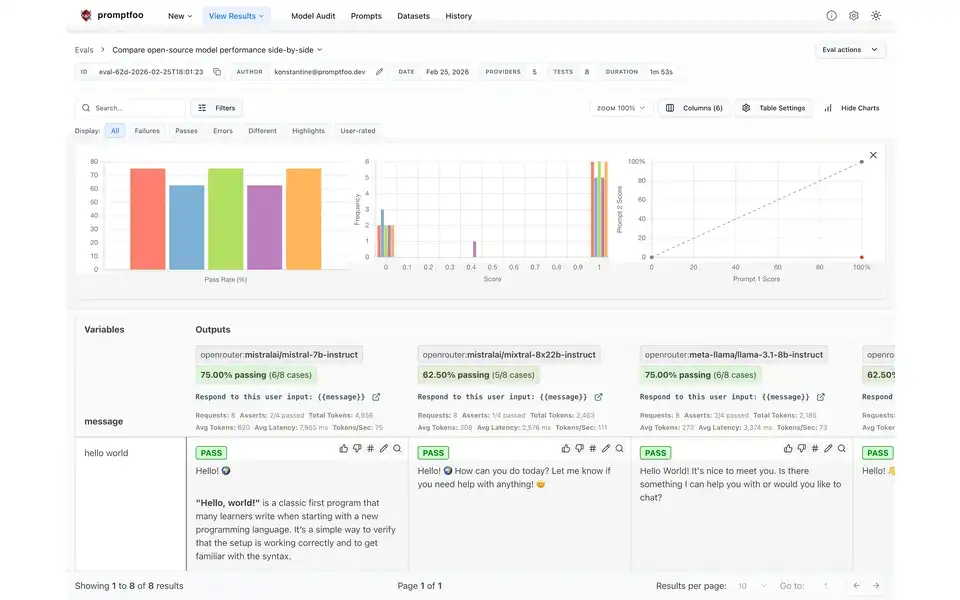
官方界面样例,展示按输入逐列查看不同provider的回答及通过状态;图中模型和数字只用于说明界面,不是本文实测或当前模型排名。
表格用来找到差异,输出还能继续流转
评测后运行view,可以在网页中查看结果。文档还列出电子表格、JSON、YAML和HTML等导出方式,适合将需要人工复核的样本交给同事,或保留下一轮要回看的失败项。
成本与延迟也能作为断言,但官方特意指出:它们检查的是已经完成的响应,不能封顶支出,也不会自动截断慢请求。组合数和裁判调用都应在运行前估算,不能等红色失败格出现才当预算控制。
CLI可以在本地运行,连接外部provider时输入仍会发往对应服务。凭据、数据与模型费用随所选provider确定。Promptfoo交付的实用成果,是一组可重复的测试输入、一张能逐题比对的输出矩阵,以及那些明确写下来、下次还会检查的条件。
以上为编辑整理,功能、许可与使用条件以官方说明为准。