
ProPainter:移除视频里的人物,还要让下一帧接得上
为什么值得关注
利用视频前后帧的对应信息修补被遮区域,能把镜头清理从单帧美化推进到连续画面的协调。
适合谁:研究非商业视频物体移除、能准备逐帧遮罩并具备 GPU 环境的影像创作者与研究者。
这次有哪些亮点
- 结合图像与特征传播,利用跨帧信息补全视频
- 遮罩引导的稀疏视频 Transformer 细化传播结果
- 支持分段、半精度等显存节省选项
使用前需要知道
代码和模型限 S-Lab 非商业使用,商用需许可;输入需视频与遮罩,高分辨率视频有显存门槛,未见背景不保证真实重建。
一段冰场视频里,滑行者不断换位置。把他从某一张画面里删掉不难理解,但连续播放时,冰面不能跟着一闪一闪,场边围挡也不能忽然断开。ProPainter 面向的正是这种视频修补:输入视频和对应的遮罩,输出目标被移除、缺口得到补全的连续画面。它适合想研究镜头清理的人,尤其值得用来理解视频处理为什么不能简单照搬逐张修照片。
先看绿色遮罩下面补了什么
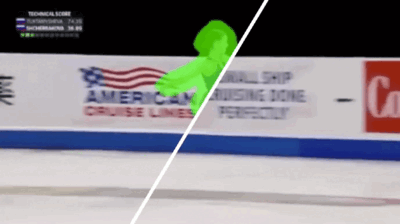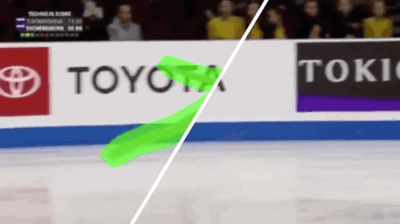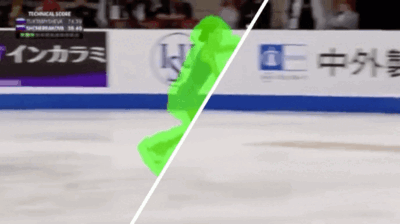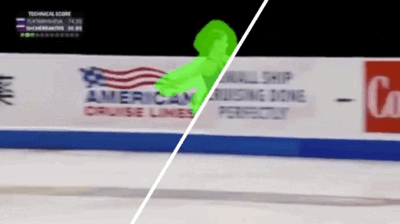
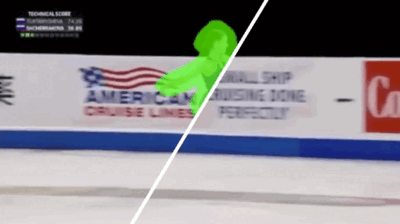
这是官方仓库的 object_removal1.gif。白色斜线的一侧能看到覆盖滑行者的绿色人形区域,另一侧展示修补后的冰面;绿色表示要移除的位置,不是要保留的主体。观看时应沿着人物移动的位置看过去:人物所在处变成冰面,靠近场边时还涉及蓝色边沿和广告围挡。这组动画是作者选出的官方示例,本文没有重新运行,也没有制作新的移除结果。
图里的难点随时间变化。人在某一帧挡住的冰面,可能在前后帧露出来;镜头移动时,同一块背景又不在同一个像素位置。如果每帧各自补一块“看着像冰”的纹理,暂停时可能过关,播放时却会暴露纹理跳动。视频清理要同时回答两个问题:这一帧补什么,以及它与前后的画面是否对应。
这也是我选择这段官例的理由。冰面本身相对平整,读者容易辨认移除的目的;围挡上的线条又给了一个更严格的观察位置。动画能说明官方展示了连续修补,却不足以保证所有高速运动、遮挡和复杂背景都能同样自然,更不能从这张小尺寸 GIF 推断高清原片的细节质量。
它会利用其他帧,而不是每帧重新猜
官方方法包含运动信息补全、图像与特征两个层面的传播,以及由遮罩引导的稀疏视频 Transformer。用画面来理解:先估计内容怎样移动,再把其他时刻可用的信息对齐到缺口附近,最后结合多个时刻的信息细化结果。所谓时间传播,价值就在于利用视频已经拍到的内容,减少各帧孤立生成带来的不一致。
其中的“运动信息”并不是另一个待删除物体,而是像素或结构如何从一帧移动到另一帧的对应关系。估计不准,就可能把纹理移错位置;官方提出双域传播也是为了更可靠地利用这些对应关系。这种设计有助于理解它的用途,但不能推导出从未露出的背景必然能被真实重建:当所有帧都缺少某处信息时,仍需要生成补全。
类似地,清理自摄镜头里的临时路障可以作为教学用途:给出短视频,为路障准备逐帧遮罩,拿到修补后的视频,再沿道路边线检查连续性。这是采用思路,本文冰场官例并没有展示路障效果。项目的基本输入是 mp4 或拆分帧,加上逐帧遮罩;遮罩是否追得住目标,仍然影响最终结果,模型并不会自动理解你想删谁。
先决定用途,再决定运行方式
官方仓库提供模型下载、示例输入和推理脚本,也链接作者维护的 Hugging Face 交互演示。演示入口适合先认识选择目标的流程;本地处理则需要准备视频与遮罩,配置 PyTorch、CUDA 等环境,并取得修补及运动估计相关权重。这里没有核验线上队列或收费安排,不能把有演示链接等同于随时免费处理长片。
显存是实际门槛。README 的估算表中,720×480、80 帧子视频使用半精度约需 8G 显存;这是官方给定设置下的估计,不是所有素材的最低配置保证。降低分辨率、缩短子视频、减少参考帧可以节省资源,也改变可用的时间信息。先取一段有代表性的短片检查,远比直接整段高清长视频更容易看清取舍。
最后要注意,它的代码与模型按 NTU S-Lab License 1.0 提供,限非商业用途,商业使用需要另行取得许可。因此这里把它作为视频修补模型项目介绍,不能因为仓库公开就推荐为可直接接商业订单的免费工具。非商业研究者可以从官方示例理解能力;准备投入收费后期流程的团队,许可应在采用前解决。
参考资料:
以上为编辑整理,功能、许可与使用条件以官方说明为准。