
pyVideoTrans:给外语视频做中文字幕,校对后再接配音
为什么值得关注
让原文识别、中文字幕与配音各自可校对,减少前面错误沿制作流程继续传递。
适合谁:需要给授权视频制作字幕或多语言配音的培训、运营与视频创作者
这次有哪些亮点
- 独立提供语音转录、字幕翻译与文字配音入口
- 识别、翻译、配音阶段可暂停校对
- 字幕与语音完成后再处理音画对齐及合成
使用前需要知道
代码GPL-3.0;模型权重、声音与API条款分别判断,在线服务可能计费;本地程序不保证整条流程离线,字幕与配音仍需校对。
一段外语操作视频,要给同事做成中文字幕版,最容易返工的地方往往是前面的听写:产品名听错了,后面翻译和配音会把错误继续带下去。pyVideoTrans 把语音转写、字幕翻译、配音和视频合成接在同一个工具里,也允许在中间暂停修改。对需要交付可编辑字幕和本地成片的人,这种分阶段处理比一次输出到底更有用。
交付物可以停在字幕这一步
例如,假设你拿到一段有使用授权的英文设备操作录像,要交给中文售后团队。输入是原视频,第一份应检查的结果是带时间轴的原文字幕;确认型号、数字和操作动词后,再把它译成中文,输出字幕文件。只有培训材料确实需要中文旁白时,才进入语音合成,最后将音轨和画面合并。这是任务示例,并非本文的实际生成结果。
官方中文说明提供了独立的语音转录、字幕翻译和文字配音入口。已有 SRT 的人可以直接翻字幕;只要逐字稿的人也可以止步于转录,无须顺便制作一段新视频。这里的 SRT 是带起止时间的文本,后续仍能交给字幕或剪辑软件修改。
界面里的三行设置,各管一件事
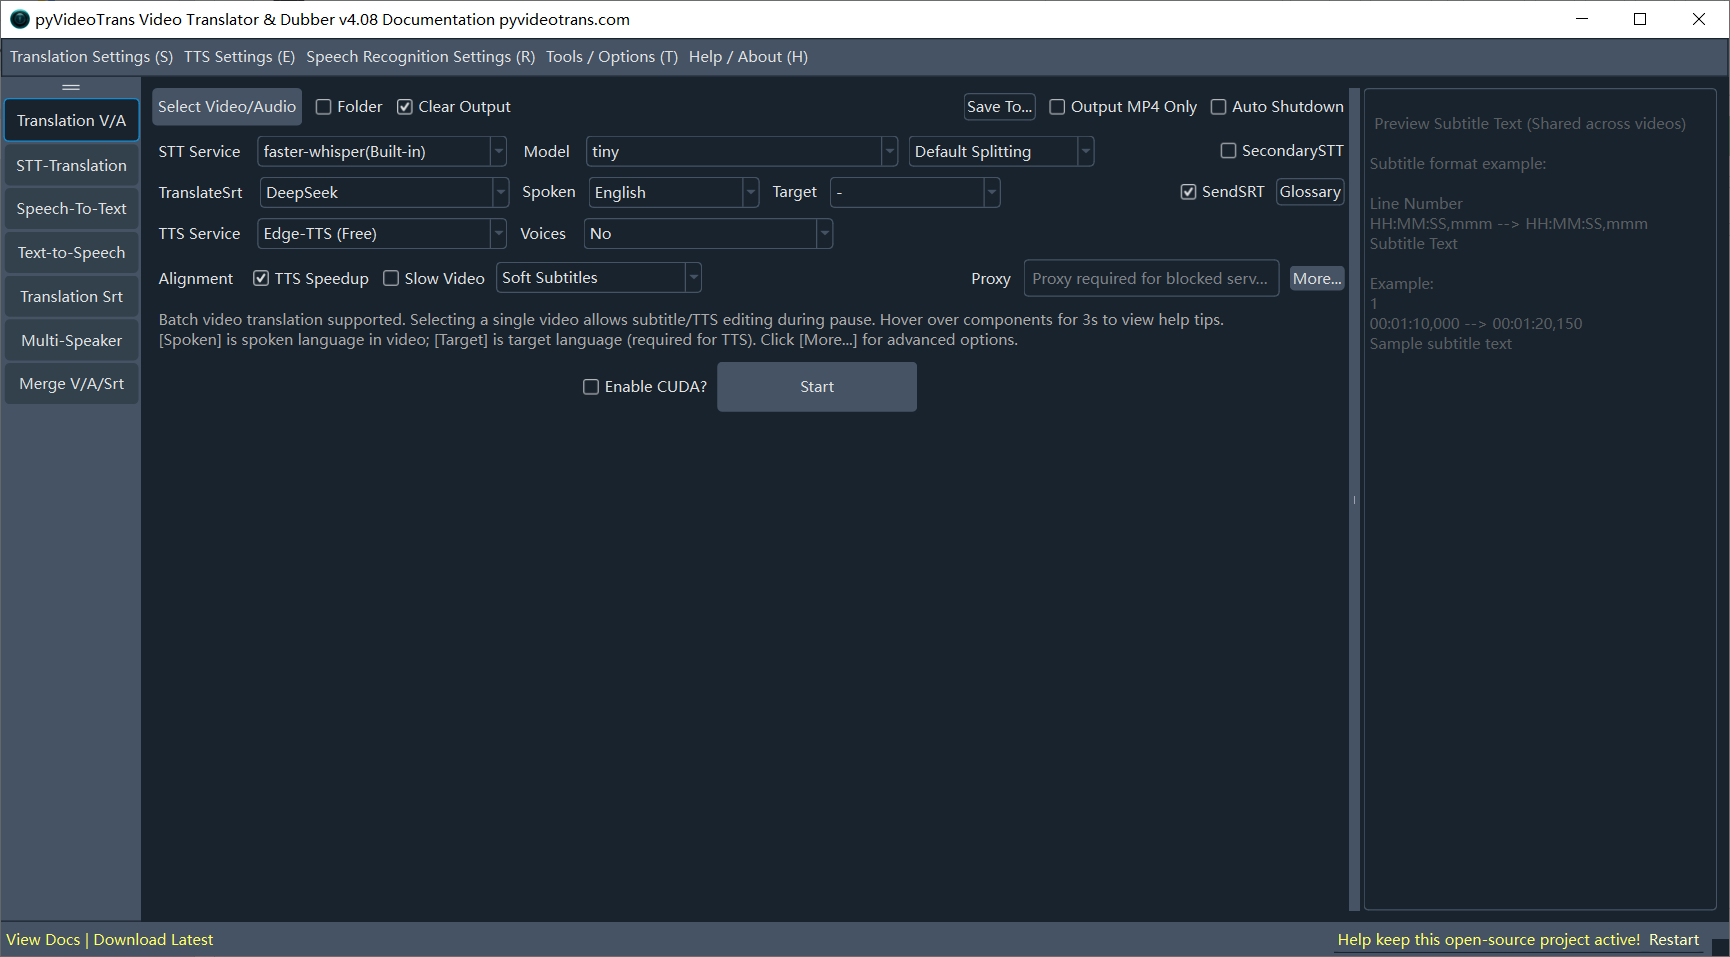
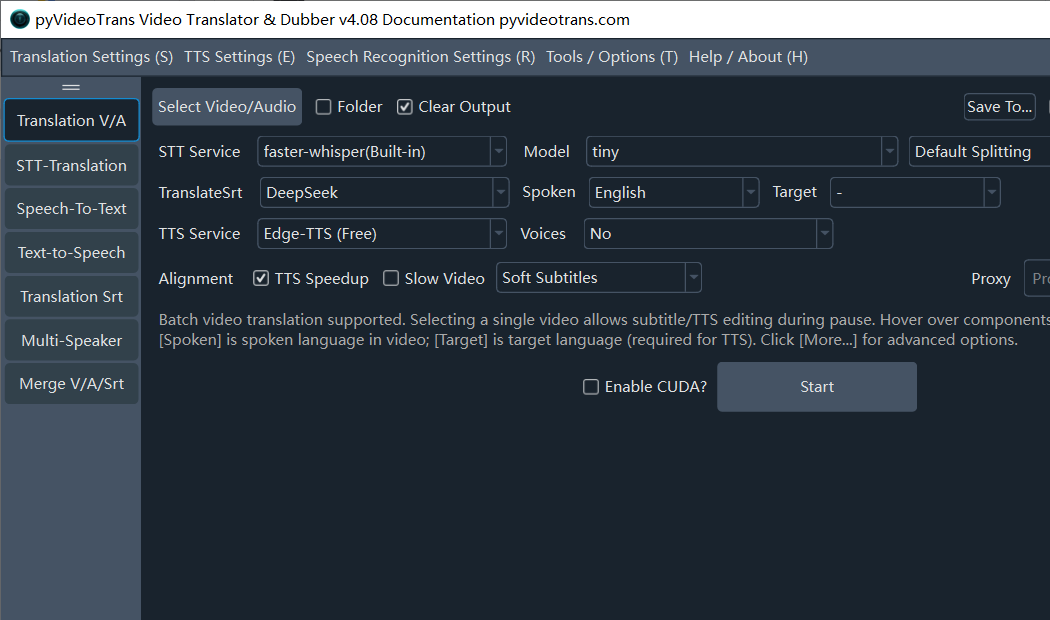
官方 README 截图,标题栏为 v4.08。STT Service、TranslateSrt、TTS Service 分别对应识别、翻译、配音;画面展示设置关系,没有展示中文成片质量。可打开原图查看界面细节。
这张图值得注意的是,识别选了本地 faster-whisper,翻译选了 DeepSeek,而配音服务又是另一项。它们是可以分开配置的环节,不能把某个模型的能力算给整条流程。截图中的 Voices 为 No,也提醒我们:选了配音服务,不等于当前任务一定会生成新声音。
架构说明进一步解释,原文与目标语言不同时才需要翻译,选定配音角色后才进入 TTS;字幕、音频和视频最后由合成环节组合。这给排错提供了具体位置:中文台词内容错,检查原文识别和翻译;文字正确但读音错,检查配音;声音赶不上镜头,则检查对齐。
人工校对的位置决定返工成本
延续前面的设备录像示例,假设原声说的是型号“AX-15”,识别结果却变成“AX-50”,应在原文阶段纠正,而不是等配音完成后再改中文字幕。又如,一个警示句被拆成两条字幕,单看每条都通顺,合起来却漏掉否定词,就需要对照完整语句和原声检查。软件允许在识别、翻译、配音阶段暂停校对,价值正在这些具体修改处。
配音还有时间约束。同一句话译成中文后,合成语音的长度可能改变;工具提供配音加速、视频慢放等对齐方式。它们改变播放节奏,并不能自动保证解说自然。含有按钮操作、口型或演示动作的片段,尤其应逐段试听和对画面;需要保留原讲者声音时,字幕版可能已经是更合适的交付。
本地运行与外部调用要逐项看
本地 faster-whisper 路线需要准备模型文件和计算资源;翻译可以选择本地 Ollama 等路线,也可以调用在线服务。调用云端识别会向对应服务发送音频,云端翻译会发送字幕文本,云端 TTS 会接收待朗读文本;所以“程序在电脑上运行”不能推导出材料从不离开电脑。
仓库的代码许可证为 GPL-3.0。它与集成模型的权重许可、第三方 API 的费用和可用地区是不同问题。README 将 Edge-TTS 标为免费接口,也不能据此把它称为离线语音模型,更不能承诺接口长期可用。处理内部培训材料时,应逐个确认所选服务,再决定上传范围。
从一段短片开始配置
Windows 用户可以从官方 Releases取预打包版本,解压到不含中文和空格的路径,运行 sp.exe。macOS、Linux 或需要源码运行的人,按中文 README 准备 Python、FFmpeg 与依赖;显卡加速还有单独条件。
第一次使用,适合拿一段包含术语和完整句子的授权短片,先检查原文 SRT,再检查中文表达,最后决定是否配音。pyVideoTrans 的选择价值,是让这几份产物各自可检查、可修改,再组合成交付版本;它不替你作出术语、声音和发布权限的最终判断。
以上为编辑整理,功能、许可与使用条件以官方说明为准。