
Qwen3-TTS:有录音、只有声音描述、想选现成音色,分别用哪一个模型
为什么值得关注
同一模型家族分别接收参考录音、声线描述或预置说话人,创作者可以按手头材料开始,并把设计出的角色声音交给克隆流程继续使用。
适合谁:中文解说、角色配音创作者,以及选择本地语音模型的开发者
这次有哪些亮点
- Base 以参考音频和转写克隆声线并朗读新文字
- 1.7B VoiceDesign 按文字设计声音,CustomVoice 提供九位预置说话人
- 设计出的短参考音频可交给 Base 建立复用声音提示
使用前需要知道
未生成或听验中文样例,不作效果测评;演示当前服务状态未验证,本地算力与 API 计费分开,参考声音须有权使用。
做一段中文解说时,“让它说这句话”其实可能是三种任务:沿用你已有的录音声线,描述一个尚不存在的角色声音,或者直接挑一位预置说话人。Qwen3-TTS 把这三条路做成不同模型。先按手头材料选对入口,比先比较参数大小更能决定能否做成想要的音频。
先读四象限图,别把家族能力塞给一个模型
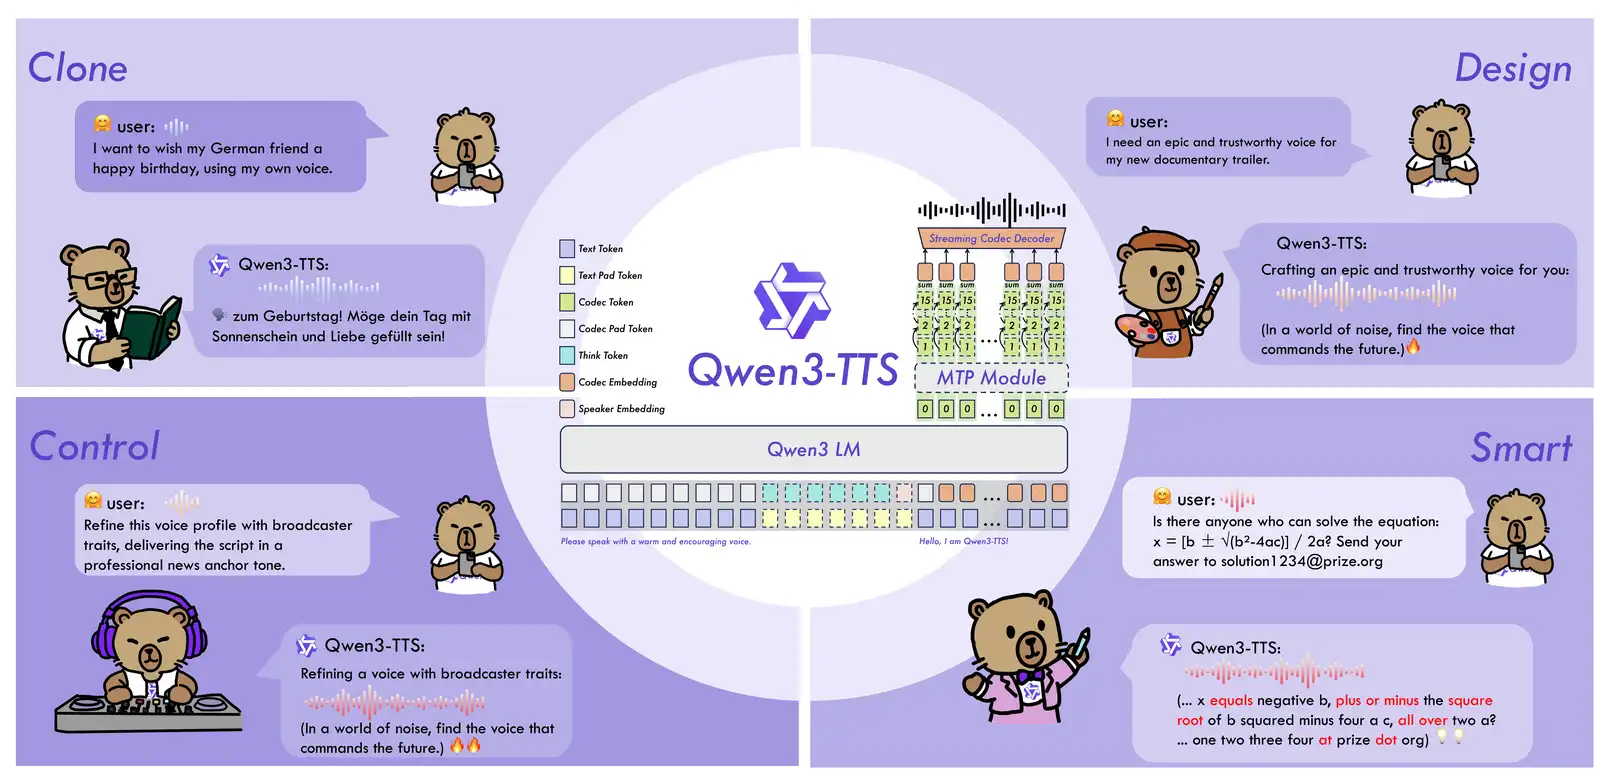
官方图左上 Clone 是拿录音保留说话人特征,右上 Design 是用文字描述设计声线,左下 Control 是控制说话方式,右下 Smart 则示意公式、邮箱等文字如何进入语音表达。它是家族能力说明图,不是本文中文任务的输出记录。手机上可打开完整原图看标签;真正选模型仍要对照下面的具体型号。
有自己的参考录音,走 Base。 Qwen3-TTS-12Hz-1.7B-Base 和 Qwen3-TTS-12Hz-0.6B-Base 接受参考音频与对应转写,再合成新的目标文字。官方称支持约三秒参考的快速克隆,这说明输入可以很短,不能理解为任意三秒素材都能同样还原。参考音频可以是本地文件等格式;只提取说话人特征的模式可以不交转写,但官方明确提示克隆质量可能降低。
没有录音,只有声音设想,走 VoiceDesign。 本文对应的是 Qwen3-TTS-12Hz-1.7B-VoiceDesign,输入目标文字和自然语言声音描述。它解决的是“我想要怎样的声音”,不要求先找到某个人的录音。当前已发布列表中没有对应的 0.6B VoiceDesign,不能看到家族有小模型就自行替换名称。
只想尽快选一个现成声音,走 CustomVoice。 Qwen3-TTS-12Hz-1.7B-CustomVoice 提供九位预置说话人,并支持指令控制表达。0.6B CustomVoice 同样提供预置说话人,但官方模型表没有给它标注指令控制能力;两者不能只按“大的更好、小的更省”来概括。CustomVoice 里的 Custom 也不表示上传录音克隆,克隆要回到 Base。
用一段中文解说,把选择落到材料上
假设要做一段博物馆展品介绍:“请看这件青铜器,器身上的纹样记录了当时的工艺。”这是教学输入,本文没有生成或听验相应音频。若已有获授权的讲解员录音,任务是延续该讲解员的声线,就选 Base,并准备录音转写。若角色还没确定,只知道希望声音“沉稳、语速适中、带一点讲述感”,则选 VoiceDesign,把这些要求和展品文字分别提交。
若只是要先给视频粗剪配一条解说,可从 CustomVoice 的现成说话人开始。官方把 Serena 描述为温暖柔和的中文年轻女声,把 Uncle_Fu 描述为低沉醇厚的成熟男声;这些是官方角色描述,是否适合你的展品仍需试听。README 也给出中文文字、说话人 Vivian 和愤怒语气指令的完整调用示例,说明文本、声线与表达要求在接口上是分开的,不应把语气指令混进要朗读的台词。
如果 VoiceDesign 设计出喜欢的角色,还想让它继续读多段内容,官方提供“先设计,再克隆”的流程:先生成短参考音频,再交给 Base 建立可复用的声音提示。对连续角色配音,这比每条台词都重新描述声线更值得研究;不过流程存在不等于跨集一致性已经由本文验证。
从哪里开始,投入由哪部分产生
普通读者可以先到官方 Hugging Face 或 ModelScope 演示页,拿一段含人名、数字和停顿的真实稿件试听。两处入口都由仓库列出,本文未验证当下排队或服务可用性。需要本地控制时,再使用 qwen-tts 包与对应权重;官方推荐独立 Python 3.12 环境,示例使用 CUDA,并推荐兼容硬件上的 FlashAttention 2。开放下载并不免除显存、运行时间或云算力成本。
仓库代码采用 Apache 2.0,本篇涉及的三个 1.7B checkpoint 的官方模型元数据也标注 Apache 2.0。这里介绍本地模型路线,不能把它等同于 DashScope API 的计费或服务承诺。参考声音还需要有权使用。对这组模型最实际的判断顺序是先确定声音从哪里来,再试听中文稿件的读法,最后决定是否值得把它接入持续制作流程。
参考资料:
以上为编辑整理,功能、许可与使用条件以官方说明为准。