
RFdiffusion:保留关键片段,为蛋白质重新设计骨架
为什么值得关注
把功能片段、长度与对称性转成生成条件,使研究者能围绕局部需求探索多种蛋白质骨架。
适合谁:对蛋白质生成有兴趣的 AI 读者、学习结构设计的科研学生
这次有哪些亮点
- 用条件扩散生成蛋白质骨架
- 可保留指定片段并生成周围结构
- 原论文对部分设计进行了结构与功能实验表征
使用前需要知道
原始 RFdiffusion 主要生成骨架,后续还需序列设计、计算筛选与实验检验;不同任务可能需要不同模型权重。
如果已经知道一个蛋白质中必须保留的小片段,能不能围绕它设计一副新的三维骨架?RFdiffusion 把这个问题变成生成任务:给出固定片段、长度或对称性等条件,从随机噪声逐步构造蛋白质骨架。它值得关注的地方,是把设计需求变成空间约束,让模型探索多种可供后续筛选的形状。
这里介绍的是 RosettaCommons 仓库中的原始 RFdiffusion 路线,对应 2023 年发表的研究。它适合想看懂蛋白质生成原理的 AI 读者,以及正在学习结构设计的人;不能将它与后续同系列模型混称为刚发布的最新版本。
从散乱坐标到有条件的结构
扩散模型在图像中逐步去除噪声,在这里处理的则是氨基酸残基的空间位置与朝向。训练时,研究者扰动已知蛋白质结构,让模型学习恢复;生成时,从随机状态出发,反复提出更合理的结构。指定了必须保留的片段后,生成过程就要围绕这部分信息展开。
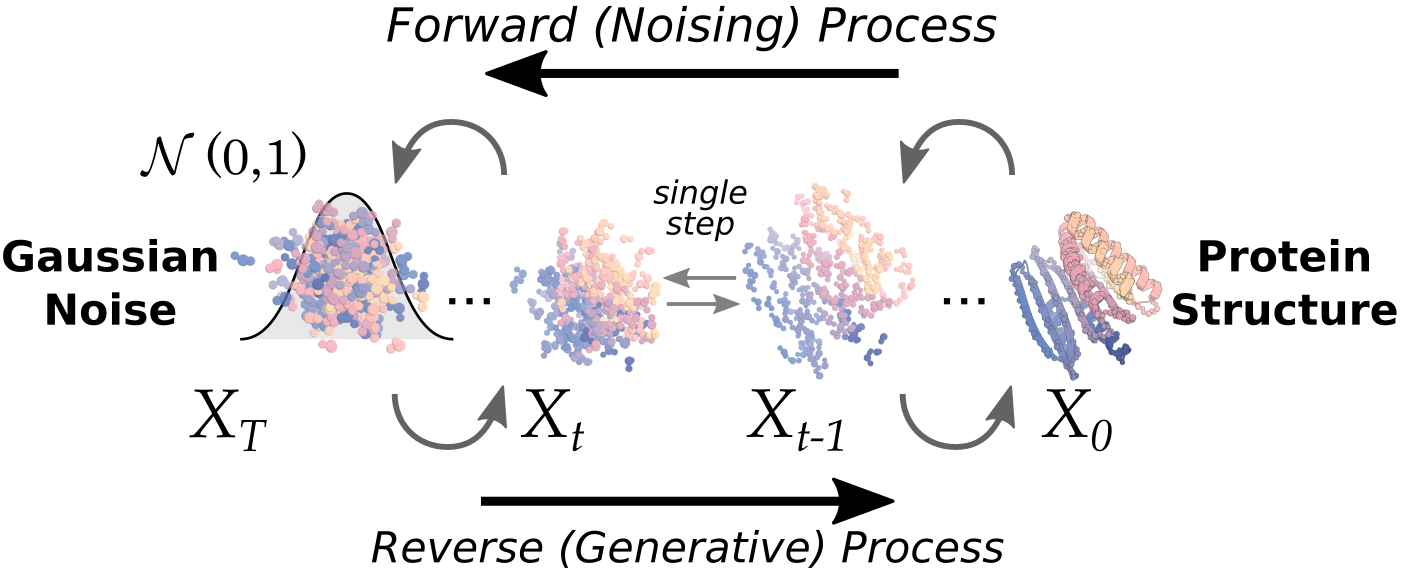
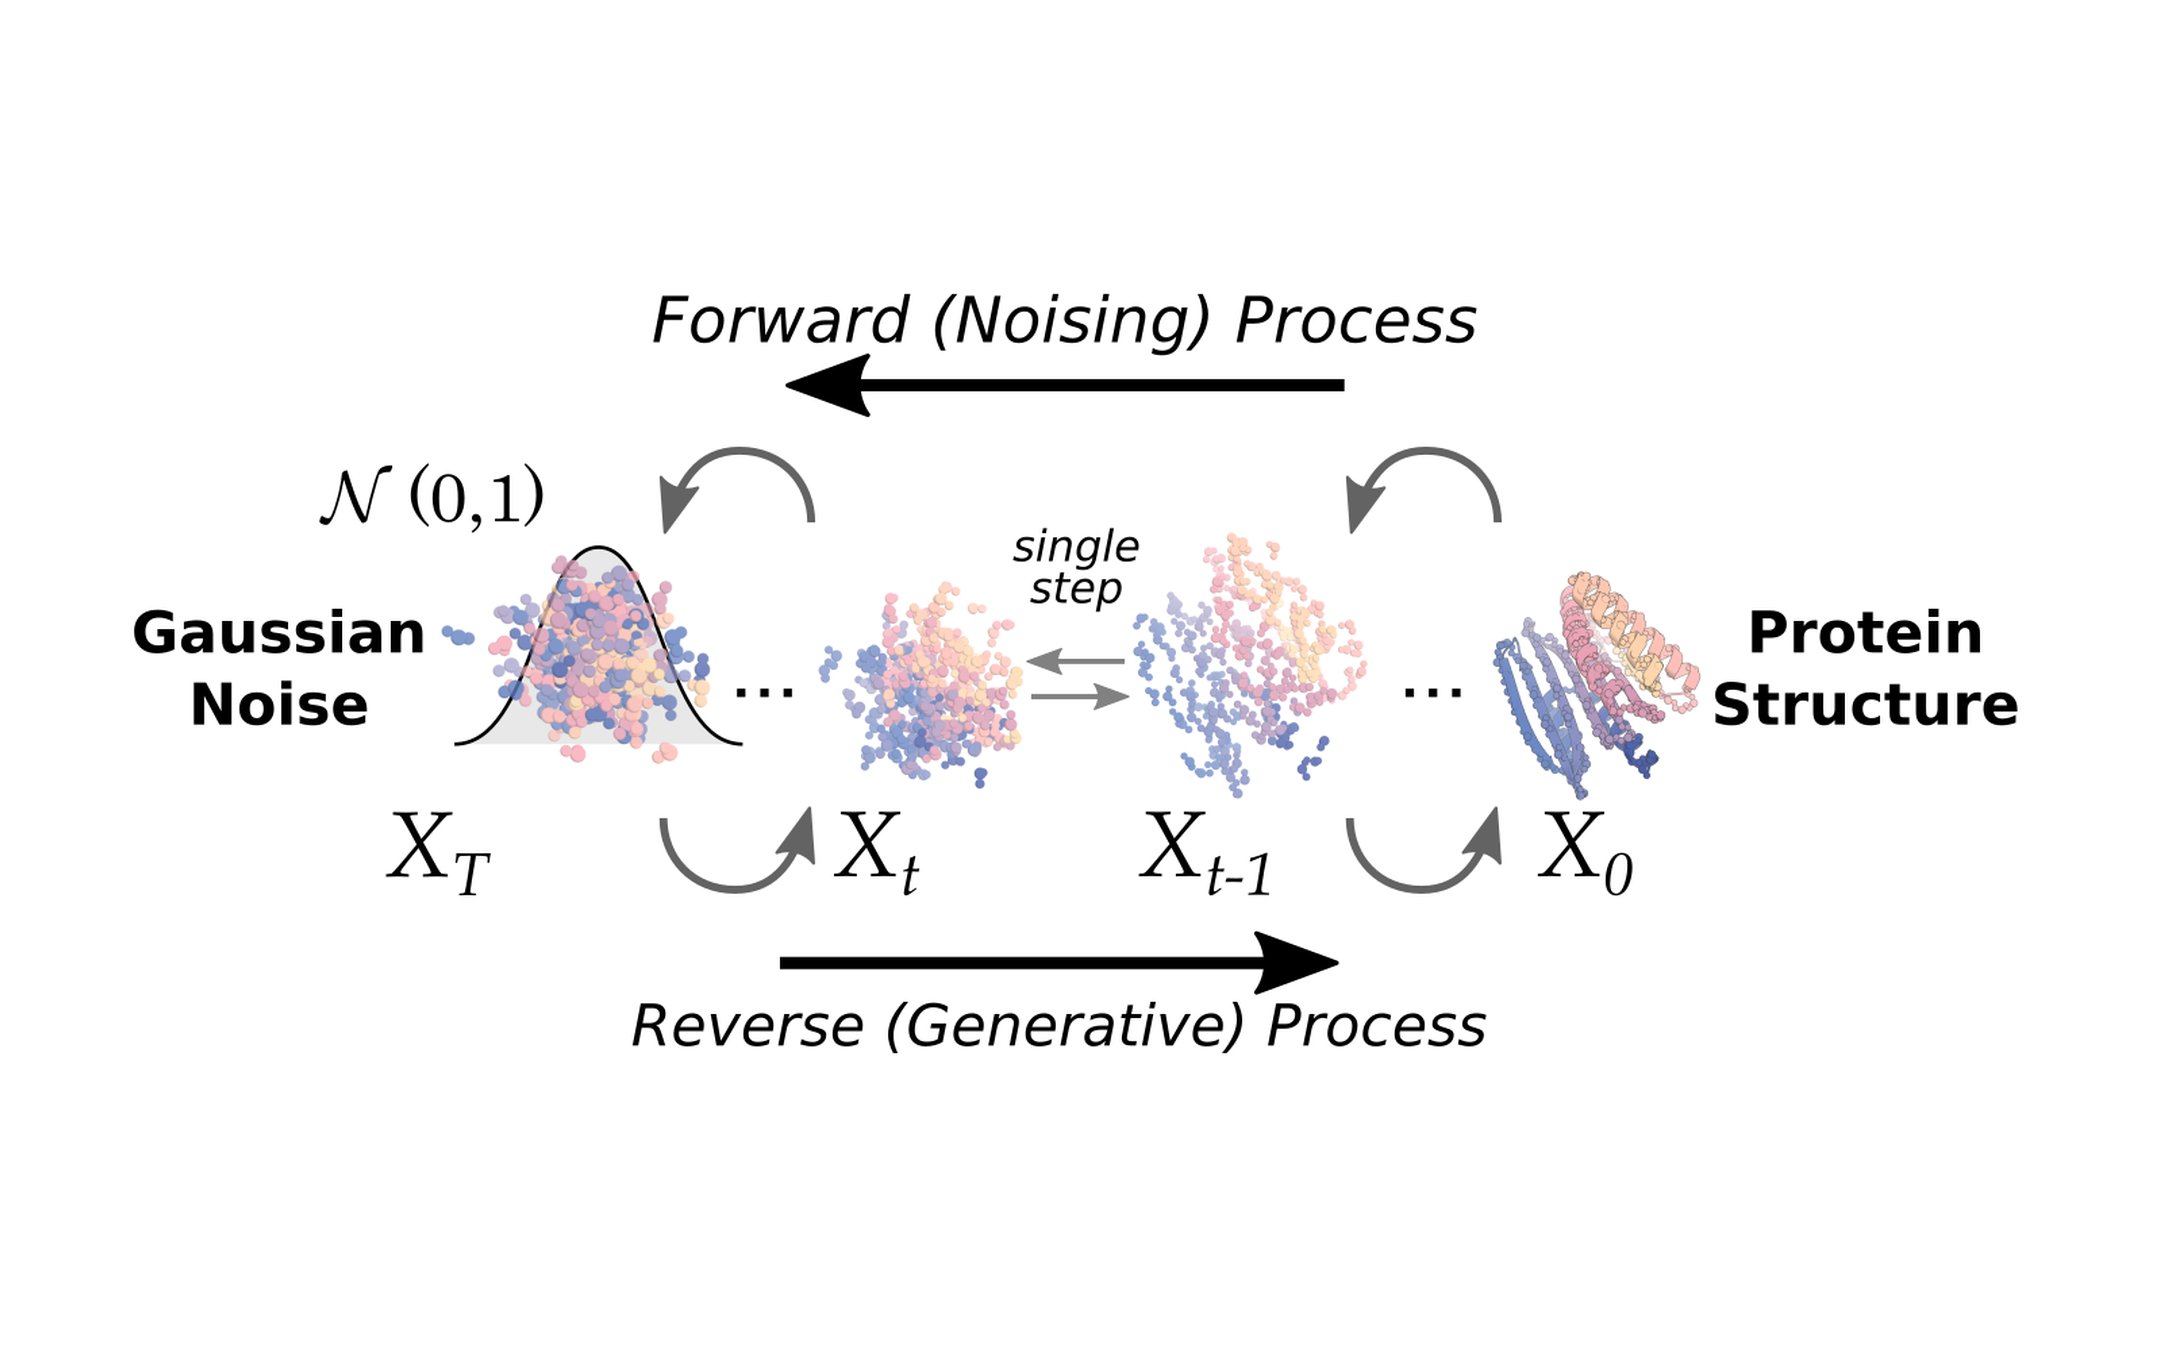
官方原理示意。上方箭头表示加噪,底部从左向右的箭头表示生成;散乱的点逐渐形成右侧折叠结构。来源:RFdiffusion 仓库。打开原图可查看标注。
这套方法是在 RoseTTAFold 结构预测网络的基础上,针对去噪任务进行训练而来。研究中的一个关键设计是把上一轮的结构预测也交给下一轮参考,使多次修改沿着同一结构逐渐推进。它保留了结构模型学到的空间关系,又允许不同随机起点产生不同方案。原论文展示了无条件骨架、对称组装、功能片段支架和结合蛋白等任务,不能把某一任务的结果直接推广到全部设计要求。
一段固定片段,怎样长出新的周围结构
官方文档中的例子很直观:从输入 PDB 文件里选取 A 链第 10 至 25 号残基,要求在它前面生成 5 至 15 个残基,后面再生成 30 至 40 个残基。输入文件可以还有其他结构,但真正交给模型作为保留条件的是指定的那段。
这样安排长度范围,是因为研究者未必事先知道,连接成合适骨架究竟需要多少残基。模型每轮可以采样不同长度,围绕同一个片段生成多个方案。输出是候选骨架的坐标文件,以及记录输入输出残基对应关系等信息的文件。以上是官方示例的解析,未在本文运行。
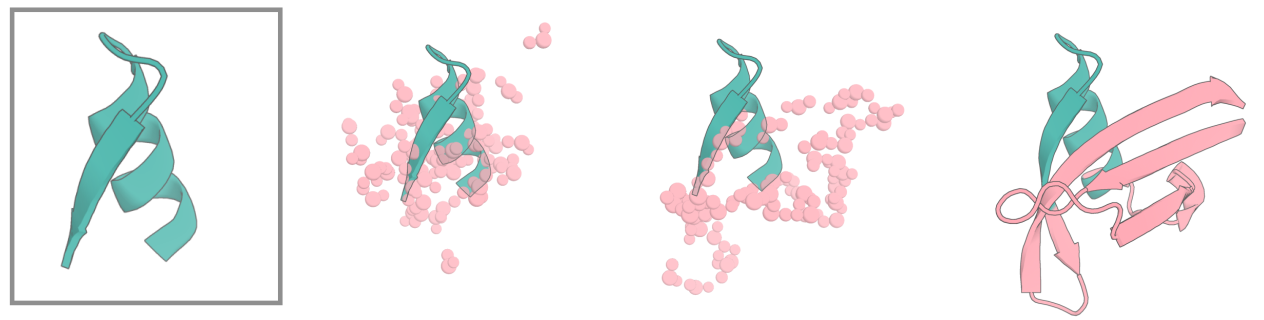
官方片段支架示意。左侧框内是保留的绿色片段;后续画面展示粉色待生成区域由散点走向骨架。图说明条件如何保持,不能据此判断某个新设计的实验活性。来源:RFdiffusion 官方仓库。
我认为这个例子比“AI 能设计蛋白质”更能说明价值:用户不用先给出完整新结构,而可以只固定最重要的一部分,保留其余形状的探索余地。相应地,小片段给出的约束也可能太弱。官方为极小功能位点另设了专门训练的模型,说明同一个默认模型并不能稳定解决所有保留条件。
骨架之后,还有一段关键路程
RFdiffusion 主要生成骨架,设计区域在输出中可能以甘氨酸序列表示。后续通常要用 ProteinMPNN 等方法,为这副骨架设计具体氨基酸序列,再借助结构预测进行筛选,最后通过实验检验。把骨架文件直接视为完整功能蛋白,会跳过这条链路中最影响结果的部分。
原论文不只展示计算图片,也对一批对称组装体、金属结合蛋白和结合蛋白进行了实验表征,包括用结构实验比较设计模型与实际结构。这里的意义是方法有选定任务的实验支持;论文中用 AlphaFold2 置信度和结构偏差定义的“计算成功”,仍须与实验成功分开理解。
当前许可文件明确覆盖代码和 README 指向的模型权重,采用 BSD 三条款式条件,允许按条款商业使用;这不自动覆盖后续接入工具或所有训练数据。实际尝试需要模型权重、计算环境和结构知识。想继续深入,可以先读仓库的片段支架示例,观察输入条件如何限制输出,再进入序列设计与验证。
以上为编辑整理,功能、许可与使用条件以官方说明为准。