
RVC:把已有录音换成授权音色,先准备模型与索引
为什么值得关注
让读者理解录音、音色模型、检索索引和音高提取如何组成一条换声流程。
适合谁:有本人或明确授权声音数据,想研究旁白换声与演唱音色转换的创作者。
这次有哪些亮点
- 输入是已有音频,训练与推理入口分开
- 目标音色模型和检索索引应对应使用
- 当前主线环境已更新到Python3.12,旧教程需核对
使用前需要知道
代码MIT不授权第三方歌声模型或歌曲;底模与分离权重另查,伴奏分离、实时延迟和转换音质受输入与硬件影响。
如果一段演唱或旁白的节奏已经录好,只想改变声音的音色,RVC对应的是“音频转音频”任务。它需要源录音,再结合目标音色模型进行转换;只提供一段文字并不是主流程。先分清这点,才能判断你缺的是配音录制、文字转语音,还是换声环节。
当前主仓库提供训练与推理WebUI,也有独立实时换声界面。README里的RVCv3仍以期待后续底模的措辞出现,不能写成已经发布并可下载的新一代。本文阅读完整英文说明与许可证,未训练模型、转换音频或测量实时延迟。
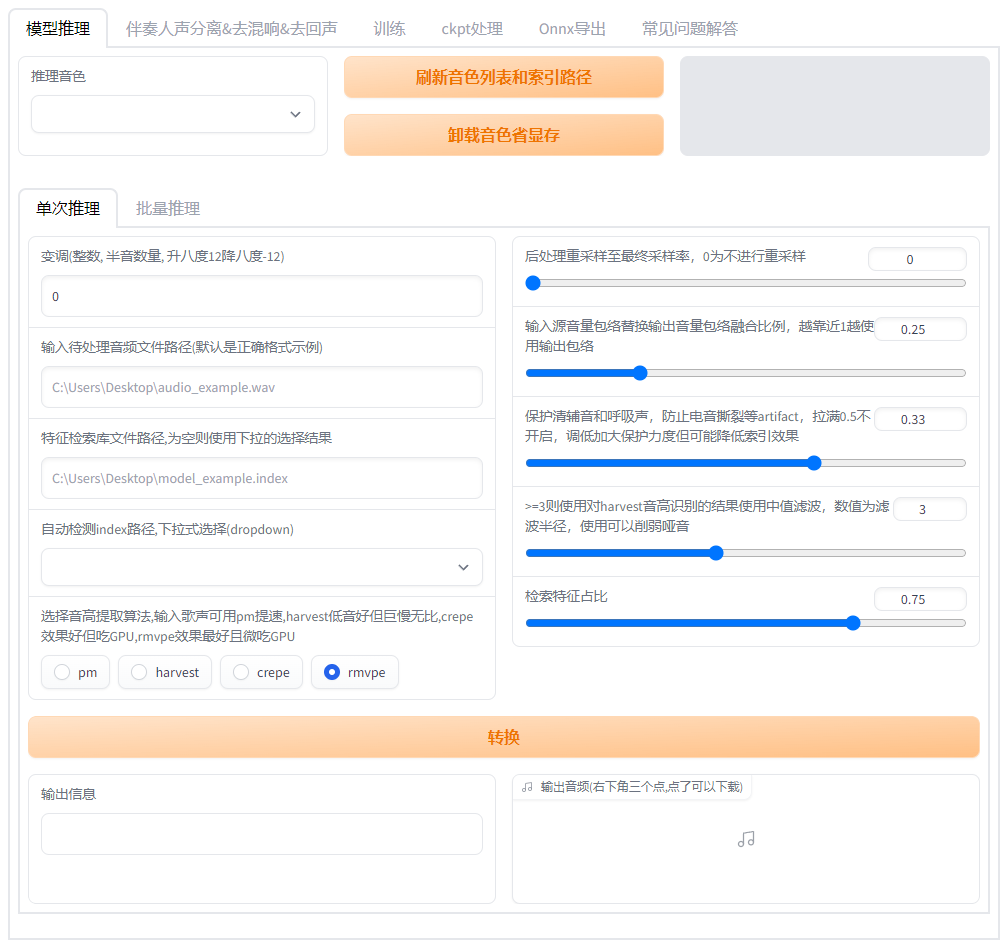
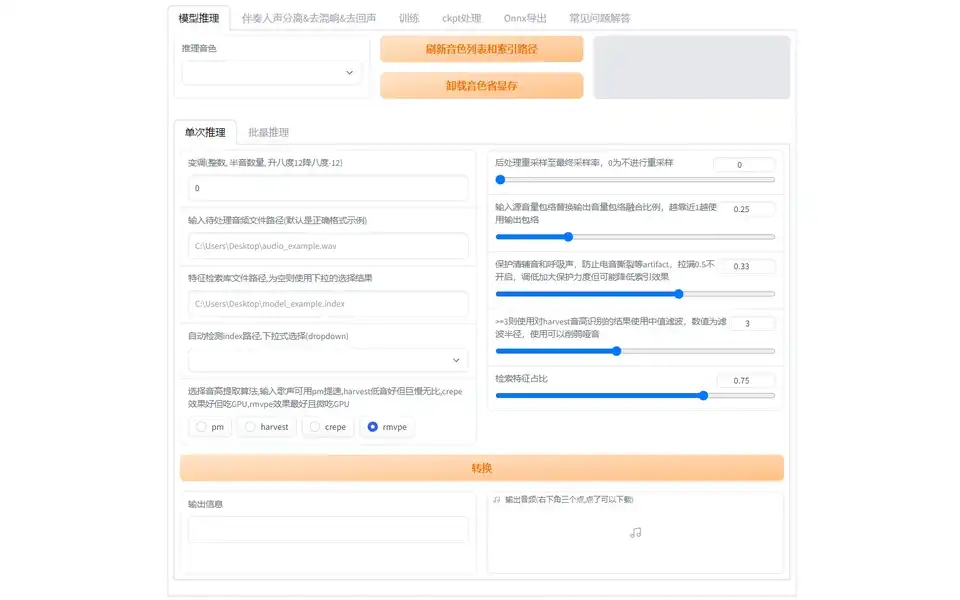
图源:RVC官方README。这是作者展示的界面,说明需要输入音频并选择相应资源;界面可能随当前代码变化,不是本文执行截图。
准备目标音色时,应把训练和推理分开。训练需要干净、低噪声、取得授权的数据,官方建议至少约10分钟;推理则使用训练得到的模型与检索索引。检索把源特征与训练集特征联系起来,用于减少源音色泄漏,但不保证所有发音和演唱方式都能自然迁移。模型与索引拿错版本,也会让结果难以判断。
可以用自己朗读的一段短文做起点:保留同一条源音频,先使用本人授权数据训练或明确授权的目标模型,检查齿音、气声、尾音与长元音。若做演唱,则先把干声与伴奏分开,转换人声,再回到混音工程比较。这里是编辑示例,未运行;分离器并不能自动赋予原歌曲、录音或伴奏使用权。
界面中的音高提取与变调也有不同作用。RMVPE用于提取音高特征,变调控制音高整体变化;它们不能替代合适的音域和清楚的输入。先保持较少改动,听源音频与转换音频是否保留发音,再逐项调整,比同时更改变调、检索比例和保护参数更容易找出问题。输出中保留少量源音色与声音发闷之间,往往需要根据素材取舍。
环境请看当前分支。现行英文README针对Python3.12 x64,按CPU/AMD/Intel、RTX50系列和更早NVIDIA显卡分列依赖,启动入口为webui.py,默认端口7865。旧整合包的目录和启动方式可能不同。个人模型放assets/weights,索引放assets/indices;这些路径比搜索到的旧截图更应优先核对。
实时换声也有独立条件。作者提供的170毫秒与ASIO约90毫秒数据依赖设备驱动和硬件,不是所有电脑的通用延迟,更不是本文实测。做预录旁白时可以优先考虑离线质量;直播则还要把麦克风、音频接口、监听与处理链总延迟一起测试。
仓库代码采用MIT,但从社区下载的名人或歌手模型不因此获得声音授权。训练数据、目标人物许可、底模、分离器权重与歌曲录音应分别确认。对外发布前,授权应覆盖声音转换、合成结果和具体用途;不要用一个“开源模型”标签替代这些条件。
RVC适合已有音频、想保留表演节奏再研究音色的流程。它的价值是可拆分地检查数据、音高和检索,而非保证一键得到可发行翻唱。
以上为编辑整理,功能、许可与使用条件以官方说明为准。