
SAM 3:输入“shoe”找出一组鞋,文字也能成为选区入口
为什么值得关注
适合给图片或视频建立按对象概念选择能力的视觉工具开发者。
适合谁:视觉工具开发者、技术美术、素材标注团队
这次有哪些亮点
- 文字概念可对应多个实例,输出蒙版、框和分数
- 正负样例框可继续限定想找的对象类型
使用前需要知道
权重需在HF申请访问并认证,采用自定义SAM License;当前仓库另有SAM3.1,本文实例讨论SAM3,不能共用性能结论
一张球场照片里有好几个孩子,想把鞋单独选出来,不一定要逐个点。SAM 3增加了按概念找对象的入口:输入一个短语,模型在图像里寻找符合概念的多个实例,并给出各自的蒙版、框和分数。它适合做选区工具的底层能力,让编辑从“我想选哪一类东西”开始。
官方图像notebook给出实际保存的例子:输入shoe,在球场照片中返回12个对象。展示图把鞋的位置标为不同实例,和孩子身体其他部分分开。12是这一张图、这次官方运行的结果,不代表模型对任何多人场景都能数全,也不是猫目本地测试。
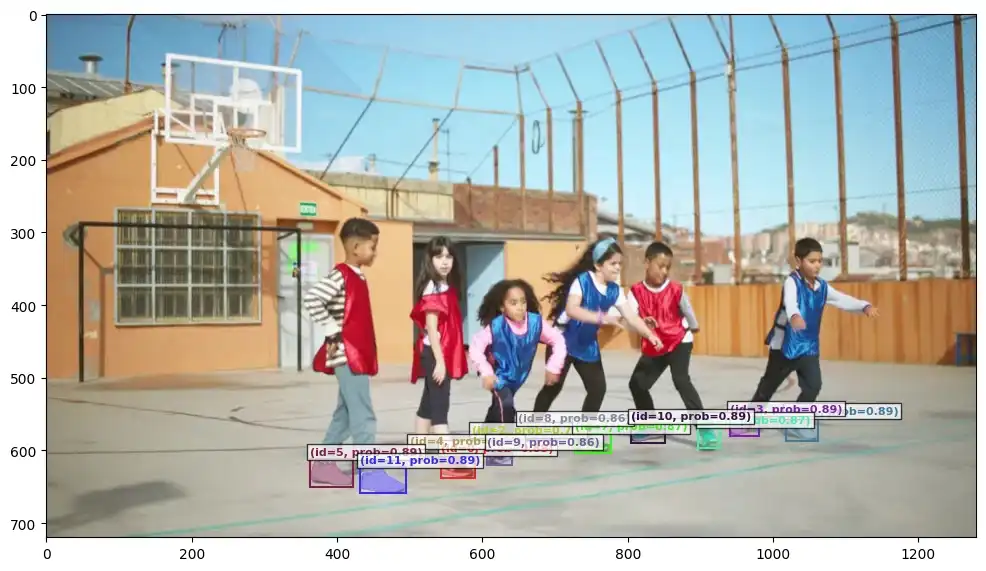
Meta官方notebook的shoe结果,彩色标记区分多个实例。文字提示、保存输出和原图场景在同一份材料中对应。
一个概念可能对应许多选区
SAM3 README把主要变化说得很清楚:除了点、框和蒙版等视觉提示,它还可以按短文本或样例找出开放词汇概念的多个实例。它内部结合检测与跟踪;视频入口先创建会话,再在某一帧添加文字提示,而不是每帧重新上传一张互不相关的图。
这适合继续构造“把所有鞋作为一个编辑组”“分别给多个同类对象加标记”等工作流。但输出本身仍是分离信息,改色、模糊和合成需要下游工具实现。概念是筛选依据,不能把相似分数直接理解为对象真实身份或业务判断。
视觉样例可以把概念收得更窄
同一notebook接着使用样例框:给一个正框后返回6个实例,再加入一个负框后变为5个。这个过程表达的不是简单剪掉框外区域,而是用正负样例告诉模型,哪些外观属于想找的集合、哪些不属于。若短词太宽泛,视觉提示能提供额外区分;若选区仍不合适,还应根据当前任务检查遗漏和误选。
对于创作者,文字入口与逐点入口各有用途。知道要哪一类对象时,用短语更容易表达集合;只要某一个特殊对象或局部细节时,点、框和后续修正仍然重要。SAM 2以交互选定对象再传播的流程,与SAM 3按概念找多实例的流程,不能只因为都叫SAM就视为同一个功能。
下载与许可已换了一套条件
README要求先在Hugging Face申请SAM 3检查点访问,获准后登录认证再下载。当前运行环境说明包括Python3.12以上、PyTorch2.7以上及相应CUDA GPU,安装示例又固定了自己的版本组合。能读仓库并不等于已经获得权重或验证本机兼容。
项目使用自定义SAM License,有再分发、研究署名与用途等条件,不能沿用SAM 2的Apache 2.0描述。当前仓库还记录2026年3月的SAM 3.1多对象跟踪更新;本文解析的shoe案例属于SAM 3示例,不把3.1速度结论挪过来。实际制作前,先保留提示、实例ID与遮罩,再决定按对象集合进行哪些编辑。
以上为编辑整理,功能、许可与使用条件以官方说明为准。