
SenseVoiceSmall:转写录音时,一并保留情绪与声音事件线索
为什么值得关注
让剪辑与录音整理者知道除了文字还能保留哪些可复核线索,并避免误把情绪标签当事实判断。
适合谁:整理访谈、讲解和录音素材,愿意配置语音模型的创作者与开发者。
这次有哪些亮点
- Small权重覆盖中英日韩与粤语,不能套用家族50语种宣传
- 可输出情绪与声音事件标签,后处理改变显示方式
- 长录音需先分段,人物分离是另加组件的管线
使用前需要知道
标签是模型预测而非人物真实心理或已核实事件;当前权重卡为自定义模型协议,不能套用代码MIT或旧Apache印象;转写仍需听校。
整理一段访谈,只有纯文字时,笑声、掌声和语气变化容易在剪辑前就丢掉。SenseVoiceSmall 在语音转写之外,还提供语言、情绪与声音事件相关标签,适合把它们作为回听线索保留下来。它识别录音内容,不生成配音,也不克隆人物声音。
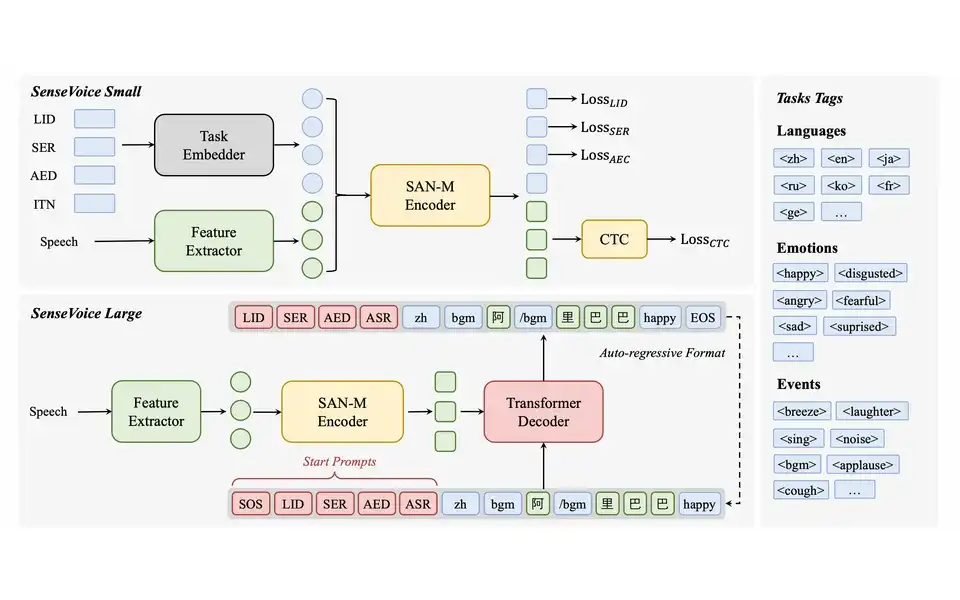
先看清型号。当前官方仓库明确,已发布Small检查点的识别范围是普通话、粤语、英语、日语和韩语。家族介绍里的50多种语言不能直接当作这份权重的支持清单;Large的评测表现也不能算到Small上。
官方示例先加载模型与FSMN-VAD,再读取示例音频,generate得到含标签的结果,最后调用rich_transcription_postprocess变为适合显示的文本。这里的“后处理”不只是去掉几个控制字符。当前处理代码会把 <|Laughter|> 映射为笑脸、<|Applause|> 映射为掌声,把语言标签移除;同类事件或情绪还会合并显示。因而适合阅读的文本,并不等于完整保留了原始标签。若后续要按笑声筛素材,应同时保存原始 text 和显示文本,而不是再从表情符号猜回原始输出。
例如,一段授权访谈里有正常讲话、笑声和长停顿,可以把转写与标签一起作为素材目录,编辑根据线索回到对应音频复核,再决定保留哪段。这是编辑设计的用途,未执行;标签不能直接证明说话者真实快乐、愤怒或某件事确实发生。误判的笑声、音乐和情绪都应允许人工修正,尤其不适合据此评价人物心理状态。
这些标签本身没有提供完整剪辑时间轴,回听定位仍要保留片段边界或另取对齐结果。长录音还要先处理长度。Small模型卡的直接推理入口限定30秒以内;通过FunASR组合VAD可先切成片段。当前仓库进一步提醒,整小时波形直接进一次推理会造成内存增长,另提供固定窗口路线。看到示例支持长音频,不等于编码器原生无限长度,实际应分清切段、模型推理与合并输出三个环节。
语言提示和数字格式也影响结果。language可自动判断或指定支持语种,use_itn影响逆文本规范化与相关输出。要做字幕,数字、英文专名与标点应回听核验;显示后处理不负责自动重新对齐被改写的文字。需要字词时间戳时,应按所用版本的对齐字段处理,不能用纯文本字符位置猜时间。
这份权重本身也不识别“谁是张老师”。说话人分离需要FunASR另配VAD、CAM++等组件,得到录音内部的匿名标签;不是Small原生输出的人物身份。若你只要文字与事件提示,不必为此把整套人物管线都加进来。
许可有一处当前材料必须讲清的变化:Small模型卡的license为other,链接FunASR Model Open Source License Agreement,而代码仓库采用MIT。该模型协议要求保留出处、作者及模型名,并包含用途责任、终止与更新条款。本稿不把它改写成Apache2.0或无条件商用;商业部署应核对实际权重来源与当前条款,必要时向发行方确认。音频本身的录制、处理和发布权限同样独立。
它的价值是为转写增加可复核线索,减少编辑凭空猜测录音内容的时间。真正交付前,仍应听校关键句、专名与可能影响语义的标签,再把模型结果交给剪辑或检索系统。
资料:Small完整模型卡、当前仓库与已发布范围、权重协议。
以上为编辑整理,功能、许可与使用条件以官方说明为准。