
sherpa-onnx:用本地CPU字幕示例,先得到带时间段的转写草稿
为什么值得关注
为希望本地处理录音的作者提供可见的操作入口,并分清运行框架、模型与最终字幕文件。
适合谁:愿意下载匹配程序与模型,先在桌面检查录音转写的作者和开发者。
这次有哪些亮点
- 官方提供Windows、macOS与Linux字幕示例程序
- 离线识别与VAD组合,结果显示时间段与文字
- 下载包名称包含系统架构模型语言,需逐项匹配
使用前需要知道
所选模型决定语言与许可;此Lazarus示例源码主要显示时间段文本,不承诺直接导出SRT或烧录字幕;需准备兼容WAV、使用不含中文字符的文件路径并人工校对。
希望在本地把录音变成字幕草稿,但暂时不想写Python,可以从sherpa-onnx官方的Generate Subtitles示例程序理解流程:选文件,运行本地识别,查看带时间段的文本。它属于语音推理框架的桌面示例,不是带翻译、审校和视频包装的完整剪辑软件。
官方下载页提供按系统、架构、模型与语言命名的包,说明可在本地CPU运行。Windows x64、macOS x64与arm64、Linux等不能随意混选;Whisper tiny.en只支持英语,中文应选择对应中文或多语种包。框架支持很多模型,不等于每个下载包都支持所有语言。
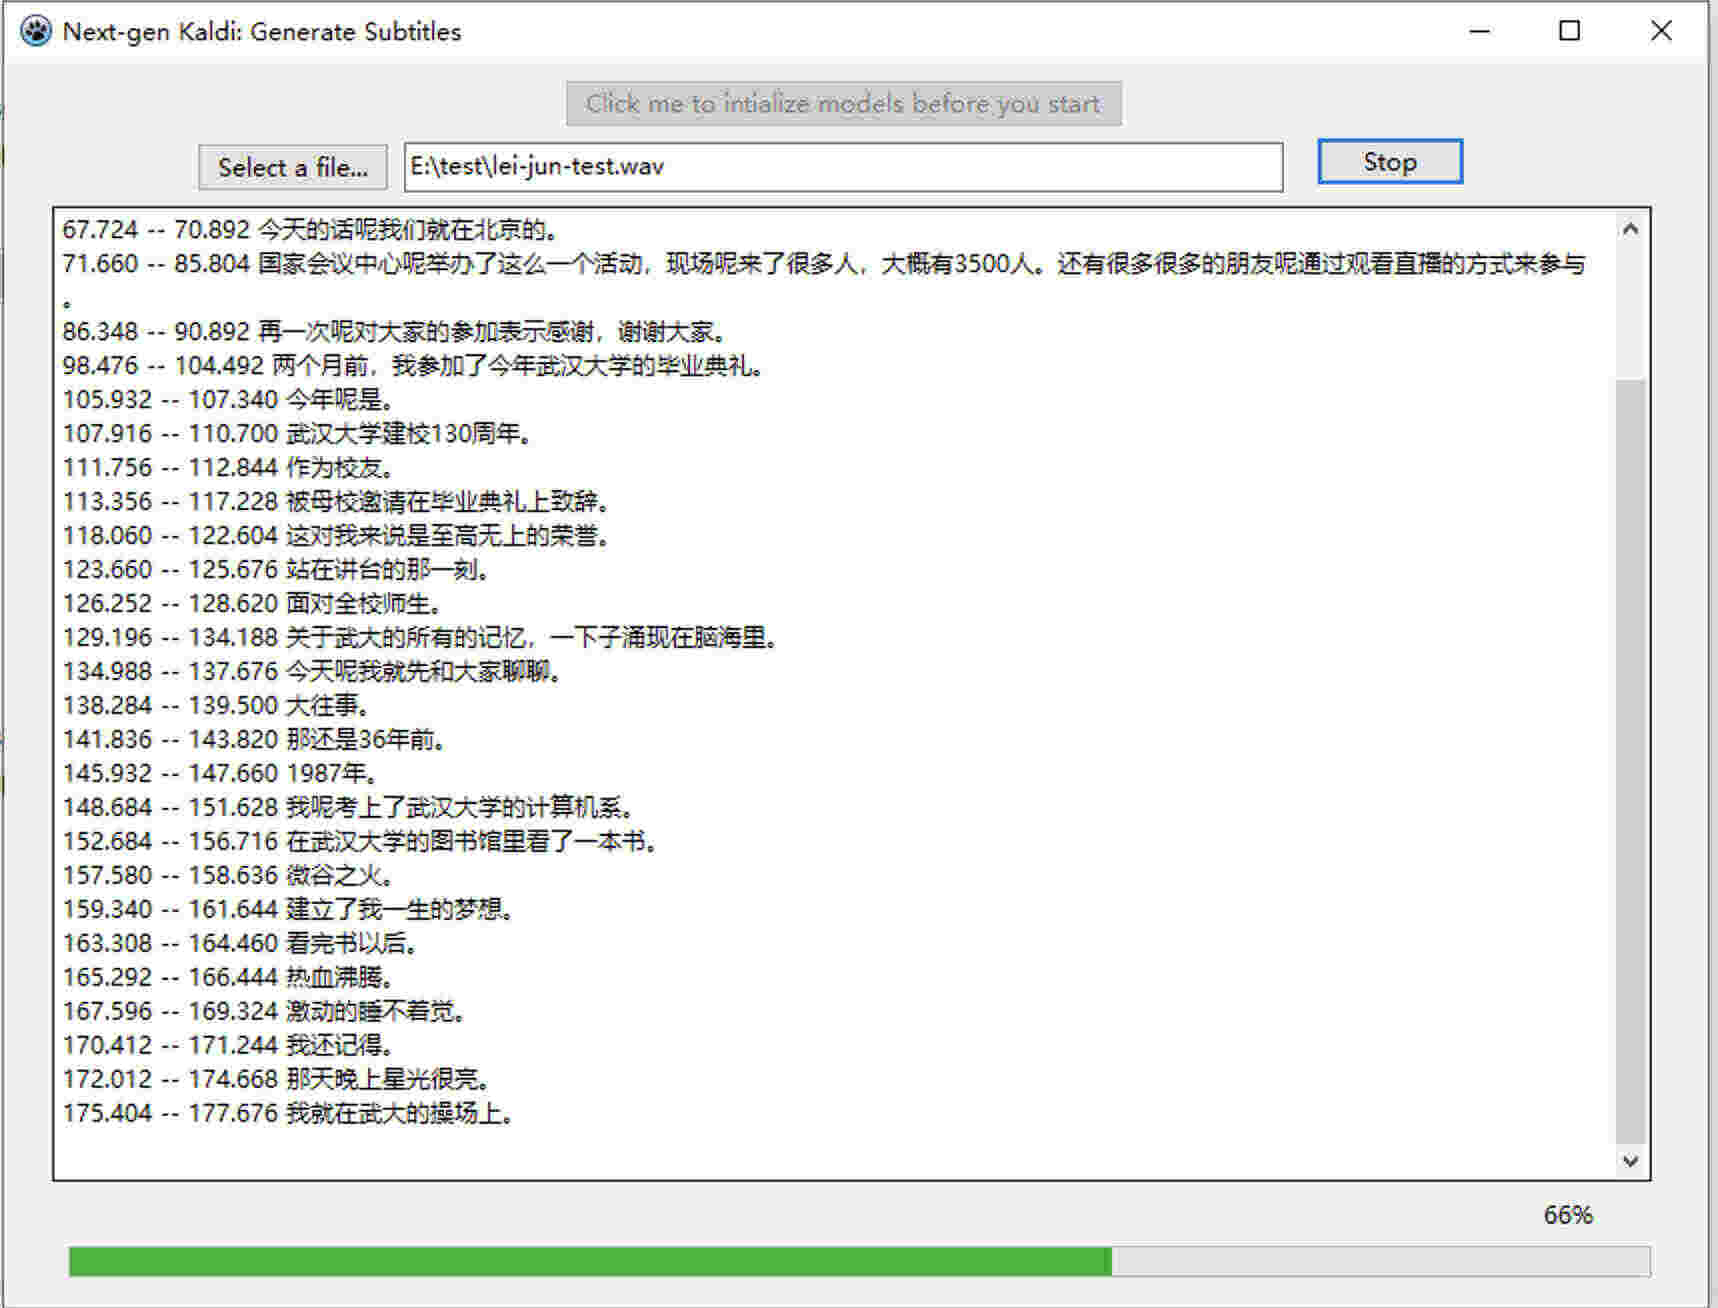
图源:官方Generate Subtitles文档。这是官方Windows界面演示,使用 lei-jun-test.wav,结果区按时间显示中文转写,底部进度为66%;不据此评价识别准确率。
截图里一条“今年呢是。”和下一条“武汉大学建校130周年。”分别带自己的时间范围,呈现的是讲话区域切段,未必就是适合上屏的完整句子。时间如 105.932 -- 107.340 以秒计,也不是SRT要求的整套文件格式。
因此有一个交付差别:这个Lazarus示例的当前源码把起止时间与文字追加到结果区,并没有在所审查的界面与工作线程中提供SRT保存流程。名称叫“生成字幕”,不应据此承诺已经拿到可直接导入剪辑软件的SRT,更不表示字幕已烧进视频。它首先帮助你得到带时间段的转写草稿,正式字幕格式需要另行整理或选择有对应导出的其他工具。
实际使用可以先取一段自己的单人讲解音频,选择匹配语种的包并准备所需模型,初始化后选文件。官方源码的读取路径要求单声道、16000Hz、16位WAV,不宜直接把手机视频拖进去就假定所有容器都支持。界面初始化提示还要求文件路径不要含中文字符;可以先转换音轨,放进英文命名的目录,再检查开头、长停顿和结尾是否被完整处理。这是编辑建议,未实际执行。
时间段从哪里来,也要理解。示例先使用Silero VAD找讲话片段,再交给离线识别器,时间来自该语音区域的起止位置。这不等于逐个汉字或每个单词都已精确对齐,长句仍需要为阅读速度和画面节奏重新断开。转写文字准确与字幕时间好读,是两个需要分别检查的指标。
如果自己编译,官方功能文档给出Lazarus工程和C++库准备方式;程序还需要VAD及非流式ASR文件。不同模型的文件名也有约定,例如Paraformer、SenseVoice与Whisper使用不同ONNX文件组合。下载一个主程序,却漏掉tokens或模型文件,不能正常初始化。预编译包则应先核对其清单,避免重复安装另一套无关运行环境。
它与模型的关系类似播放器与媒体格式:sherpa-onnx提供运行与接口,真正决定语言、识别能力和部分资源需求的是所选权重。换一个模型包会改变效果,也可能改变许可证。官方明确框架代码为Apache2.0,但支持其他框架的模型,各自条款须另查;同名转换版也不能自动抹去上游许可。
适合它的第一步是本地CPU上检查一条录音的切段与文字;若交付要求直接SRT、多人身份或翻译,应先确认你所选的具体应用实现确实包含这些功能。
以上为编辑整理,功能、许可与使用条件以官方说明为准。