
Stagehand v4:让 AI 找网页控件,把翻页和导出交给代码
为什么值得关注
分页案例把提取、定位动作、执行、检查点与完整导出分开,让目录是否齐全有可检查依据;当前 v4 已移除旧版 agent()。
适合谁:需要把分页网页整理成结构化成果、接入自己应用的开发者
这次有哪些亮点
- observe 返回可检查、可交给 act 执行的结构化动作
- extract 按目标字段结构提取网页记录
- 官方分页案例保留检查点,只在自然完成后写最终文件
使用前需要知道
面向开发者;本地 AI 调用需要模型配置,托管浏览器与模型用量另计;结构符合要求不保证取值准确,v3 代码不能直接套用 v4。
把几十页网页目录整理成一份数据,难点往往不在复制第一屏,而在后面的细节:下一页在哪里,是否漏页,中断后从哪里继续,怎样确认拿到的是完整目录。Stagehand 是供开发者构建浏览器自动化的 SDK,提供自然语言动作与结构化提取,同时保留代码对浏览流程的控制。它适合需要把网页任务接进应用的人,不是一个打开即用的个人上网助手。
认识它要先对齐版本。当前 v4 仍有 act、observe、extract,但已经移除了旧版内置的 agent(),也没有一对一替代品。官方把后续控制方式分为:让编程助手先写出脚本再运行,或由外部模型在运行中调用浏览器工具。旧版“交给 agent 自己循环”的示例不能原样套用。来源:v3 到 v4 迁移说明
一个分页书目怎样变成完整文件
官方 v4 的分页目录案例很适合解释分工。它以 Books to Scrape 为材料,要求逐页提取书名、显示价格和库存状态,最后得到包含页数、条目数和书目数组的 JSON。默认目标是一个两页的小分类;完整目录需要更换入口并提高页数预算。下面解析官方案例,没有实际执行提取任务。来源:分页目录案例
处理从当前页开始:extract 按指定结构取出可见书目,并检查必需字段非空。脚本再用稳定的“下一页”标记检查能否继续;有下一页时,让 observe 找到可执行动作,再把得到的动作交给 act。这样,提取什么、何时翻页、怎样判断结束,都有各自的位置。
下图是真实官方文档页面的截图,中间依次列出打开目录、提取记录、解析翻页、保存检查点和写出完整目录五步。它展示的是案例设计,不是运行成功的结果图。
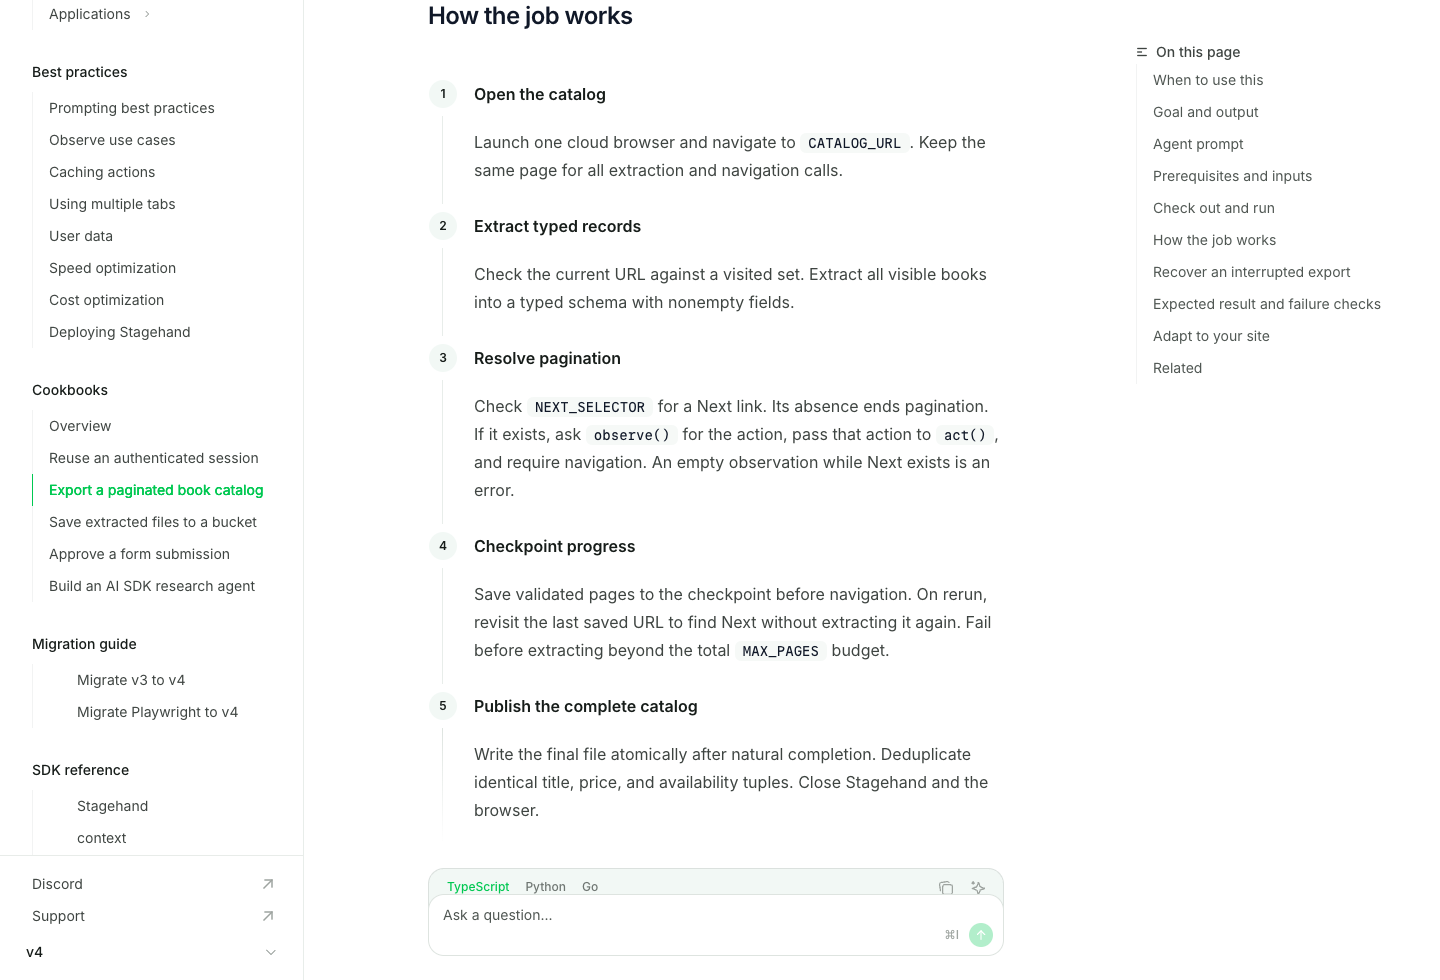
编辑使用 Chrome 对官方 v4 文档实截;英文步骤说明不代表中文网页处理效果。打开原图。
案例还区分了两份文件:每一页通过校验后先保存检查点,只有翻页自然结束才写最终目录。重复 URL、原地不动、跳到其他来源或提前用完页数预算,都会停止流程,而不是把已拿到的几页标成完整。重新运行时则从已有进度继续。
这里最值得借鉴的是“完成”有明确判据。只看 AI 返回了若干条记录,无法知道目录是否齐全;把下一页状态、访问过的地址和检查点放进代码,才有材料回答是否漏页。这个判断来自案例结构,不是对所有网站的可靠性保证。
自然语言定位之后,动作仍然可以检查
observe 的返回值是结构化动作,可以先检查,再执行。官方文档也说明,把已有动作传给 act 会重放该动作,省掉重新根据自然语言定位的模型调用。这让程序可以在“模型找到哪里”和“程序决定做什么”之间插入自己的判断。来源:Observe 文档
这并不要求每一步都用 AI。分页案例本身就保留稳定的下一页标记;已有可靠接口或定位方式的部分,可以继续用固定代码。遇到页面语义需要理解时,再让模型定位或提取,更容易看清哪些步骤依赖模型判断。
也要注意输出结构与事实准确是两件事。书名和价格都符合字段类型,仍可能取错位置。案例的去重依据是书名、价格和库存的组合;官方建议真实目录加入稳定的商品 ID,避免不同商品恰好同名同价。检查点也不会自动刷新已经保存的价格,换数据快照时应使用新的输出目录。
从哪里开始,门槛是什么
Stagehand 代码采用 MIT 许可,支持 TypeScript、Python 和 Go。可以使用本地 Chrome,也可以连接 Browserbase 托管浏览器;本地调用 AI 能力仍需配置模型,云端账户、浏览器与模型用量也要分别考虑,开源 SDK 不等于所有服务免费。来源:官方仓库与入口
如果你的需求是周期性整理公开目录、把网站结果接成结构化数据,这个官方案例提供了可继续改造的起点。真正要先定义的是来源、字段、下一页标记和结束条件。Stagehand 提供模型参与网页理解的接口;完整成果怎样落盘、失败怎样恢复,则可以明确地留在自己的程序里。
以上为编辑整理,功能、许可与使用条件以官方说明为准。