
StyleTTS2:给英文长段落挑一种读法,先听懂风格与参考声音
为什么值得关注
风格采样与参考适配提供不同的英文朗读路线,配合同文长篇样本,适合想把停顿、韵律和说话人特征纳入旁白选择的创作者。
适合谁:英文旁白、有声内容创作者,以及研究语音风格控制的开发者
这次有哪些亮点
- 结合文字采样风格,单说话人路线不要求参考语音
- LibriTTS 路线提供未见说话人的参考适配
- 提供同段长文、情绪迁移与消融音频样本
使用前需要知道
本文未运行或听验;英文数据集的主观评价不外推中文。模型声音使用规则、GPL 推理依赖及数据许可需分别遵守。
把英文文章转成音频,读对每个词还不够:句间停顿是否自然、读到后半段是否仍像同一位讲述者,都会影响人愿不愿意听下去。StyleTTS2 值得认识的地方,是把“怎么读”纳入生成过程。它的官方样本页还把长段落、参考声音和不同风格分开放在一起,适合做英文旁白、有声内容或语音研究的人带着具体问题试听。
先从同一段长文听起
官方页面第 5 节 Longform Narration 用一段完整英文材料比较多种合成系统。材料来自 Maria Parloa 的食品保存书,具体是为市场准备鲜果与保存水果的章节;页面同时给出 LibriVox 原录音,以及 StyleTTS2、JETS、VITS 和前代 StyleTTS 的音频。这里的价值是同一材料有对应结果,可以反复回到相同句子,而不是拿几段题材、长度都不同的声音凭印象比较。
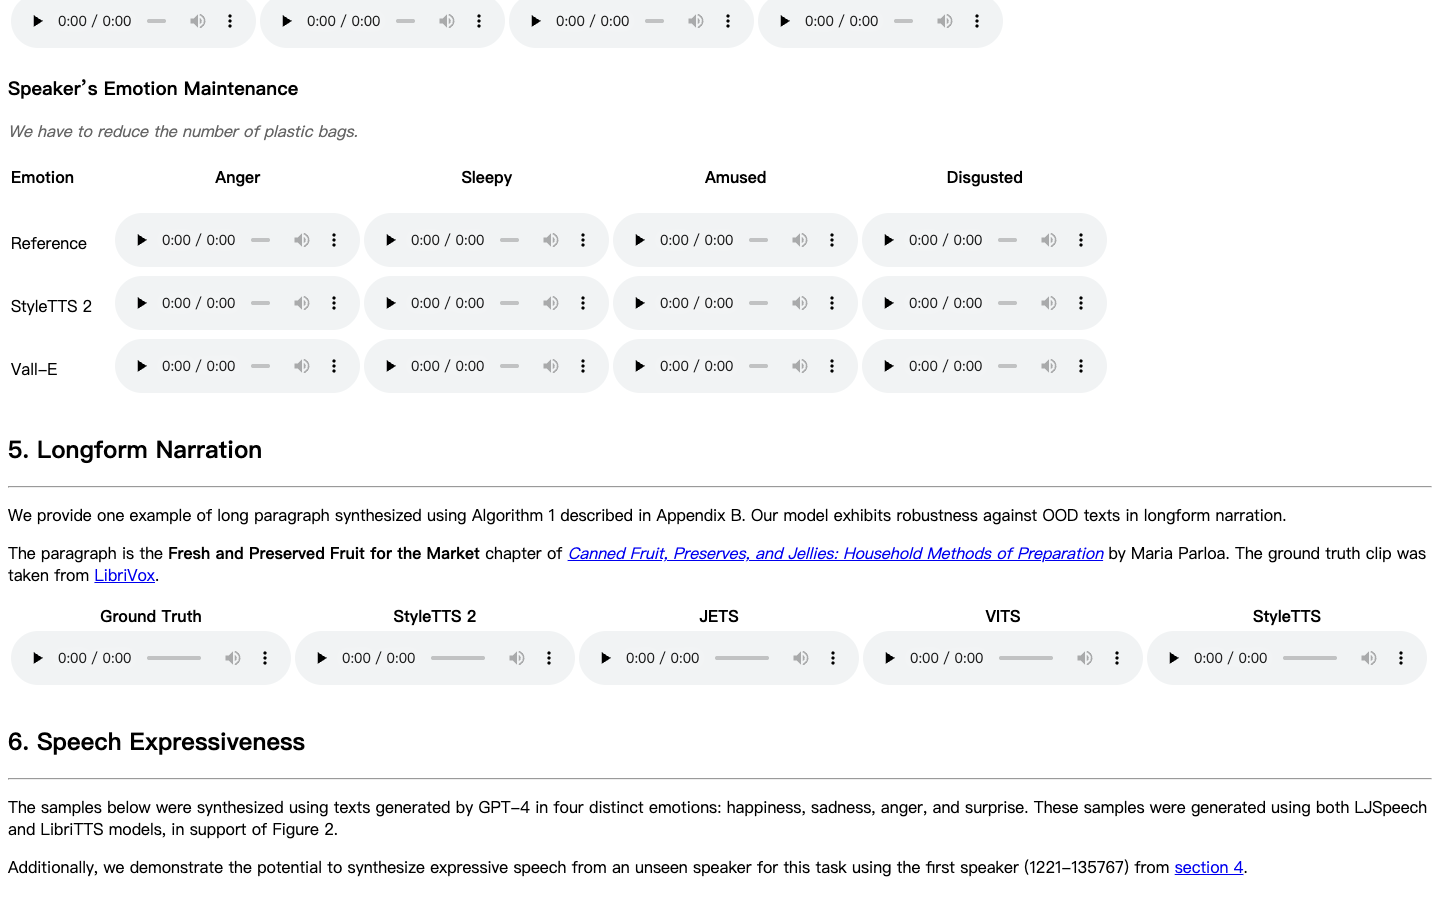
图中间的第 5 节就是长文入口,先认清 Ground Truth 与各模型的标签,再到官方页面播放。截图只证明这些比较项和材料出处确实存在;播放器显示并不代表本文已完成播放或听感评测。
建议先听长句里的停顿,再听相邻句子的语气衔接,最后检查是否有漏词、重复或突然变化。这个顺序是编辑提供的试听方法,结论要由你实际听到的声音决定。官方说明该示例使用论文附录 B 的长文合成算法,所以它能展示一个已准备好的长篇案例,不能直接推出“任意长稿都一次生成稳定”。
风格扩散与参考声音各管什么
StyleTTS2 不只是给文字套上固定音色。官方把风格表示为一个可以采样的隐变量,让扩散模型结合文字生成合适的风格;单说话人路线可以不提供参考语音。这里的“风格”会牵动停顿、情绪、语速和声音质量,因此同一段字不必只有一种机械的念法。
如果要保留某个人的说话特征,则要看多说话人路线。官方第 3 节 VCTK 示例把目标录音、参考录音和合成结果并列,第 4 节 LibriTTS 则展示训练中未见说话人的适配。参考材料带来的可能不只有声线,还包括音高、情绪甚至录音环境。选参考片段时,“听起来像谁”和“想让成片怎么读”应一起考虑;背景噪声并不一定会被系统自动忽略。
第 6 节还有一个很有辨识度的材料:作者先用带明确情绪的文字采样风格,再把该风格用于另一句本身没有情绪内容的文字。它解释了风格如何从原句转移到目标句。第 8 节去掉风格扩散等模块的消融样本,则让研究者继续追问停顿与韵律变化来自哪里。这些都是官方示例与作者解释,本文没有把它们改写成亲测结论。
英文成果与中文采用之间,还隔着模型和许可
论文中“接近或超过人声”的判断有明确范围:LJSpeech、VCTK 等数据集,以及英语母语听众的主观评价。它不等于中文朗读同样成立。仓库也提醒,所附 PL-BERT 以英文训练,其他语言需要匹配的语言模块与训练材料;文本对齐器用过中文语料,并不能证明整套中文合成已经可直接采用。
想继续试,可以从仓库的 LJSpeech 单说话人与 LibriTTS 多说话人推理笔记本进入,后者另需参考音频包。它是需要 Python、模型文件和语音前处理依赖的研究项目,不是下载后直接打开的配音软件。仓库还明确提醒,推理涉及 GPL 许可依赖;不能只看到代码 MIT,就把整条分发方案都当作 MIT。
代码、权重与数据也要分别看。仓库对预训练模型另列声音授权或公开说明合成身份的使用规则;数据页将 LJSpeech 标为美国公有领域,LibriTTS 标为 CC BY 4.0。这些条款分别约束对应材料,不能互相代替。对英文旁白探索,先用官方长文样本判断是否值得投入最省事;真正制作自己的声音内容时,再核对参考声音的授权和整套依赖条件。
参考资料:
以上为编辑整理,功能、许可与使用条件以官方说明为准。