
TabPFN:把已有样本交给模型,为新表格记录补上预测
为什么值得关注
当一张表已有部分记录的答案时,TabPFN 可以把这些样本作为上下文,直接为新记录做分类或回归,为小规模表格建模提供不同于逐项调参的起点。
适合谁:已有带标签表格、希望理解预测模型或建立研究基线的数据分析学习者与研究人员。
这次有哪些亮点
- 预训练模型把训练样本与待预测样本放在同一任务中处理
- 同一工具入口覆盖类别预测和数值预测
- 当前默认 3.5,本地基础模型与托管增强版本可用范围不同
使用前需要知道
需要已有目标标签及合理验证;当前 3.5 权重与输出仅限许可允许的非商业、非生产用途,商业场景需另行授权;不等于自动理解任意 Excel 工作簿。
一张设备检测表已经积累了一批样本:每行写着温度、振动、使用时长,以及最后是否通过检测。现在又来了一批新记录,你想先估计哪些更可能不通过。TabPFN 做的就是这类工作:从有答案的表格样本里学习关联,再给没有答案的行预测类别;如果答案换成某个连续数值,就用回归模型输出数值预测。
值得认识它,是因为这条路线把“如何从一张新表学习”预先学进了模型。使用时,已有样本成为预测上下文,不必为每张表重新从零训练一套神经网络。下面以教学情境和官方示例解释流程,未运行设备检测实验。
它读的是样本与答案之间的关系
把检测表分成两部分:特征列是温度、振动、使用时长,目标列是通过或不通过。先留出一部分已有答案的记录作测试,其余记录连同答案交给模型;预测时只提供测试部分的特征,再把输出与保留的真实答案比较。之后才轮到真正没有答案的新记录。这样得到的是可检查的预测任务,而非让聊天模型凭列名猜答案。
官方多分类示例采用鸢尾花数据:输入花的测量特征和已知类别,先划分训练集与测试集,再分别调用概率预测和类别预测。概率回答“各类别分别有多大预测可能”,类别给出最终选择;示例最后计算 ROC AUC 与准确率,但代码本身没有展示本文可引用的实测分数。官方多分类示例
下面的官方示意把这件事分成左右两块。左边是提前用合成数据训练模型,右边才是使用者拿真实表格预测的阶段;右侧问号代表待预测的答案,不是缺失的任意单元格。
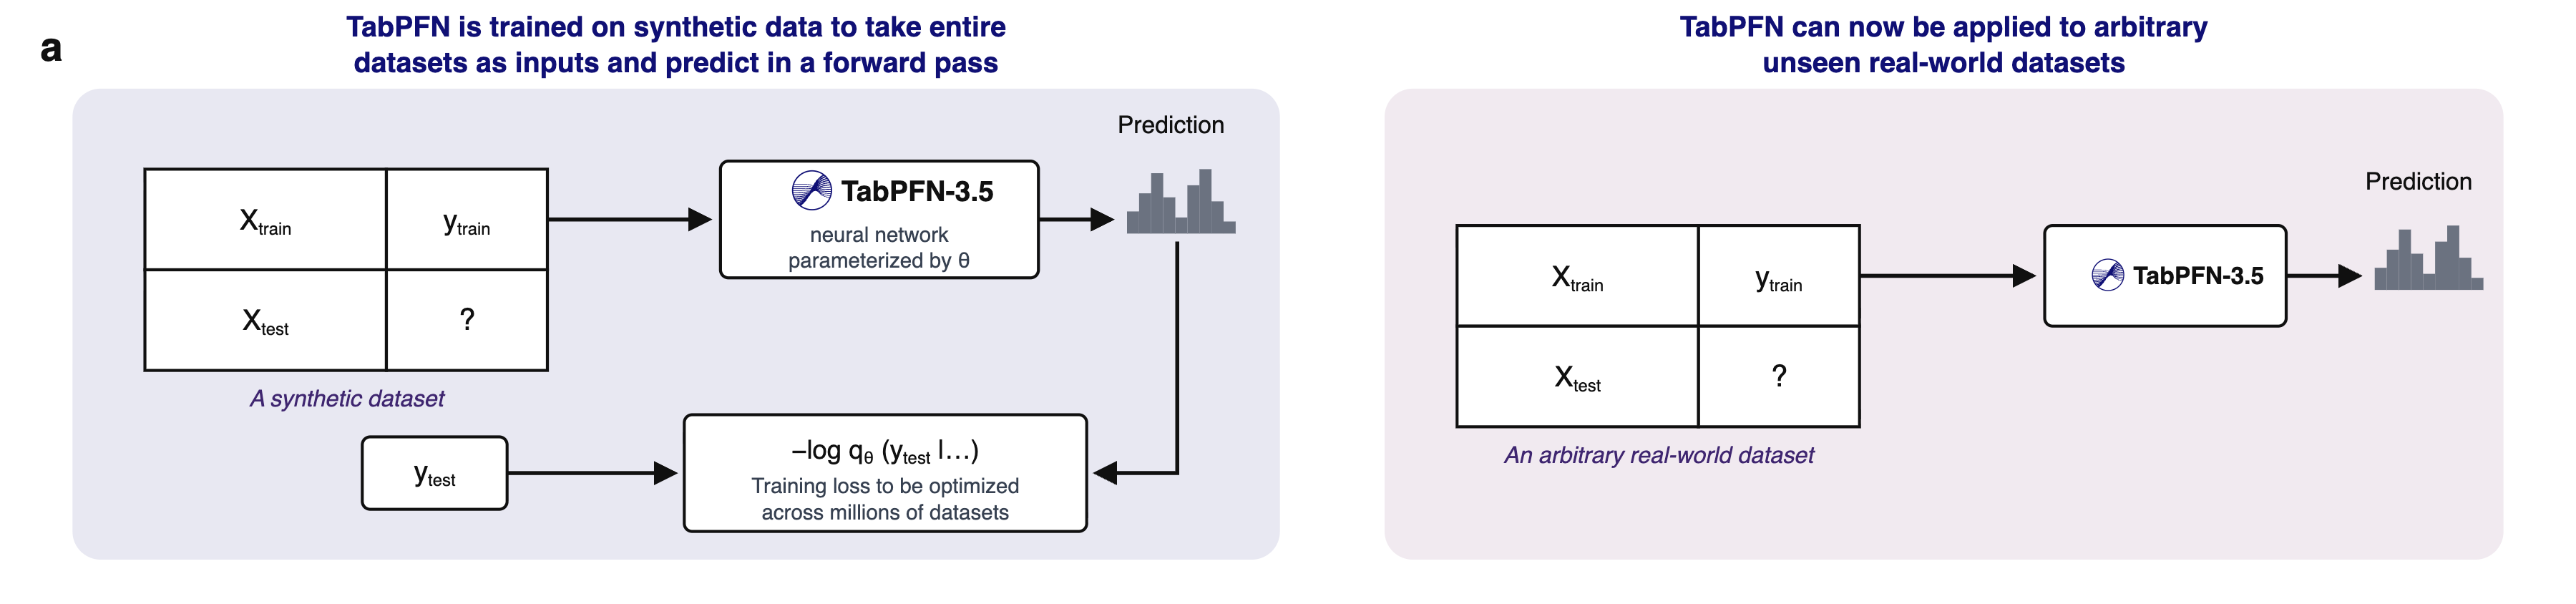
官方示意,来自 Prior Labs 仓库;原 SVG 经浏览器静态渲染。左侧训练过程与右侧应用过程不能混为一次用户操作。打开原图
这一设计让我更愿意把 TabPFN 看成表格预测的起跑线:已经有相对清楚的目标和历史样本时,可以先得到一个可比较的模型。若表里没有目标答案,或者真正想做的是汇总、透视、修复公式,就还没有进入它的主要任务。
旧文章里的“小表格模型”,如今已不是完整身份
当前仓库默认模型是 TabPFN-3.5,同时保留旧版本的选择入口。官方模型页把本地基础模型、托管 Plus 和 Thinking 分开列出,不能把托管增强能力统统写成本地包已经包含。当前模型与版本说明
即使从几百行的小任务开始,也要注意两个实际条件。第一,官方推荐 GPU,CPU 只适合较适中的数据;“模型能接收更大的表”和“自己的电脑能轻松运行”是两回事。第二,历史样本是否能代表新记录,比行数本身更关键。设备型号变了、检测标准改了,随机划分出来的漂亮分数未必回答下一批数据的问题。这是由任务结构得到的判断,不是项目给出的效果保证。
本地包首次使用会获取权重,当前新模型还需要接受条款;官方说明权重下载后的本地推理可离线,数据不随本地推理发往 Prior Labs。托管客户端则属于另一条服务路径。想接着了解,可从官方仓库与交互笔记本入口开始。
能下载代码,不等于默认权重可以商用
仓库代码为 Apache-2.0;当前 3.5 权重另有非商业、非生产许可,条款也限制输出进入业务流程等商业用途。旧版 v2 使用的是另一套条款,不能将它的授权结论沿用给默认版本。需要商业使用时,应取得对应授权,而不是只检查代码 LICENSE。
对正在学习建模的人,这个项目最有价值的第一步,是拿一张已有答案的表,明确预测目标、留出测试记录,再看模型是否比简单基线更有用。它把尝试一种强表格模型的路径缩短了,数据划分和任务定义仍要由使用者负责。
以上为编辑整理,功能、许可与使用条件以官方说明为准。