
Toto 2.0:把多条监控曲线一起往后预测
为什么值得关注
把监控曲线之间的联系与预测范围结合起来,并提供观测指标基准,便于建立自己的预测回放实验。
适合谁:需要研究监控指标预测、容量趋势与预测基线的运维和时序学习者。
这次有哪些亮点
- 交替处理时间与变量方向的关联
- 直接输出九档分位数
- 2.0提供五种模型规模及两种解码方式
使用前需要知道
2.0目前尚未开放微调和外生变量支持;预测分位数不自动构成告警或故障根因;长预测实验中的合成信号表现不能直接推及真实监控。
一组服务的请求量、CPU 占用和响应时间,接下来会怎样变化?监控看板擅长展示已经发生的事,Toto 想把这些数字继续往后推:输入一段历史序列,输出未来多个时间点的预测,以及不同分位数对应的范围。它由 Datadog 开发,重点面向监控指标;当前推荐版本是 Toto 2.0。
值得关注的地方,是它把“多条曲线的关系”和“未来并非只有一个值”放在了同一个模型里。对需要研究容量趋势、建立预测基线的团队,这比把每条曲线各自延长更有探索价值。
给它一组对齐的数字,拿回一组未来范围
可以用一个教学情境理解它:把同一服务最近一段时间的请求量、CPU 占用和响应时间,按相同采样间隔排成三行。每行是一个变量,每列是一个时间点;缺测位置另用掩码标出,避免把没有采到的数据当作真实的零。模型沿时间方向寻找变化模式,也沿变量方向处理曲线之间的联系。
输出仍按变量和未来时间点排列,但多了一层分位数。比如中位数给出一条中心预测,较低和较高分位数展示更宽的可能范围。三条曲线的输入形式来自官方接口,这个服务场景只是教学解释,并非已运行的容量预测实验。
22m 模型卡中的最小示例用随机数构造 512 个历史点,预测后续 96 个点,返回从 0.1 到 0.9 的九档分位数。这里的 96 是步数:采样间隔不同,它对应的实际时间也不同。随机输入展示的是接口形状,不能拿来证明真实监控效果。
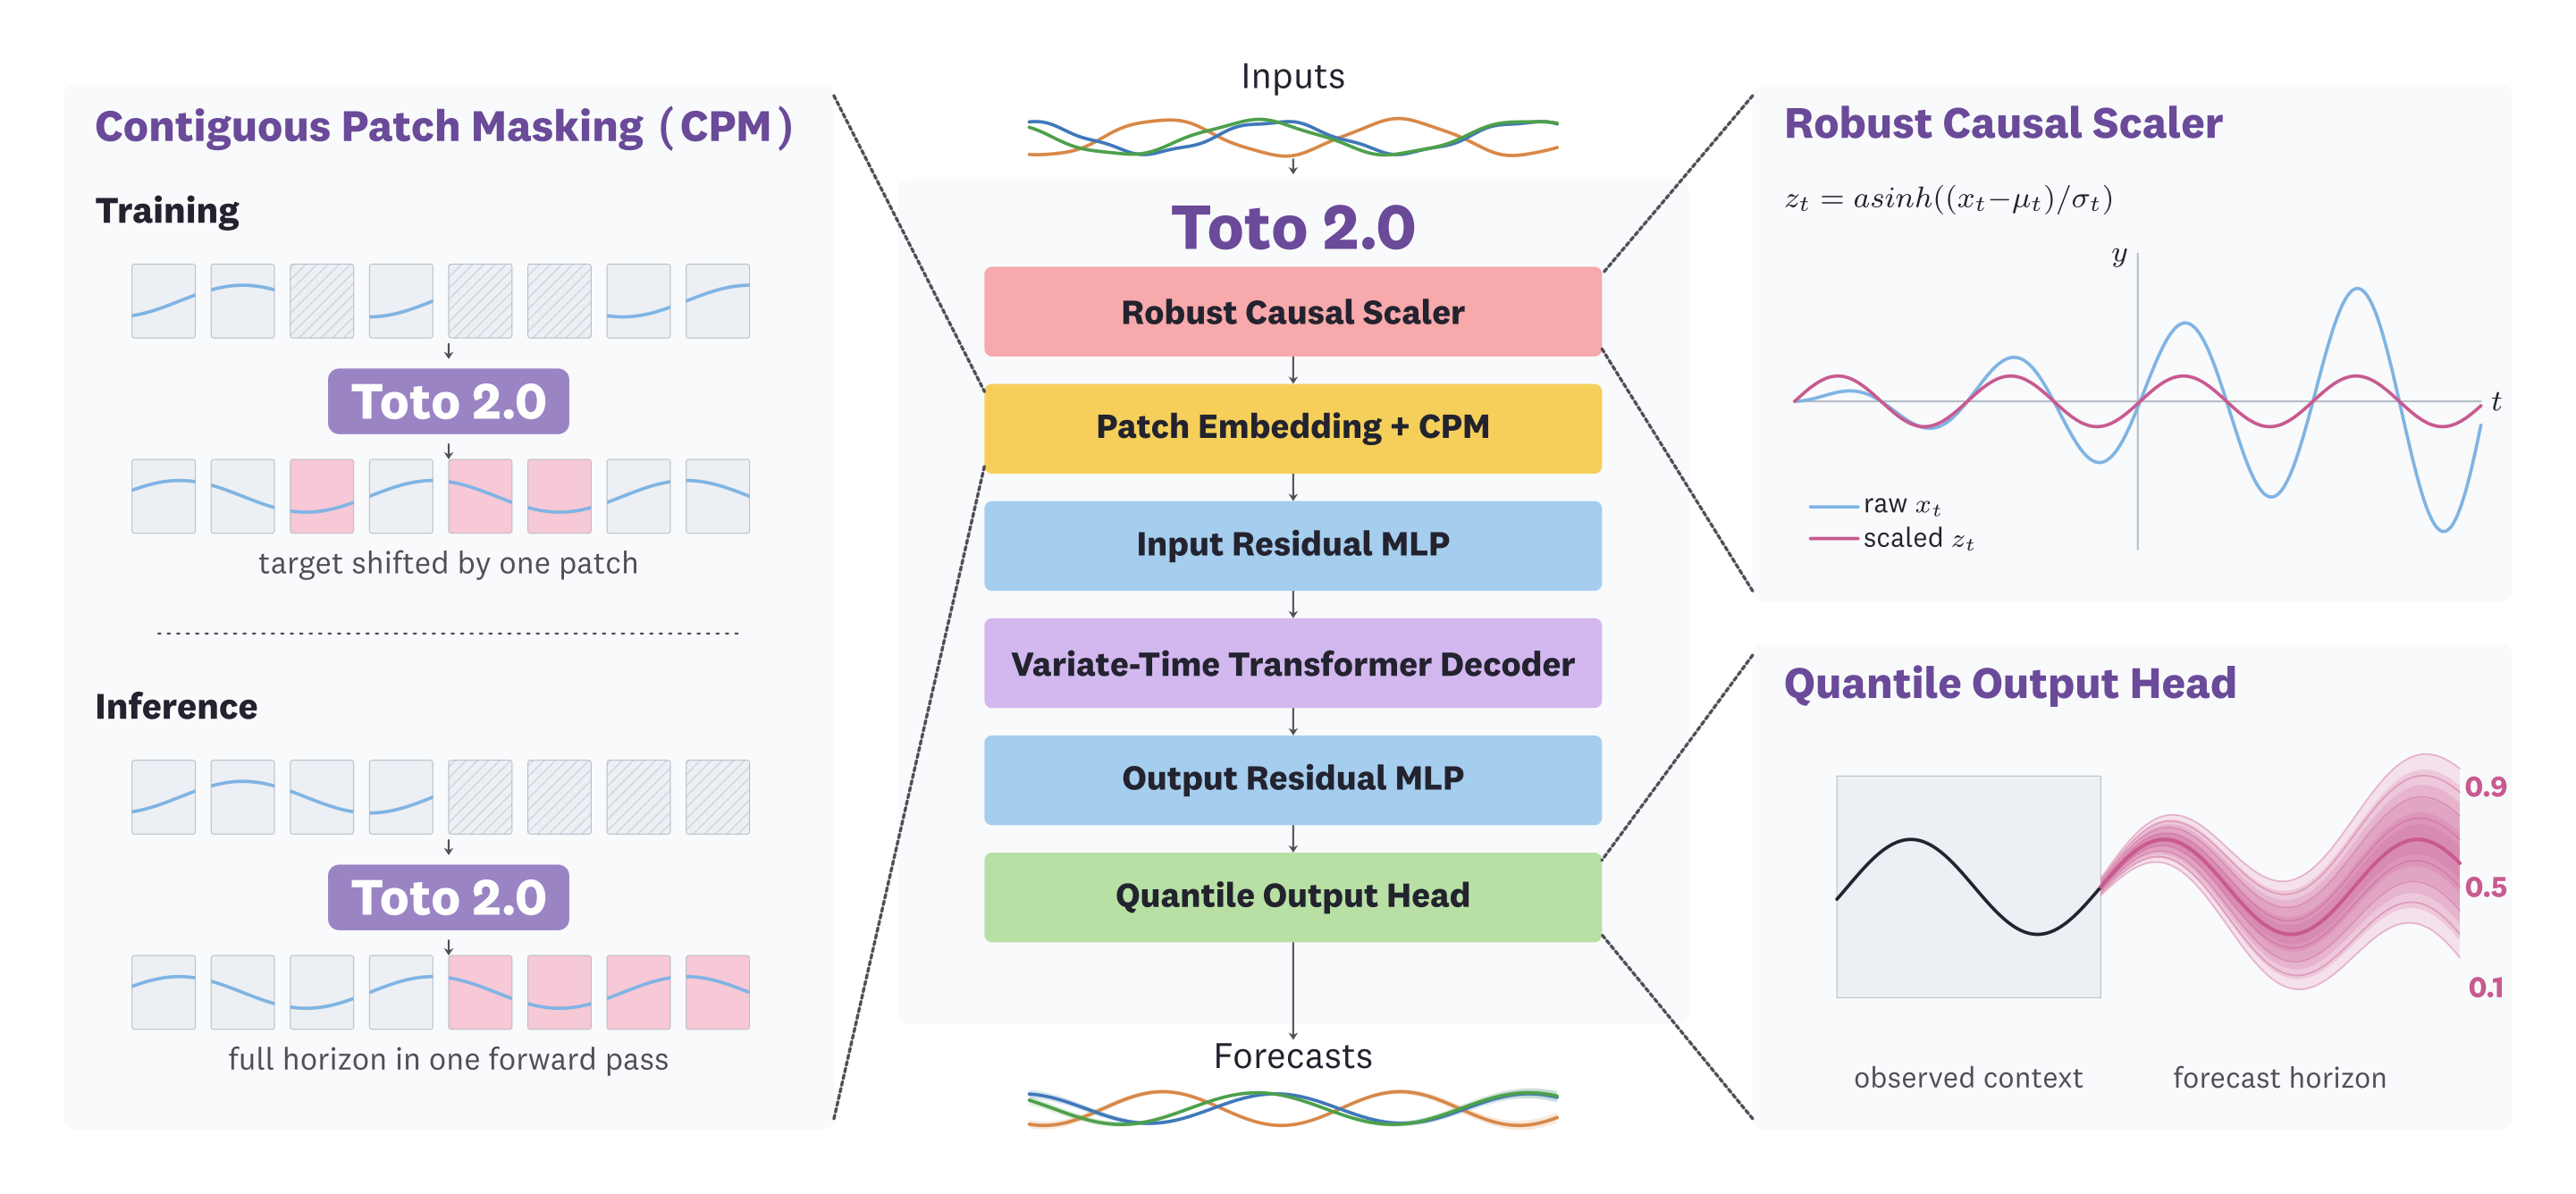
下图中间是从输入到预测的处理链,右下角的粉色曲线带对应分位数输出;左侧则区分了训练时遮住片段与推理时预测后续片段的方式。它解释了“为什么会返回一束曲线”,并不是某个真实服务的运行结果。
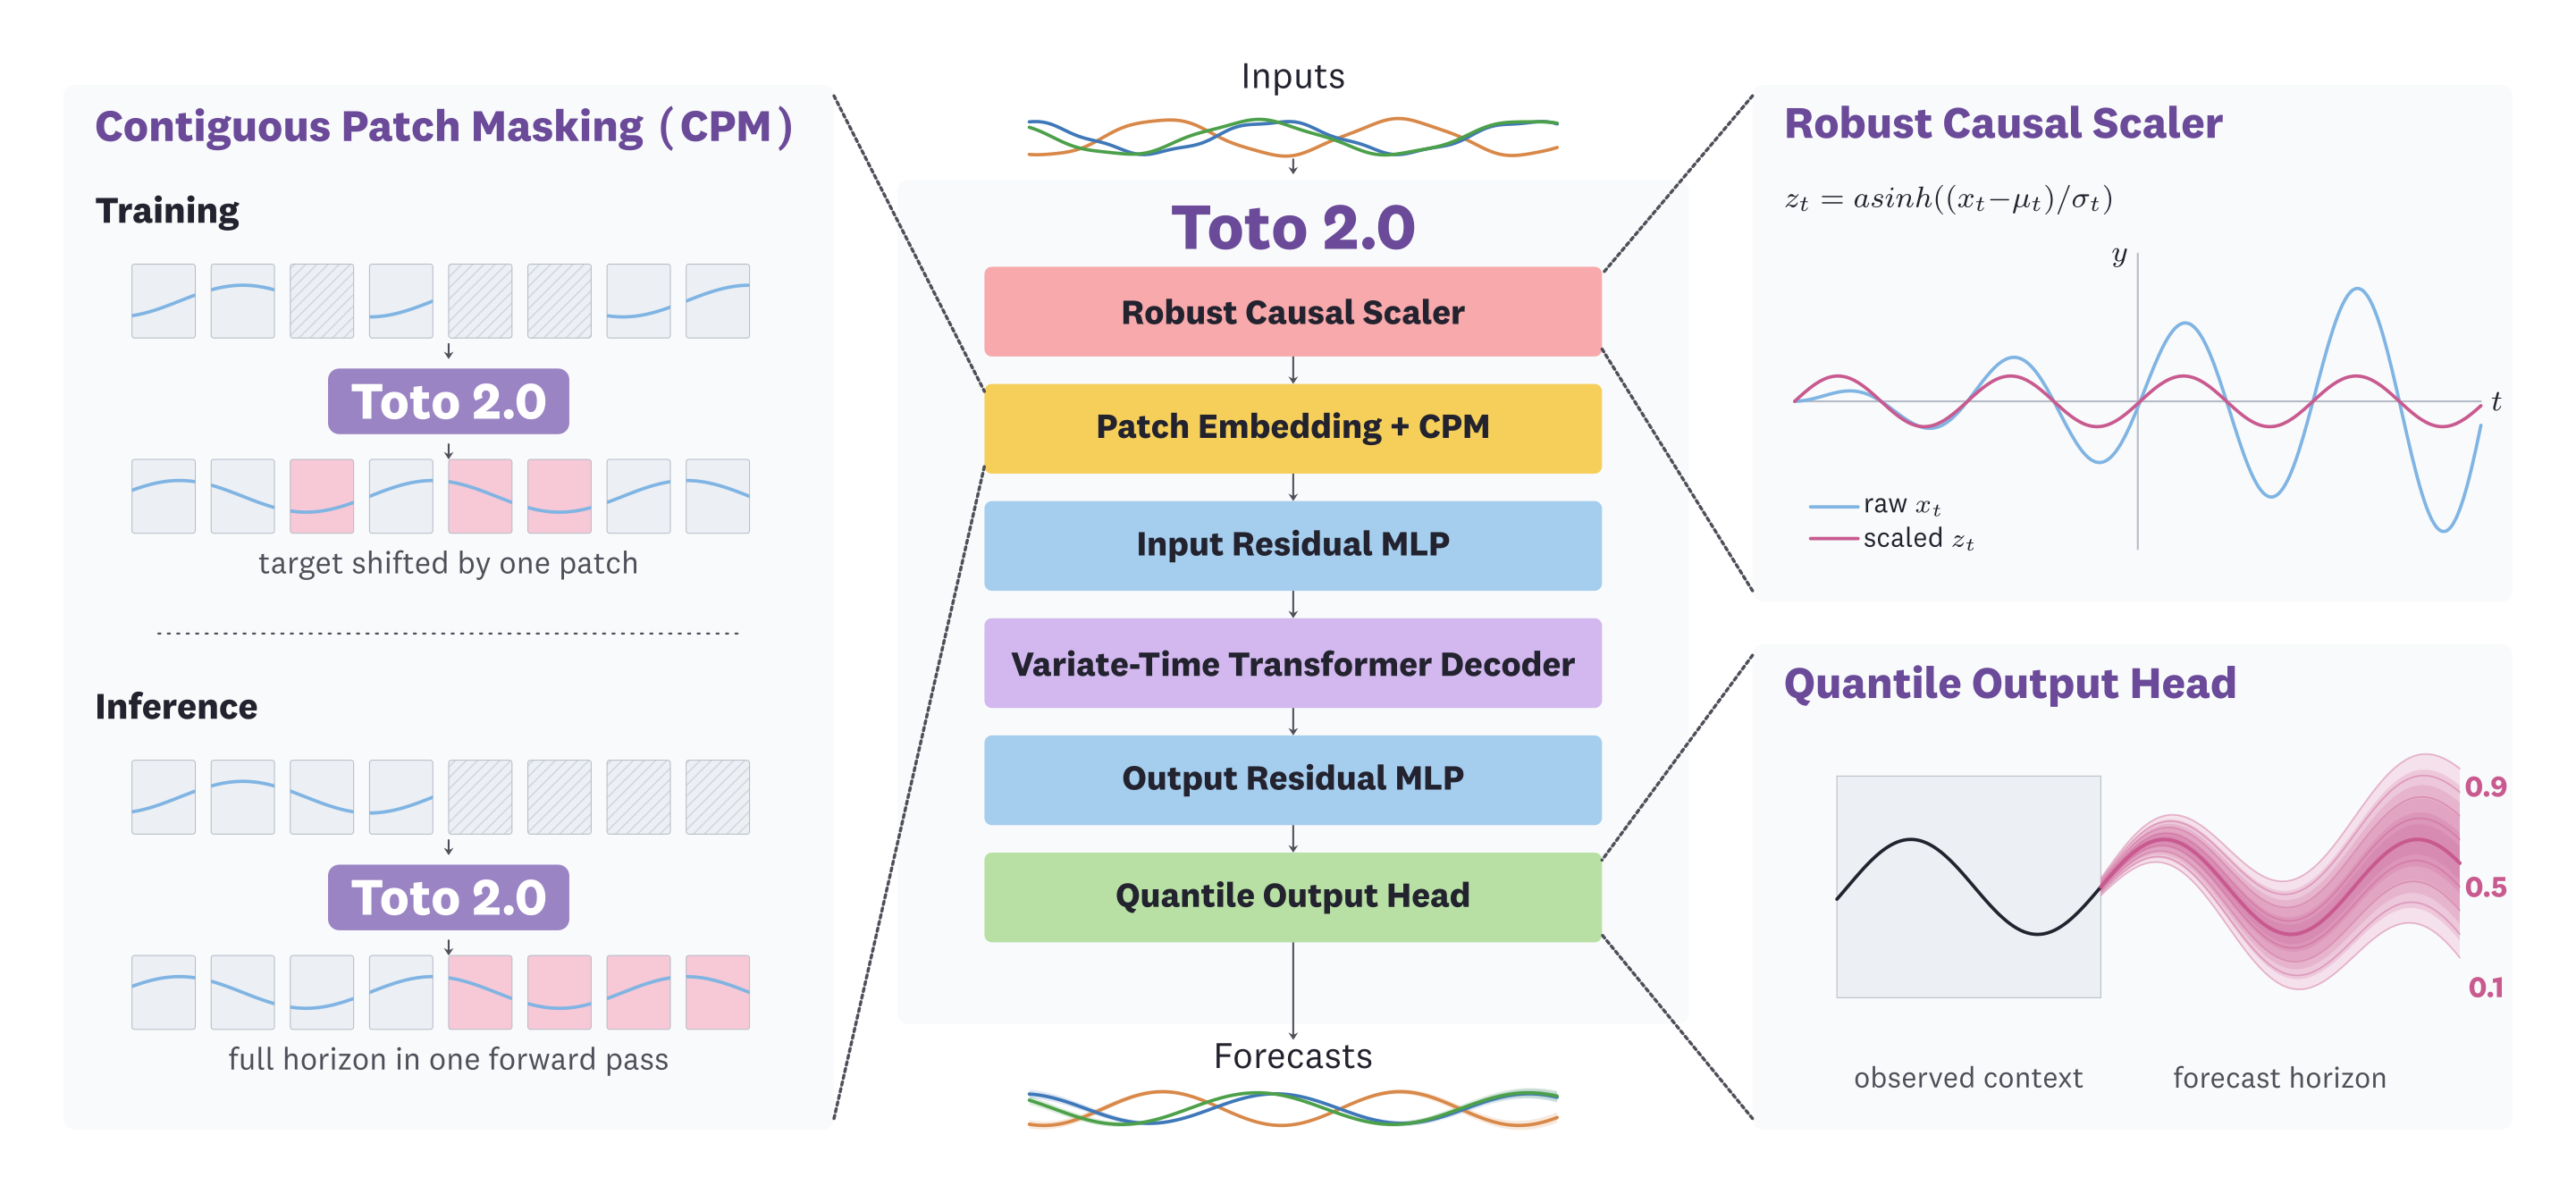
官方模型示意,来源:Datadog 的 Toto-2.0-22m 模型卡;英文标签,可打开原图查看。
它面对的曲线,未必有整齐的周期
监控指标里常见长时间为零、偶发尖峰、突然换挡和大量相似实例。Datadog 的 BOOM 数据集说明就列出了这些特征:数据来自内部预生产环境监控,不包含客户数据。它让研究者能在更接近监控信号的材料上比较模型,而非只看平滑的销售或用电曲线。
这也是我会把 Toto 留给监控预测读者的原因:它有明确的问题背景和配套评估材料。但预测范围不等于事故告警,变量之间一起变化也不等于模型找到了故障原因。是否触发告警,还需要结合业务阈值与历史误报情况另行设计。
2.0 同时提供五种参数规模,从 4m 到 2.5B。官方介绍区分了单次并行预测与分块解码:前者偏向速度,后者用前一块的中位数继续生成,更着眼于长区间的稳定性。其长预测实验使用合成多周期信号,即使较大模型也没有消除所有结构退化;不能把图上的长程规律直接当作真实服务的长期保障。
开始前,先分清两代能力
当前仓库说明明确写着:2.0 的微调和外生变量支持仍待后续提供,有这两项需求时应看 1.0。已知的未来活动安排、发布计划等信息,不能因为 1.0 支持外生变量,就默认能直接喂给 2.0。
仓库代码与 2.0 权重采用 Apache 2.0;公开 BOOM 数据卡也标明 Apache 2.0,这不意味着全部预训练材料随权重一并公开。官方环境要求包含 Python 3.12 与 PyTorch 2.5 以上,并推荐合适的 CUDA 设备。它更适合作为监控预测实验的起点:先拿自己的历史片段做回放,看中心预测和范围是否有用,再决定采用哪个规模。
以上为编辑整理,功能、许可与使用条件以官方说明为准。