
V-JEPA 2:先预测视频中的变化,再让机械臂选择动作
为什么值得关注
展示视频自监督表征怎样通过动作条件后训练进入机器人规划,使未来状态预测服务实际动作选择。
适合谁:关注世界模型、视频理解与机器人学习的 AI 读者
这次有哪些亮点
- 以遮挡特征预测学习视频表征
- V-JEPA 2-AC 在表示空间预测动作后的状态
- 基于当前与目标图像开展闭环机器人规划
使用前需要知道
视频编码器本身不是完整控制系统;机器人实验限于指定机械臂和桌面任务,抓放还提供中间目标图。仓库含 2.1,本文不混用其结果。
给机械臂看一张杯子被移到指定位置的目标照片,它怎样决定下一步往哪走?Meta 的 V-JEPA 2 研究提供了一条值得理解的路线:先从大量视频学习场景随时间变化的表征,再加入机器人交互数据,预测采取某种动作之后会怎样,最后选择更接近目标的动作。
它适合关注世界模型、视频理解和机器人学习的读者。这项研究的吸引力在于,观察视频学到的东西,可以成为规划动作的基础。本文聚焦 V-JEPA 2 与动作条件版本 V-JEPA 2-AC;当前仓库还收录 V-JEPA 2.1,后者的密集特征方法与评估不能混算到这里。
模型预测的,是场景的内部表示
V-JEPA 2 训练视频编码器时,会遮住视频中的部分信息,让模型根据可见内容预测被遮住部分的特征。它首先要学到“场景里有什么、发生了怎样的变化”,而无需把每一处像素都重画出来。得到的视频表征还可以接上不同任务的读出模块。
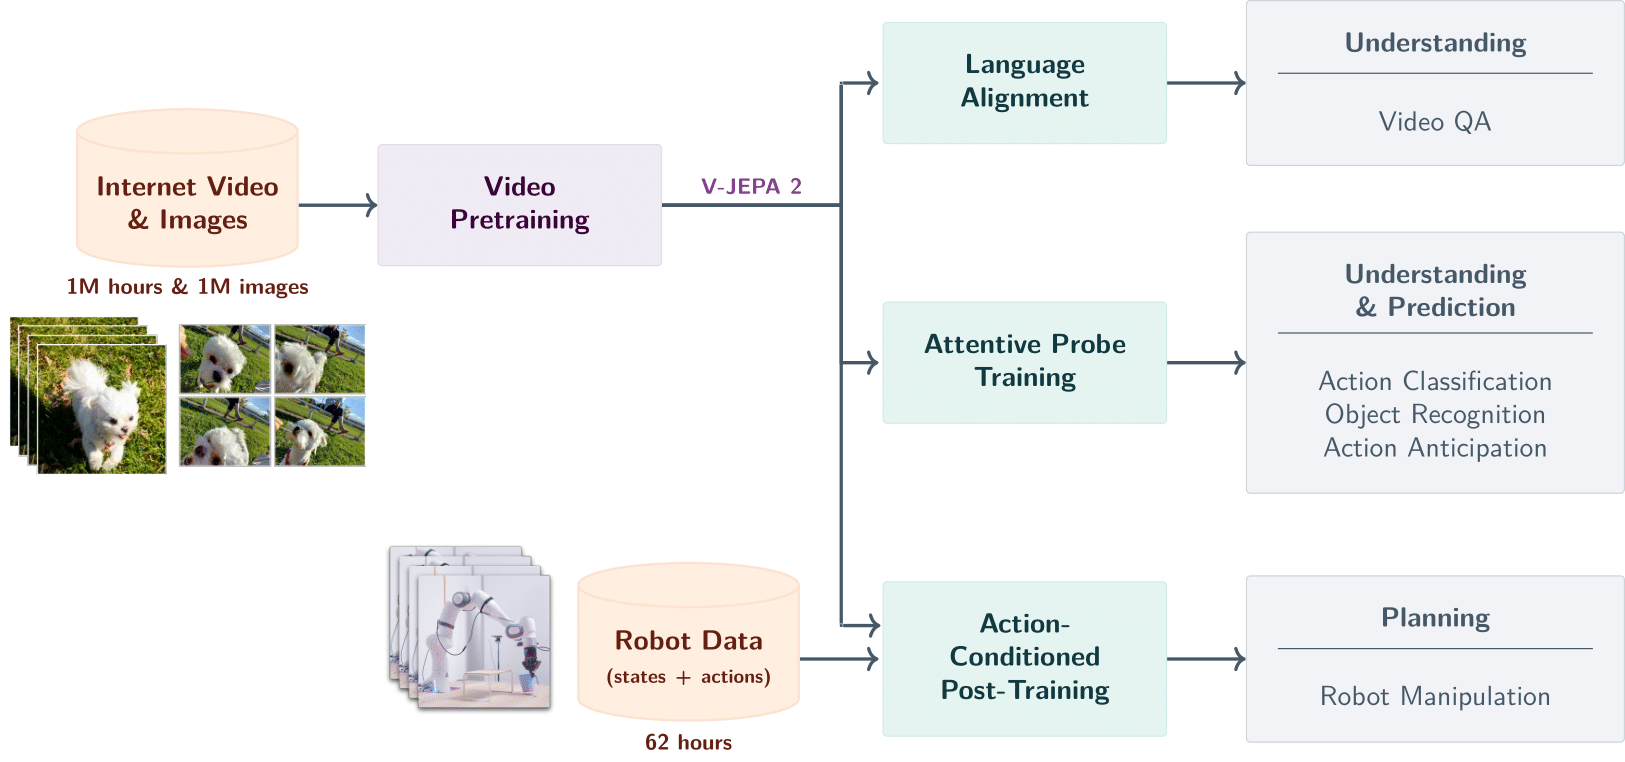
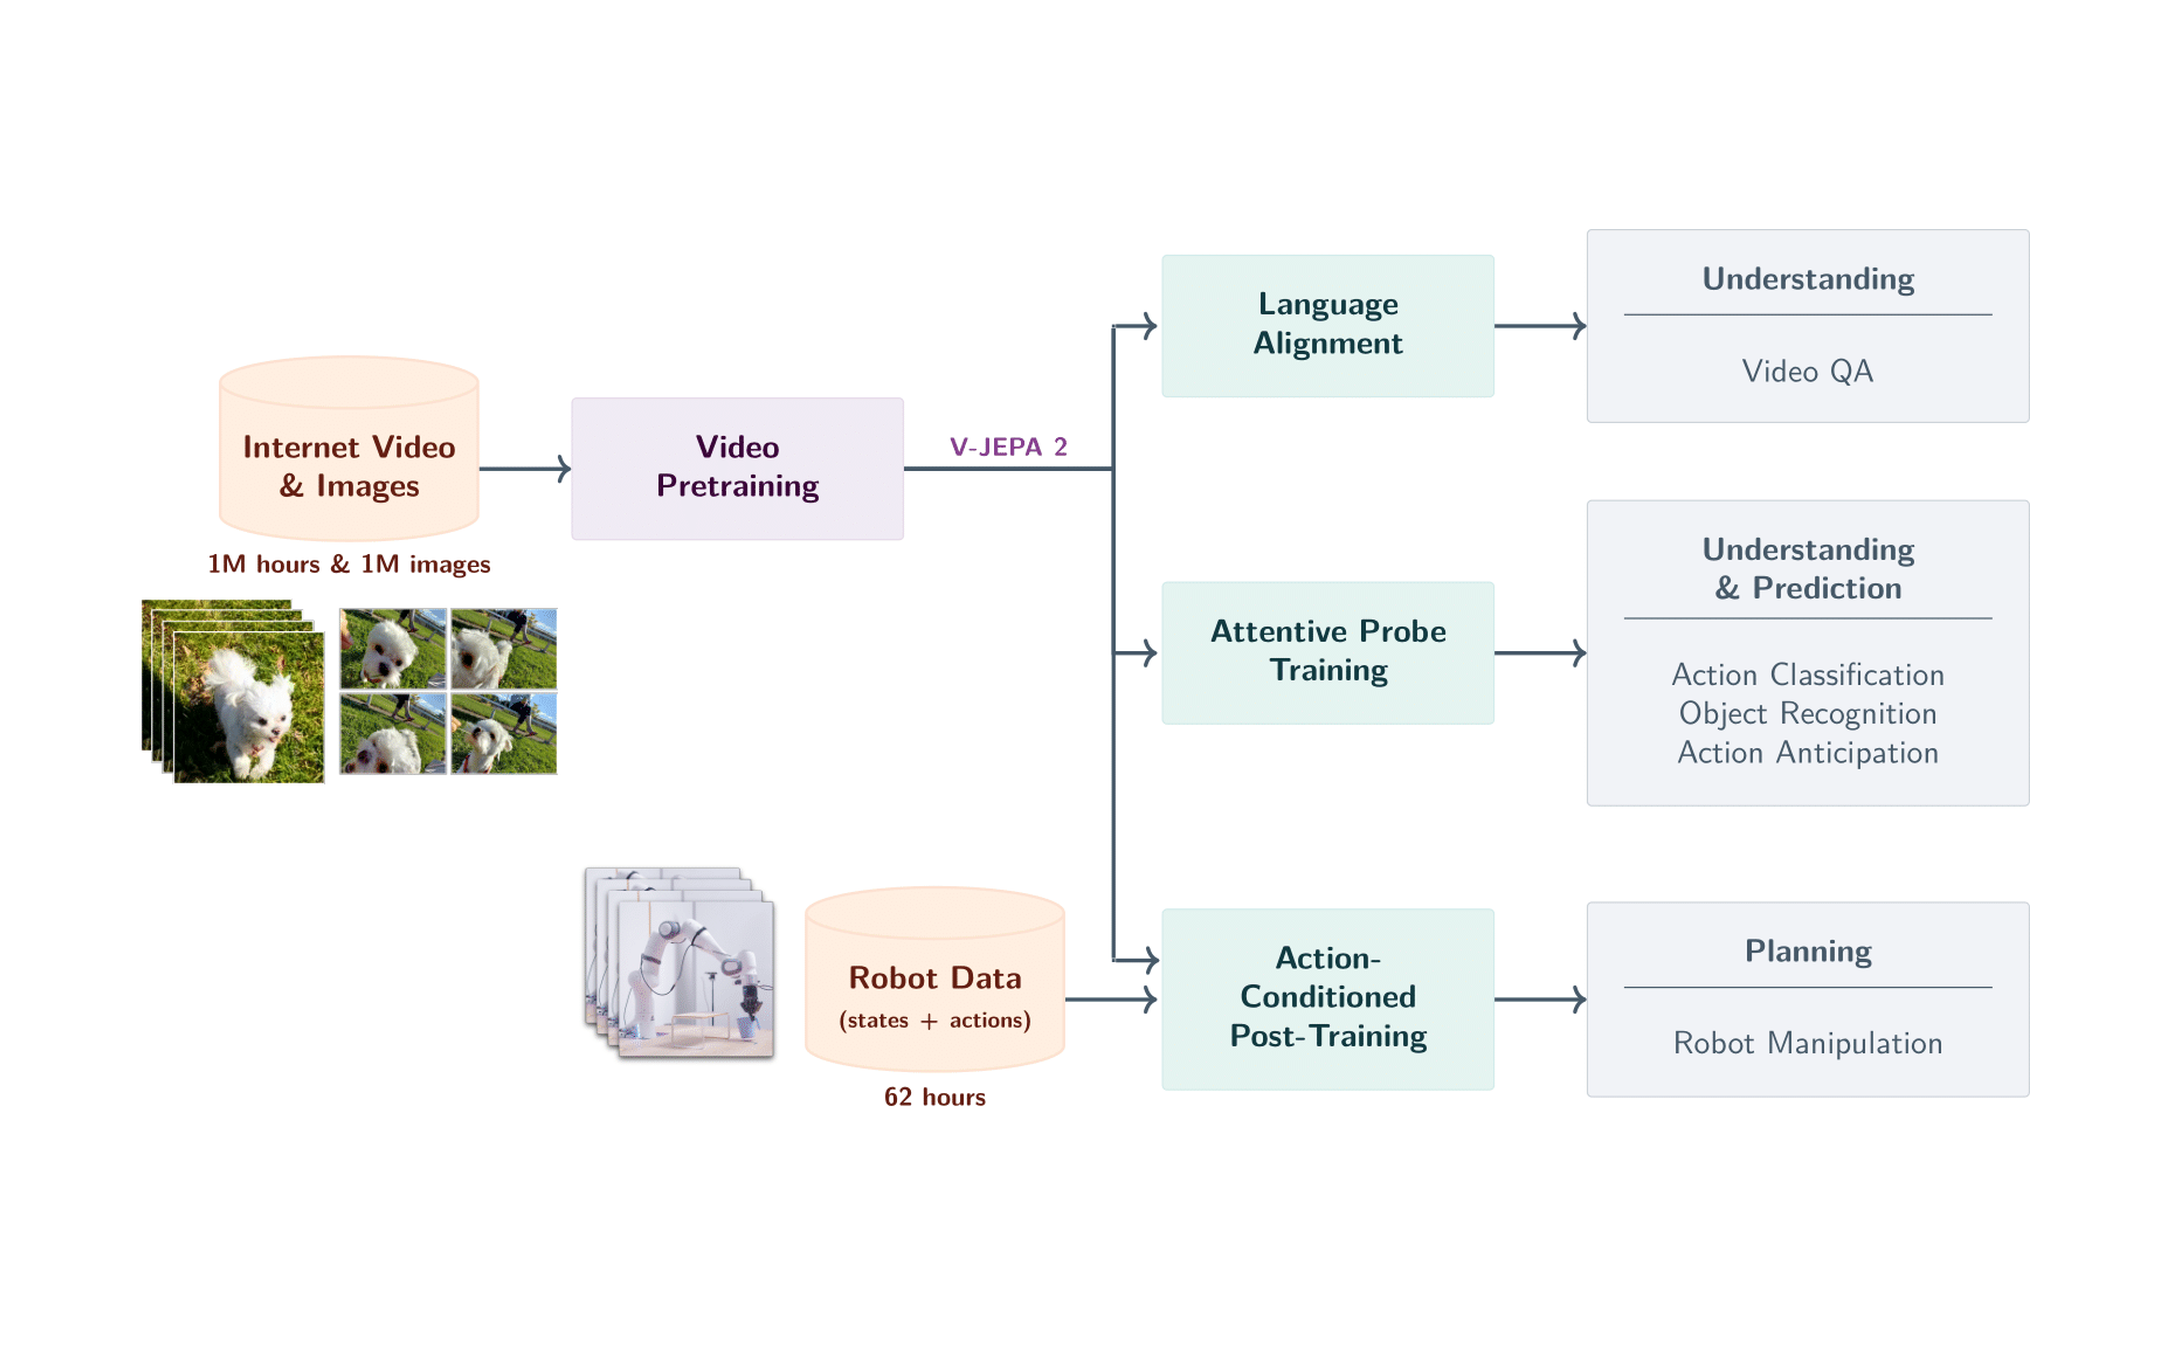
官方流程图。上方分支连接语言对齐与视频问答,中间分支用于动作分类、识别和动作预判;下方额外接入机器人数据,才通向动作条件模型与规划。来源:官方仓库。打开原图可阅读各分支。
这个分叉很重要。公开的 V-JEPA 2 视频模型可以承担视频分类、检索的表征提取,或作为视觉语言模型的视频编码器;问答需要相应语言对齐,控制机械臂则要走动作条件训练与规划流程。下载一个编码器,不等于同时得到这三种完整应用。
跟着论文的抓放任务看输入与输出
先看机器人这一支。研究者用 DROID 数据中的视频及机械臂末端状态,对 V-JEPA 2 做动作条件后训练。模型接收当前观察和候选动作,预测未来观察会处于怎样的特征状态。论文使用的这部分数据不足 62 小时,但其基础模型此前已经在超过百万小时的互联网视频上预训练,不能把整个训练成本缩成“只看几十小时”。
部署时,当前摄像头画面和目标照片先被编码到同一个表示空间。规划器提出多种动作序列,模型推演各序列的未来状态,比较哪一种更接近目标;选定后,机械臂先执行第一步,再根据新观察重新规划。输出最终是控制动作,内部预测也就有了可供现实任务使用的落点。原论文第四节交代了这条闭环流程。
其中抓取任务使用目标图像;抓起再放到另一处的任务,还额外提供“已抓住物体”和“接近目标位置”的两张中间目标图。这一细节会改变我们对能力的理解:研究已经展示了根据图像目标规划动作的可行性,同时仍由人安排了较长任务的关键阶段。
有实验结果,也有清楚的场景范围
作者把 V-JEPA 2-AC 部署在两个实验室的 Franka 机械臂上,使用单目 RGB 相机,测试接近、抓取和抓放等桌面操作。这些环境不在 DROID 训练数据中,部署时没有为各任务再收集当地训练数据。不过它们仍是指定机械臂、物体和控制方式下的实验,不能扩写成任意机器人进入任意房间都能工作。
我的判断是,这项研究最值得记住的突破口是“用特征空间里的未来,服务真实动作的取舍”。它没有要求先把未来视频生成得足够好看,规划目标也不是一段文字回答。观察、预测、比较、执行的链条,比一句笼统的“理解物理世界”更能说明它已经做到哪一步。
想先看视频这一端,可以从ViT-L 模型卡入手:官方示例取视频帧、做预处理,然后提取视频嵌入,得到的是特征张量,后续任务还需相应模块。该型号模型卡标为 MIT;仓库主体代码也是 MIT,另有少数文件采用 Apache 2.0。训练视频来源与数据集条款须另看,不能由代码许可推出视频也可任意再分发。
本文解析官方资料,未运行视频模型或机械臂。对想理解世界模型的读者,沿着这条真实输入输出路线读论文,能够看清视频编码器、动作条件模型和规划器分别承担什么,也更容易分辨演示里哪些能力来自学习,哪些任务条件仍由人提供。
以上为编辑整理,功能、许可与使用条件以官方说明为准。