
Wav2Lip:研究视频配音口型时,先划清旧模型的非商用范围
为什么值得关注
提供一个可检查的口型研究入口,同时避免把商业API的新型号能力误算到旧开源权重。
适合谁:研究口型同步、能配置Python环境的开发者与非商业实验创作者。
这次有哪些亮点
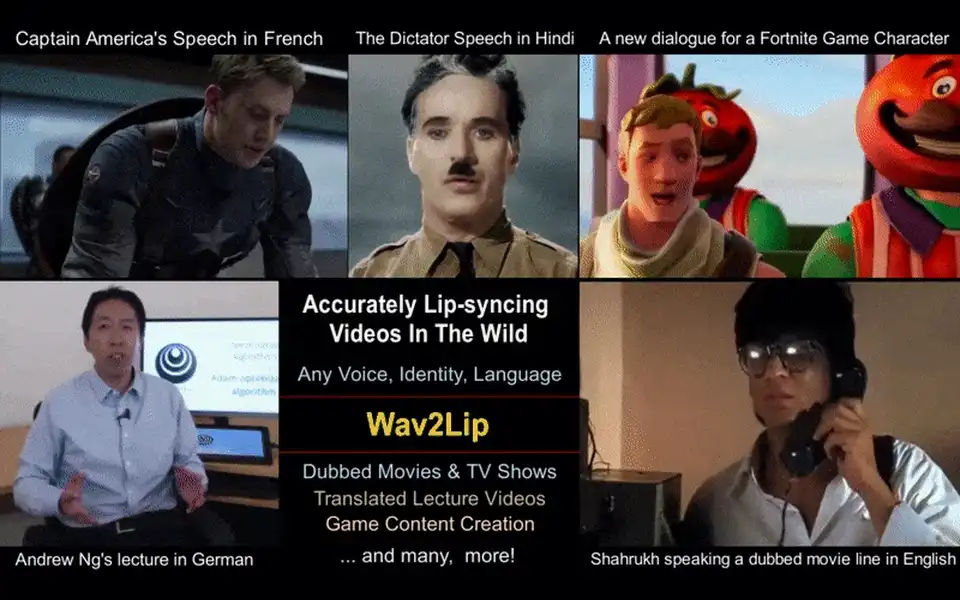
- 视频或图片与新音频生成口型同步结果
- 裁框下沿、检测平滑与缩放影响嘴部呈现
- 仓库旧模型限个人研究非商业,与sync商业服务分开
使用前需要知道
旧代码与权重禁止商业使用;依赖较老,输出脸部细节有限,肖像和音频仍需授权;不能直接用于客户广告交付。
给人物视频换一条配音,最明显的违和往往是嘴与声音对不上。Wav2Lip 是经典的音频驱动口型同步项目,仍适合研究“视频加新音频怎样得到同步结果”。但开头必须讲清:本稿介绍仓库里的旧研究代码与权重,它们只限个人、研究与非商业用途,不能直接用于客户广告或商业数字人交付。
现在官方仓库的README前半部分介绍sync商业服务和 lipsync-2 API,后半部分才是2020年论文的非商业开源版本。两者的模型、费用、部署方式和许可不同。看到同一个仓库出现新的API示例,不能推定旧权重随之升级、转为商用或获得新模型画质。
旧版推理的输入很具体:指定checkpoint、包含人脸的视频或图片,以及音频文件;默认输出到 results/result_voice.mp4。音频可来自WAV、MP3或含音轨的视频,FFmpeg负责相关处理。模型修改嘴部呈现,不负责写讲稿、翻译或生成目标人物的声音,配音应事先准备好。
一个合适的个人研究任务,是用自己录制的正面短视频与另一条本人录音比较口型。先只取一个没有转场的小段,确认全程能检测到脸,再生成结果,观察闭口音、较大张口和停顿。这个任务是编辑示例,未执行,不表示已验证某种语言的精度。输入人物或声音属于他人时,也仍要确认允许合成与发布。
官方建议最值得先查的是人脸框。下巴没有进入处理范围,容易让嘴部边界显得突兀,可以通过pads增加底部留白。若出现嘴巴位置错开甚至双嘴,文档提示可能与人脸检测的过度平滑有关,可比较nosmooth设置。源视频分辨率也不是越高越好;模型在较小人脸上训练,官方建议必要时降低分辨率试验。
源码进一步说明,静态图片可单独设置fps,而视频输入应尊重原视频帧率;crop可缩小检测区域,适合画面有多个人脸时明确目标。固定box只是检测失败时的最后手段,并且更适合脸部不大移动的片段。这些参数影响的是裁剪与处理位置,不会自动解决遮挡、极端侧脸或输入画面里的所有问题。
权重也有取舍:普通Wav2Lip偏重同步,带GAN版本偏重视觉质量,官方提醒两者并非后一种在所有指标上都更好。正确做法是固定同一段输入比较,而非只按文件名选“更高级”的版本。对于近距离高清成片,生成的嘴部细节还应和未修改区域一起检查,避免缩略图过关、放大后接缝明显。
环境说明沿用Python3.6与较早依赖,准备权重还包括人脸检测模型。本稿阅读了完整README和推理脚本的参数处理,没有实际安装、推理或评测耗时。官方演示网站此次取证未成功返回,因此也不把该旧在线演示写成目前随时可用的入口。
如果用途是研究同步与裁剪问题,Wav2Lip仍有教学价值;需要商业使用,应另行评估作者的商业授权或当前服务,按其现行型号、计费与条款办理,不能拿开源可下载代替授权。
资料:完整README与用途限制、推理参数源码。
以上为编辑整理,功能、许可与使用条件以官方说明为准。