
WrenAI:让 AI 查营收前,先读懂金额和业务口径
为什么值得关注
把公式、币种、表关联和问答经验保存为团队可审阅的上下文,让反复出现的业务问题有共同的解释依据。
适合谁:已有数据库,反复沟通指标口径并计划使用 AI 查询的业务与数据团队
这次有哪些亮点
- MDL 模型和知识文件分别保存计算结构与业务含义
- 查询前获取上下文并召回既有问答,查询后保存可复用经验
- 模型与规则以 YAML、Markdown 文件维护,便于版本审阅
使用前需要知道
当前主线是智能体语义与上下文层;行列级安全、用户组访问控制和现成商业界面等属于商业边界。核心代码、文档和商标条件分别适用,指标含义仍须业务方确定。
问 AI“总营收是多少”,得到一条能运行的 SQL,并不意味着拿到了可比较的数字。金额是什么币种,顾客姓名为空是否意味着没有顾客,原始订单和整理后的订单该查哪张表,都可能改变答案。WrenAI 当前的切入点,就是把这些含义整理成智能体查询前可读取、团队可以修改的文件。
现在认识 WrenAI,要认准它的主线:它是给现有 AI 智能体使用的语义与上下文层,提供 CLI、SDK 等入口,把数据模型、业务说明和查询经验接到数据库执行过程里。旧版聊天 BI 的印象,已经不足以代表当前仓库。来源:WrenAI 当前项目说明
一个金额字段,为什么还要配一段说明
官方 Jaffle Shop 样例很小,却能说明问题。订单指标文件把总营收定义为订单金额求和,把订单数定义为记录数;业务规则另外写明:订单金额以美元记录,顾客姓名可能因为游客结账而为空。还有一份经过整理的问答示例,把“所有订单的总营收”对应到订单表的金额求和。来源:官方 Jaffle Shop 样例
顺着这些材料看一次查询:输入是“所有订单总营收”,智能体先取相关模型与上下文,参考已有问答,写出针对模型的查询,再由 Wren 引擎执行,输出聚合结果。业务说明则让解释结果的人知道数字的币种。这里解析的是官方样例,没有实际计算营收,也没有把英文样例当成中文问答效果。
我认为这个样例最有价值的地方,是计算公式与业务说明可以分开保存,又一起参与理解。金额求和写在指标里,美元写在规则里;后者不在字段类型中,却直接决定报表标题应该怎么标注。同样,姓名为空也不能直接推导成无效订单。
还要留意样例没有定义的部分:这里的求和不能自动解释为扣除退款、税费后的“净营收”。团队真要问这个指标,需要先补上自己的口径。Wren 能给规则一个位置,规则的含义仍需要业务负责人确定。
把一次说明,变成以后查询的共同背景
Wren 把表、字段、关联和指标写入 MDL,也就是描述数据含义的建模文件;额外的说明与问答放在知识文件中。官方快速开始以整理好的顾客和订单表为对象,明确让智能体跳过原始表和中间视图,再生成模型、关系并验证构建。随后提问时,会依次取上下文、召回相似查询、生成 SQL、执行,并保存可复用的问答。来源:当前 CLI 快速开始
下图中间的四块分别是数据模型、业务知识、历史经验和执行约束;上方是使用这些材料的智能体,下方才是数据库。它展示了当前项目把上下文放在查询路径中的位置,并不是旧版聊天界面的截图。
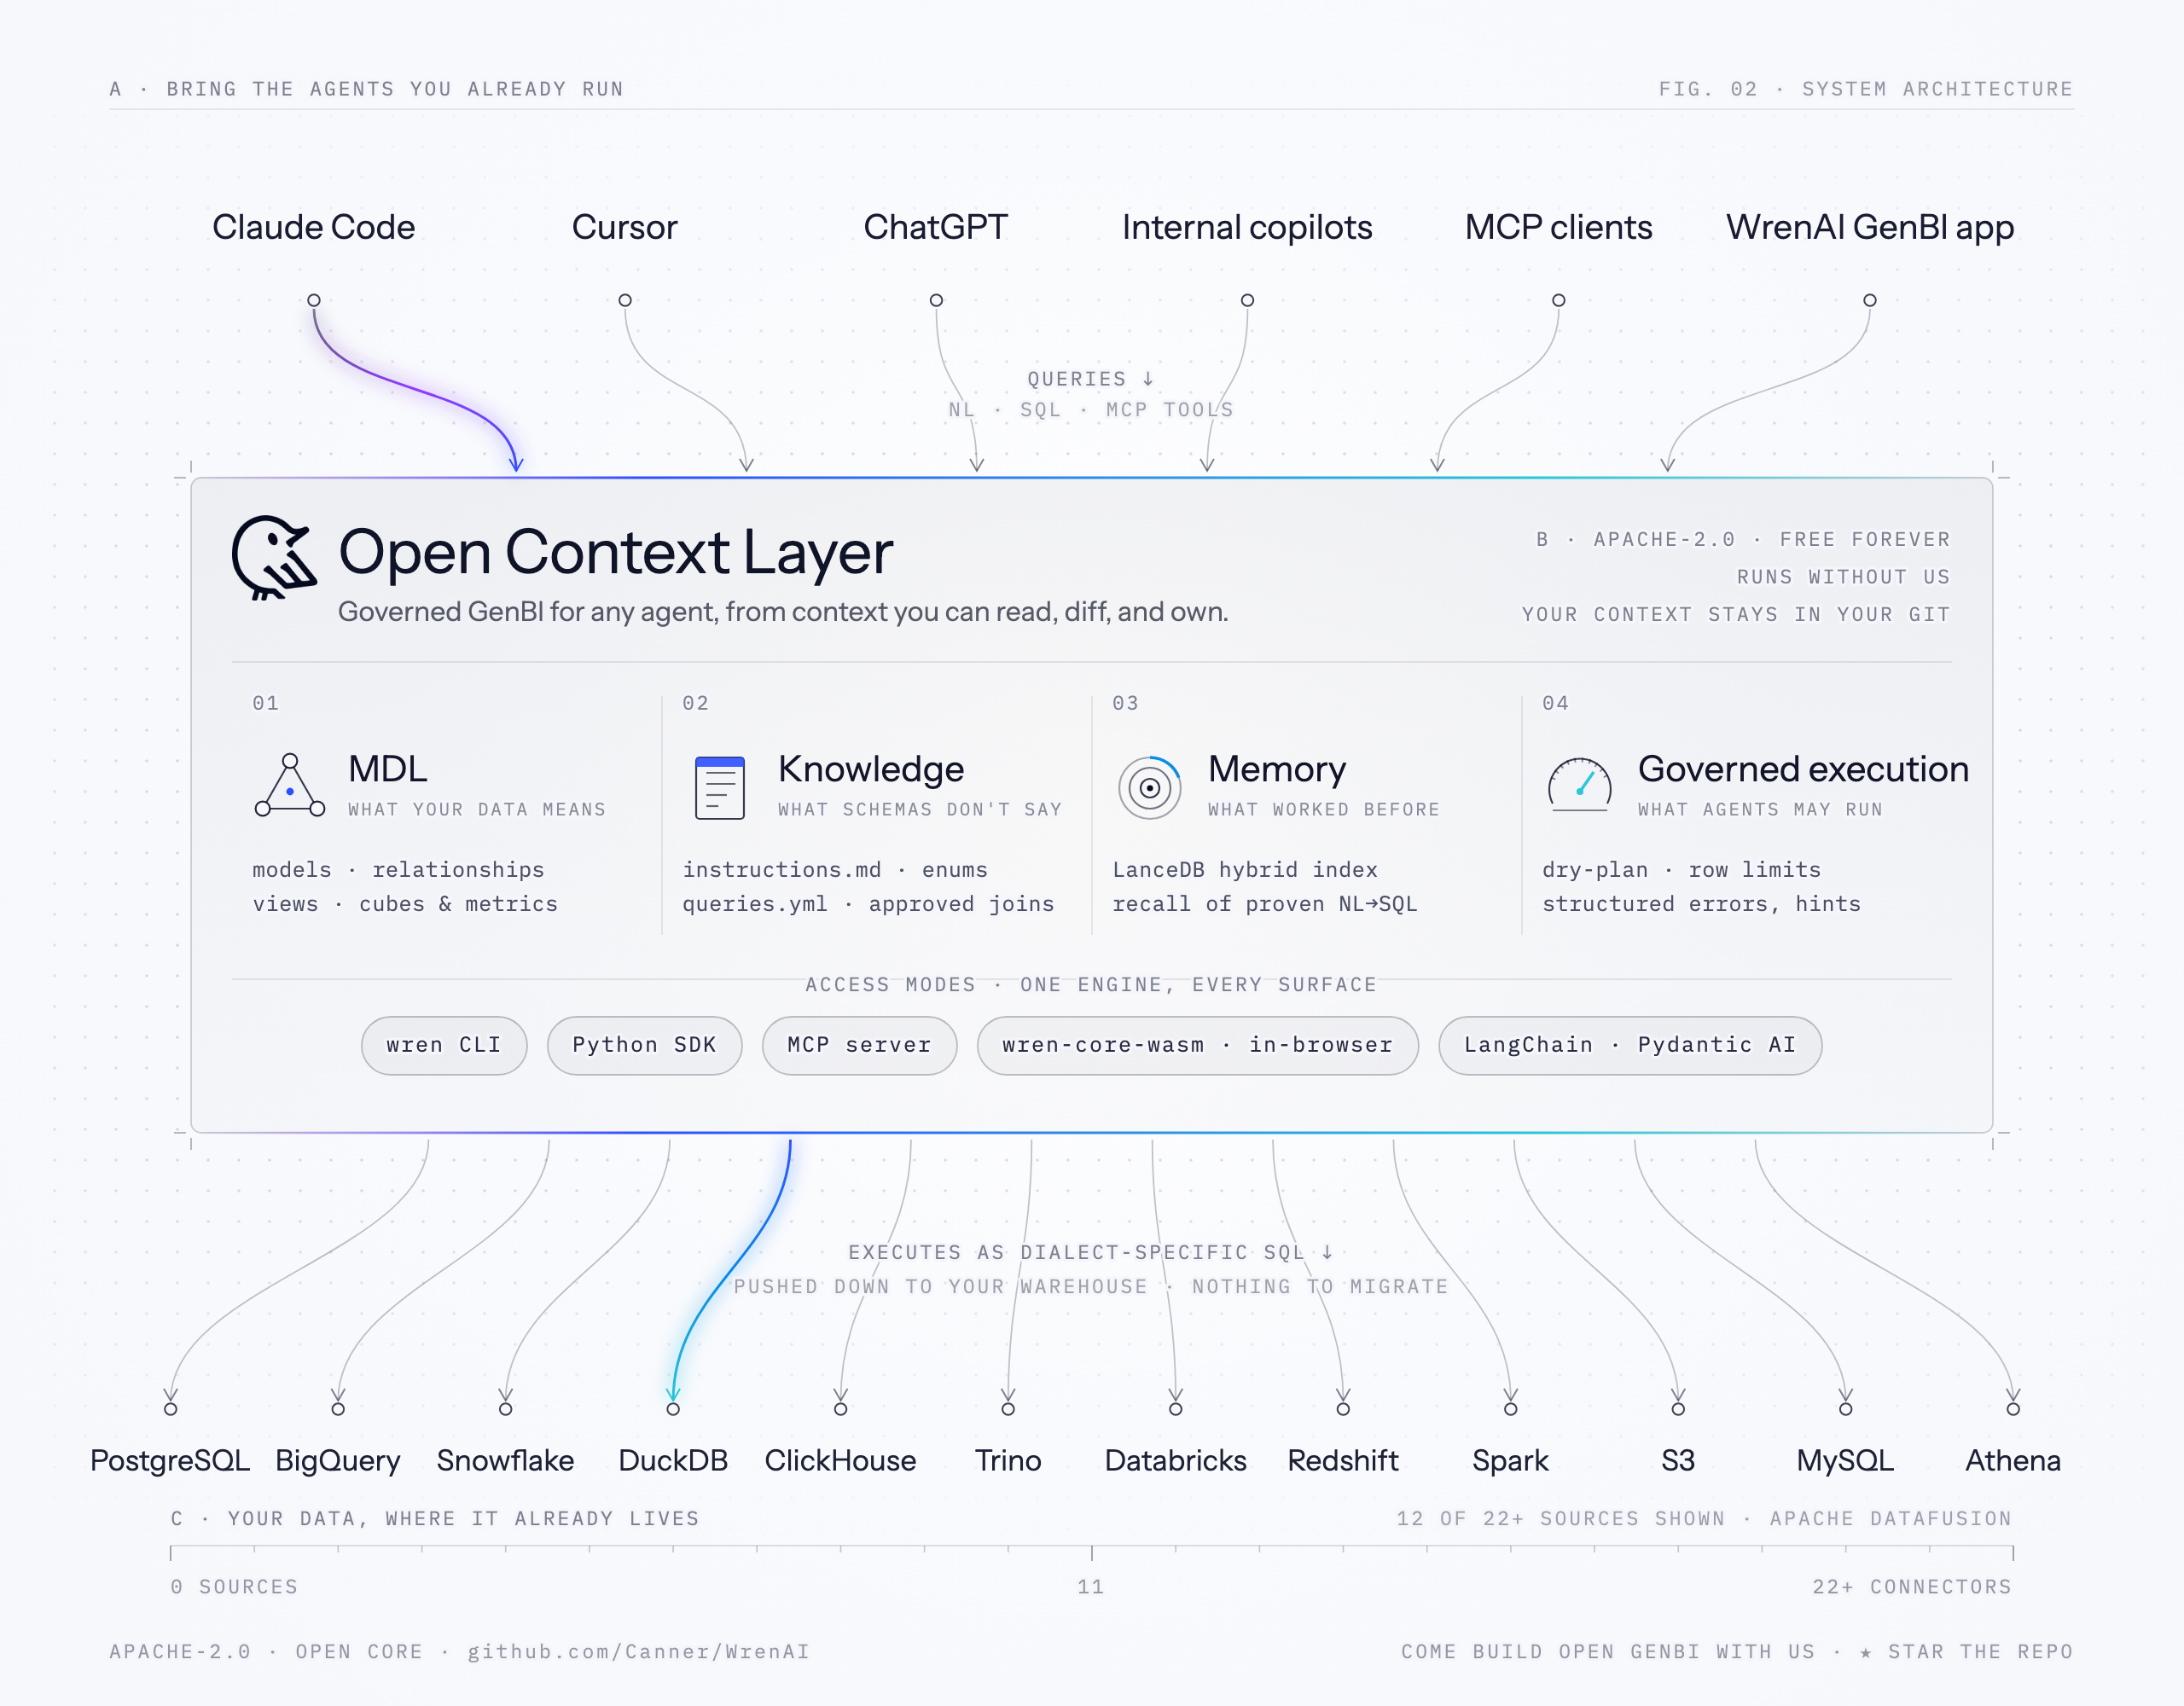
官方示意,来自当前仓库;打开原图阅读各层文字。
这些文件还能进入版本管理。比如把“总金额”改成“只统计已完成订单”,团队可以审阅改动,而不必把一段新提示词悄悄贴进某个人的聊天记录。这对多个人反复问同一套经营数据的团队,比临时做一张图更有价值。
值得投入整理的,是会反复出现的问题
Wren 的开源核心包含语义引擎、CLI 等能力;用户与组的访问控制、行列级安全以及现成的商业 GenBI 界面等,属于官方说明中的商业产品边界,不能从架构图推导为开源版全部自带。当前许可也按目录区分:核心、SDK、技能和示例采用 Apache-2.0,文档采用 CC BY 4.0;商标另行管理。来源:仓库许可映射
如果只是临时分析一份 CSV,维护模型和知识文件未必划算。如果团队已有数据库,又经常为指标定义、关联方式和历史问法反复沟通,WrenAI 提供了一条具体路径:先用官方样例理解这些材料如何共同产生查询,再挑一组真实、反复使用的业务指标整理进去。它的价值取决于上下文是否准确,而不只是接上了多少数据库。
以上为编辑整理,功能、许可与使用条件以官方说明为准。