
列表里“能启动”和“正在跑”不同,Xinference 帮你管理模型实例
为什么值得关注
让多模型试用有清楚的实例身份与资源收尾,避免把模型目录、缓存文件和运行服务混为一谈。
适合谁:在本机或自有服务器试用多个模型、需要管理实例的开发者
这次有哪些亮点
- registrations与list区分可启动模型和运行实例
- model_uid用于取得实例及终止,不只是展示名称
使用前需要知道
引擎、格式、量化和硬件组合需匹配,终止实例不等于删除缓存;社区代码Apache-2.0,Enterprise、Cloud与Model API为另外的商业服务。
在同一台机器试过几个模型之后,最容易混淆三件事:项目支持哪个模型、权重是否已经下载,以及此刻哪个实例仍占着资源。Xinference Community Edition 把这些状态放进一套模型管理接口,值得从这个具体问题认识。
这里讲的是可以自己部署的社区版本。README另列 Enterprise、Cloud 与托管 Model API,它们不是社区包附带的免费计算资源。
先有可启动清单,再有运行实例
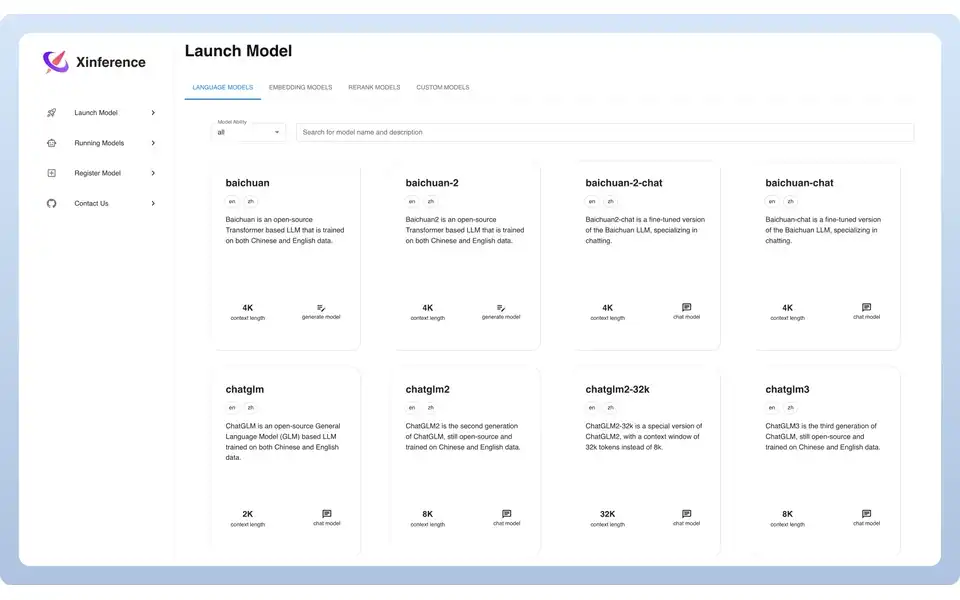
官方使用指南区分 registrations 与 list。前者查看某类可启动模型,后者查看当前正在运行的模型。目录里出现一个名字,并不意味着它已经加载到你的设备。
指南还让用户通过 engine 查询支持的引擎和参数组合。模型名、格式、规模和量化不是互不相关的几个选项:某种格式是否能由选定引擎运行,需要按组合看。
这对界面或脚本很有用。准备启动时展示“可选配置”,运行后再展示“实例状态”,比把所有模型名字都放进同一张看似已经可用的列表更清楚。
model_uid,连接启动与后续调用
官方以 qwen2.5-instruct 为例,launch_model 返回 model_uid,后续 get_model 用这个身份取得模型,再发起聊天。UID 可以显式指定;未指定时,系统生成相应身份,文档示例默认与模型名一致。
教学情境中,试用两个配置时,应用应把实例UID、所用引擎和模型版本一同保存。仅记录“测试了Qwen”,无法说明后来那份结果到底来自哪个运行配置。
客户端版本也要与服务端匹配。统一接口减少了一部分接入差异,并不代表所有引擎、模型和调用参数都可以随意互换。
用完要释放实例,缓存则另管
terminate 按 model_uid 结束运行,释放实例占用的资源。首次启动会下载权重,之后可以使用本地缓存;结束实例与删除已经下载的模型文件,是两种动作。
这一区分能帮助解释常见现象:停止一个模型后,磁盘上的权重仍在;下次启动不一定要重新下载,但重新加载仍需资源与时间。不能把“已经缓存”写成“始终在内存里待命”。
对于模型来源,指南也给出 ModelScope 选项,通过启动环境配置选择来源。它提供另一条官方支持的获取路径,具体文件、访问条件与模型许可仍要按实际来源核对。
Xinference 社区代码采用 Apache-2.0。若你反复试用不同模型,它最直接的成果不是又一个聊天窗口,而是一套可以回查的实例清单:哪些能启动,哪些正在运行,应用正在调用谁,什么时候应当释放。
以上为编辑整理,功能、许可与使用条件以官方说明为准。