
Accelerate:保留自己的PyTorch训练循环,让设备与分布式准备交给一层包装
为什么值得关注
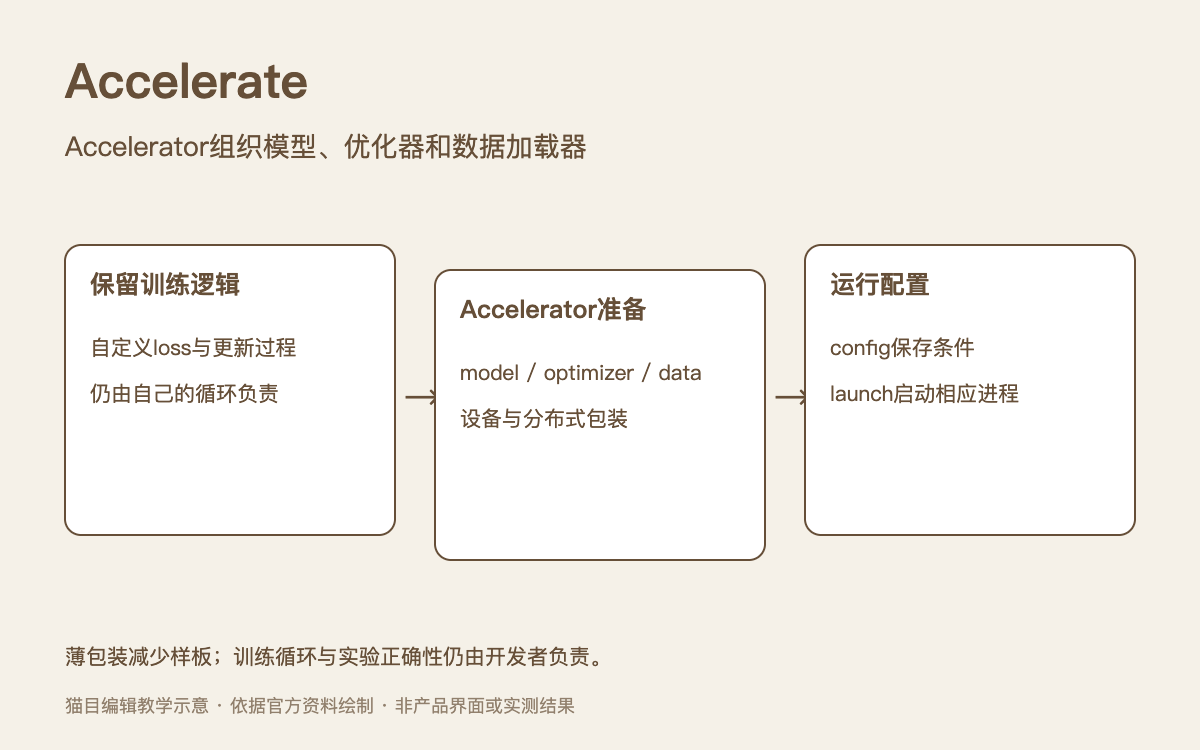
在保留训练循环控制的同时减少设备放置、分布式与混合精度相关重复代码。
适合谁:已有PyTorch训练循环、准备迁移多设备运行的开发者
这次有哪些亮点
- Accelerator准备模型、优化器和数据加载器
- 提供backward及设备处理接口
- 可配置并启动不同设备和分布式运行
使用前需要知道
它不会替你设计或编写训练循环;设备、后端与混合精度仍需兼容。分布式正确性、保存和数据划分需要检查,增加GPU不保证线性加速。
已经写好PyTorch训练循环,想从单卡扩到多卡,最舍不得丢掉的往往是自己的实验逻辑:特殊loss、数据处理、参数更新时机。Hugging Face的Accelerate提供一层包装,让这些代码继续由开发者掌握,同时接管设备放置、分布式准备和部分混合精度工作。
真正需要理解的是,这层包装替你处理了什么,又在哪些地方仍需明确训练含义。下面沿官方示例看一次迁移,再用梯度累计和评估结果说明为什么“脚本能启动”还不是全部。文中的数值分别标明官方教学结果和解释性计算,本文未运行训练。
prepare以后,要继续使用准备过的对象
官方快速导览的接入顺序很短:创建 Accelerator,把模型、优化器、DataLoader与调度器交给 prepare(),再用 accelerator.backward(loss) 替换原反向调用。核心形状如下,省略模型与数据定义:
accelerator = Accelerator()
model, optimizer, loader, scheduler = accelerator.prepare(
    model, optimizer, loader, scheduler
)
for batch in loader:
    optimizer.zero_grad()
    loss = loss_function(model(batch[0]), batch[1])
    accelerator.backward(loss)
    optimizer.step()
    scheduler.step()
重要的不只是多了一次函数调用,而是接回它返回的对象:模型会按分布式设置包装,优化器和调度器采用相应包装,DataLoader则按进程分配数据。继续迭代原来的未准备loader,不能指望它自动获得同样的数据分片行为。
默认设备放置也由它处理,因此官方建议移除硬写的 .cuda()。若确实要手动放置,应使用 accelerator.device,或明确关闭自动放置。这里减少的是设备相关样板;训练目标、前向计算与损失定义仍由原循环负责。README也明确,它不面向不想自己写训练循环的人。
累计两批梯度,为什么不只是晚一点step
当显存放不下期望批量时,可以分几批前向、反向,累计后再更新。最直观的手写方法,是每批反向,只在满足计数时执行 optimizer.step()。但官方教程提醒,分布式下这样可能每批都做梯度同步,产生本可避免的通信。
Accelerate提供 Accelerator(gradient_accumulation_steps=2) 与 with accelerator.accumulate(model): 配合使用。在这个上下文中,prepared optimizer、调度器和 backward 按累计步数协调更新及loss缩放。官方完成示例每批仍写 step(),但并非每个微批都真的更新参数。迁移到这套写法时,原先手动除以累计次数、手动判断步数的逻辑也要按教程撤掉,不能两套处理叠加。
官方还用一个小线性模型作检查:八个输入,目标是输入的两倍,零初始化权重;每批两个、累计四批,与一次使用全部八个输入的更新相比,文档输出的最终权重都是 2.04000。这是用于验证更新等价关系的玩具示例,不是大模型收敛速度或性能评测。它教给读者的检查方式是:先让一小次更新的含义能对得上,再扩大训练规模。
有效批量也应随配置说明。假设准备后的每个进程每批四条、两个进程、累计两批,且样本均匀、没有尾部补齐,那么一次更新对应16条样本。这是解释性计算;只把单卡四条迁到两卡却不改其他设置,就已经改变了每次更新接触的数据量,不能只比较“每步花了多久”。
变长文本,不能平均一下每批loss就结束
语言模型训练还有更隐蔽的条件:每批有效token数不同。官方梯度累计指南说明,token级任务应将累计范围内的总loss,除以全部非padding有效token数;这通常不等于把各批平均loss再平均。
用一组构造数字说明:第一批只有两个有效token,平均loss为1;第二批八个有效token,平均loss为3。直接平均两批得到2,按全部token加权则是 (2×1+8×3)/10=2.6。前者让短批与长批拥有相同权重,改变了训练目标的统计口径。这不是模型结果,而是为何要按有效token归一化的算术解释。
对于内部进行标签位移的Transformers因果语言模型,指南还特别说明有效目标的计数应考虑标签对齐,并避免在collator里再位移一次。通用包装不会替自定义loss判断所有这些语义。若在改累计次数后发现训练变化,除了随机性和设备,还应先核对归一化分母是否一致。
多卡评估时,每个进程只看到了部分数据
快速导览将验证DataLoader也交给 prepare(),再用 gather_for_metrics 汇集预测与目标。因为单个进程只收到一部分评估数据,只在主进程上对自己那部分计算指标,并不是完整验证集结果。
汇集也涉及边界样本。为让数据均匀分给各worker,末尾可能重复一些样本;官方说明 gather_for_metrics 会移除这类重复。动态padding造成各进程张量尺寸不同,则需先按文档用 pad_across_processes 对齐。它们处理的是指标材料的组织问题,不是模型准确率自动提高。
教程末尾给出的真实训练曲线解释也很有用:保持全局批量32的几种配置,在前20步loss一致,之后的细小差异来自首个epoch末尾的数据补齐。官方没有把差异包装成“多卡训练更强”,而是回到DataLoader行为追因。这正是保留训练循环控制权后,开发者仍需要做的工作。
代码与启动条件一起留下
accelerate config保存环境配置,accelerate test检查分布式环境,accelerate launch据此启动脚本;也可以显式传入配置文件。把这份配置与训练代码一起记录,才能知道那次运行用了多少进程和哪种精度。CLI是可选入口,库本身的对象准备与启动器不是同一层责任。
Accelerate还提供大模型推理的权重装载与分配,但那条路线不等于这里的多卡训练。选择它应从现有循环要解决的问题出发:需要继续改loss、观察更新,同时减少环境样板,正合适;需要现成完整训练配方,则更高层工具可能省事。代码为Apache 2.0,模型与数据条件另计。后端、设备和精度仍需兼容,不能凭接口统一就预先许诺线性加速。
以上为编辑整理,功能、许可与使用条件以官方说明为准。