
Anara:让每篇论文回答同一组问题,做出能回查原文的提取表
为什么值得关注
把文献阅读中反复查找的样本、方法和结果变成统一字段,并保留原文位置,便于核对后再用于综述。
适合谁:已收集一批论文、要整理研究特征或筛选记录的学生与研究者。
这次有哪些亮点
- 文件夹内每份文件对应一行、每个问题对应一列
- 有依据的单元格可打开文件、页码与原文
- 区分Not reported、Failed、Waiting等状态
- 支持将整理结果衔接CSV和Excel
使用前需要知道
自动提取不等于完整报告或质量评价;未找到信息需回查原文。免费AI和上传有额度,批量任务需看套餐;上传材料会交给在线服务及模型等提供方处理。
整理文献综述时,你可能已收齐论文,却还在逐篇抄样本量、研究设计和结果。Anara 的 Views 接收一个资料文件夹,把同一组问题分发给每份文件,形成“一篇一行、一问一列”的提取表;有来源依据的单元格还能打开对应原文。它原名 Unriddle,官方更名公告确认旧站与订阅延续到现品牌。
把“帮我综述”改成具体的列
按现行操作文档,在文件夹打开 View → Create view,描述要提取的字段。字段越明确,表格越容易比较;列还可以选择文本、数字、日期等类型。修改问题后要重跑该列,避免沿用旧答案。
整文件夹建立的视图会跟随文件夹:新文件增加行,移除文件删去行;这不代表你修改提取口径后,所有旧格子也会自动按新问题更新。需要刷新整表时再用 Rerun。若文献还在增加,先把字段定义稳定下来,能减少一边换问题、一边比较旧结果的混乱。
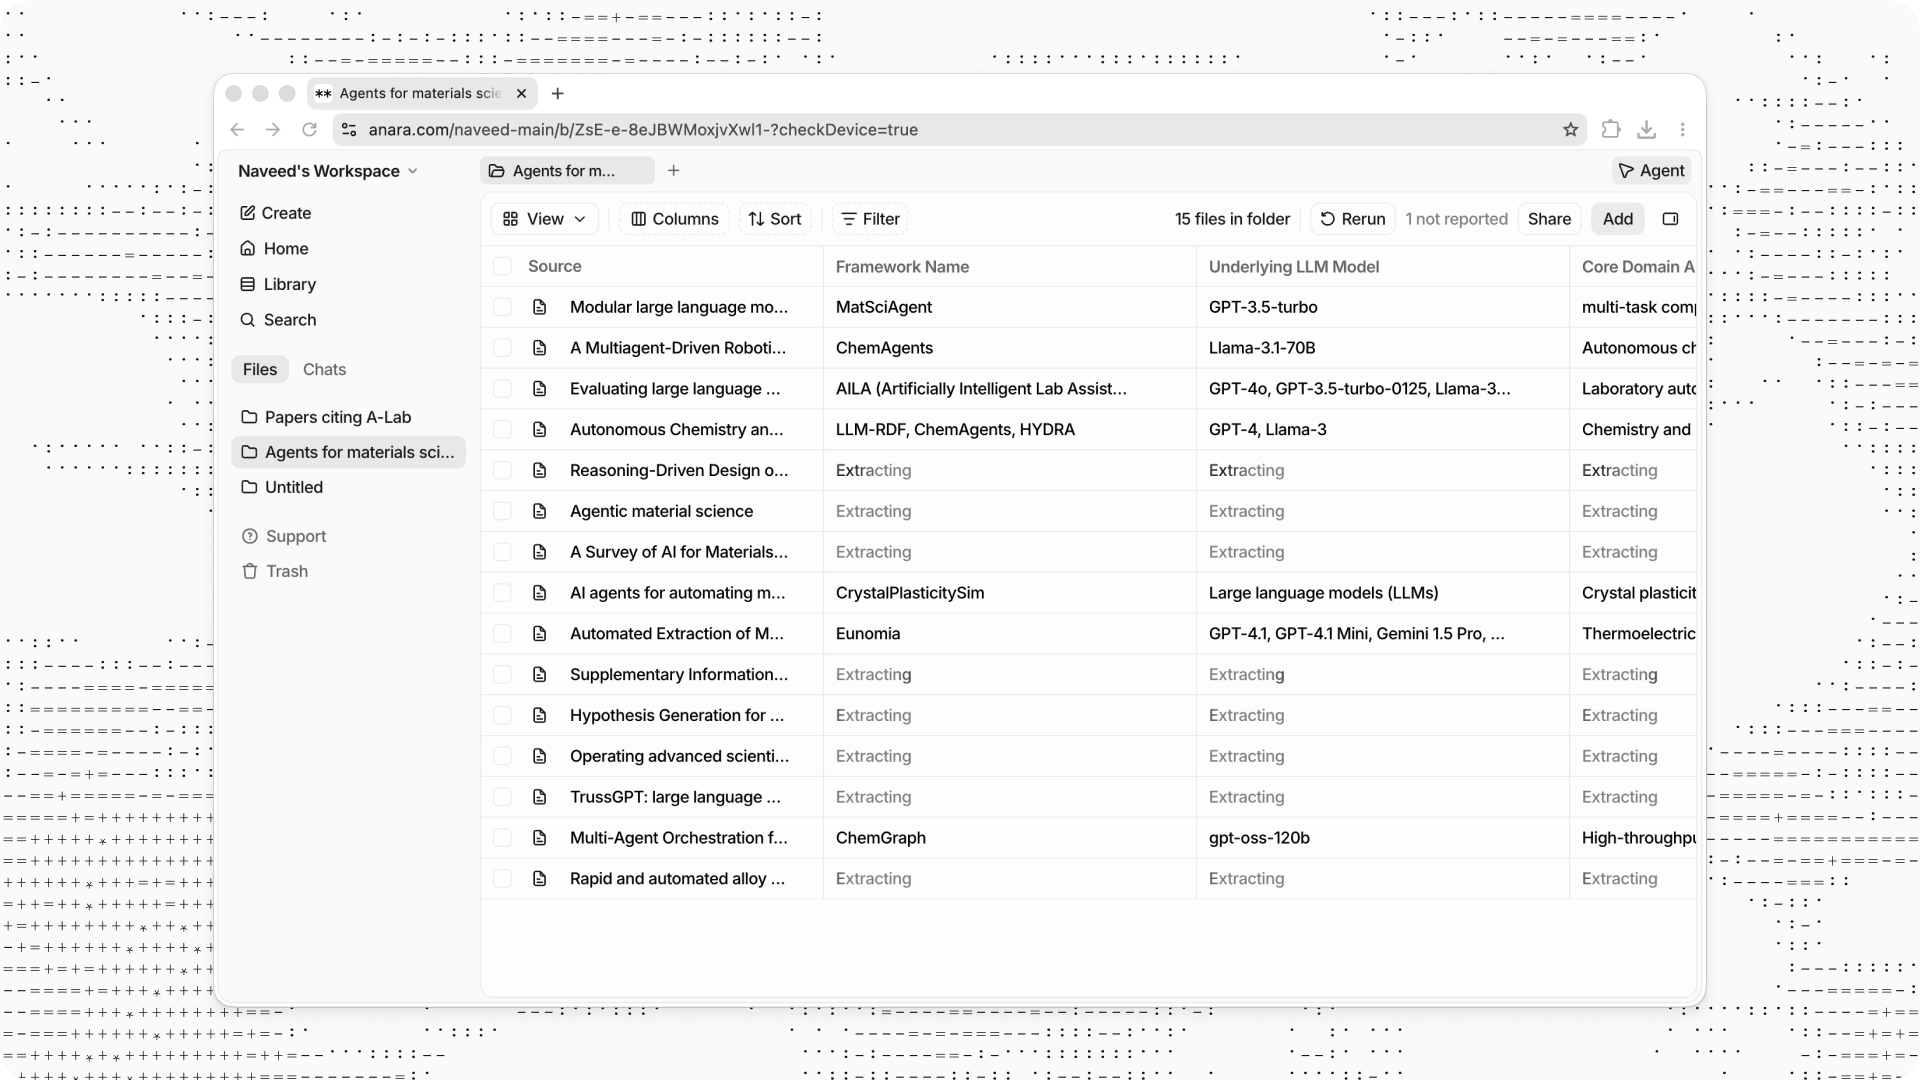
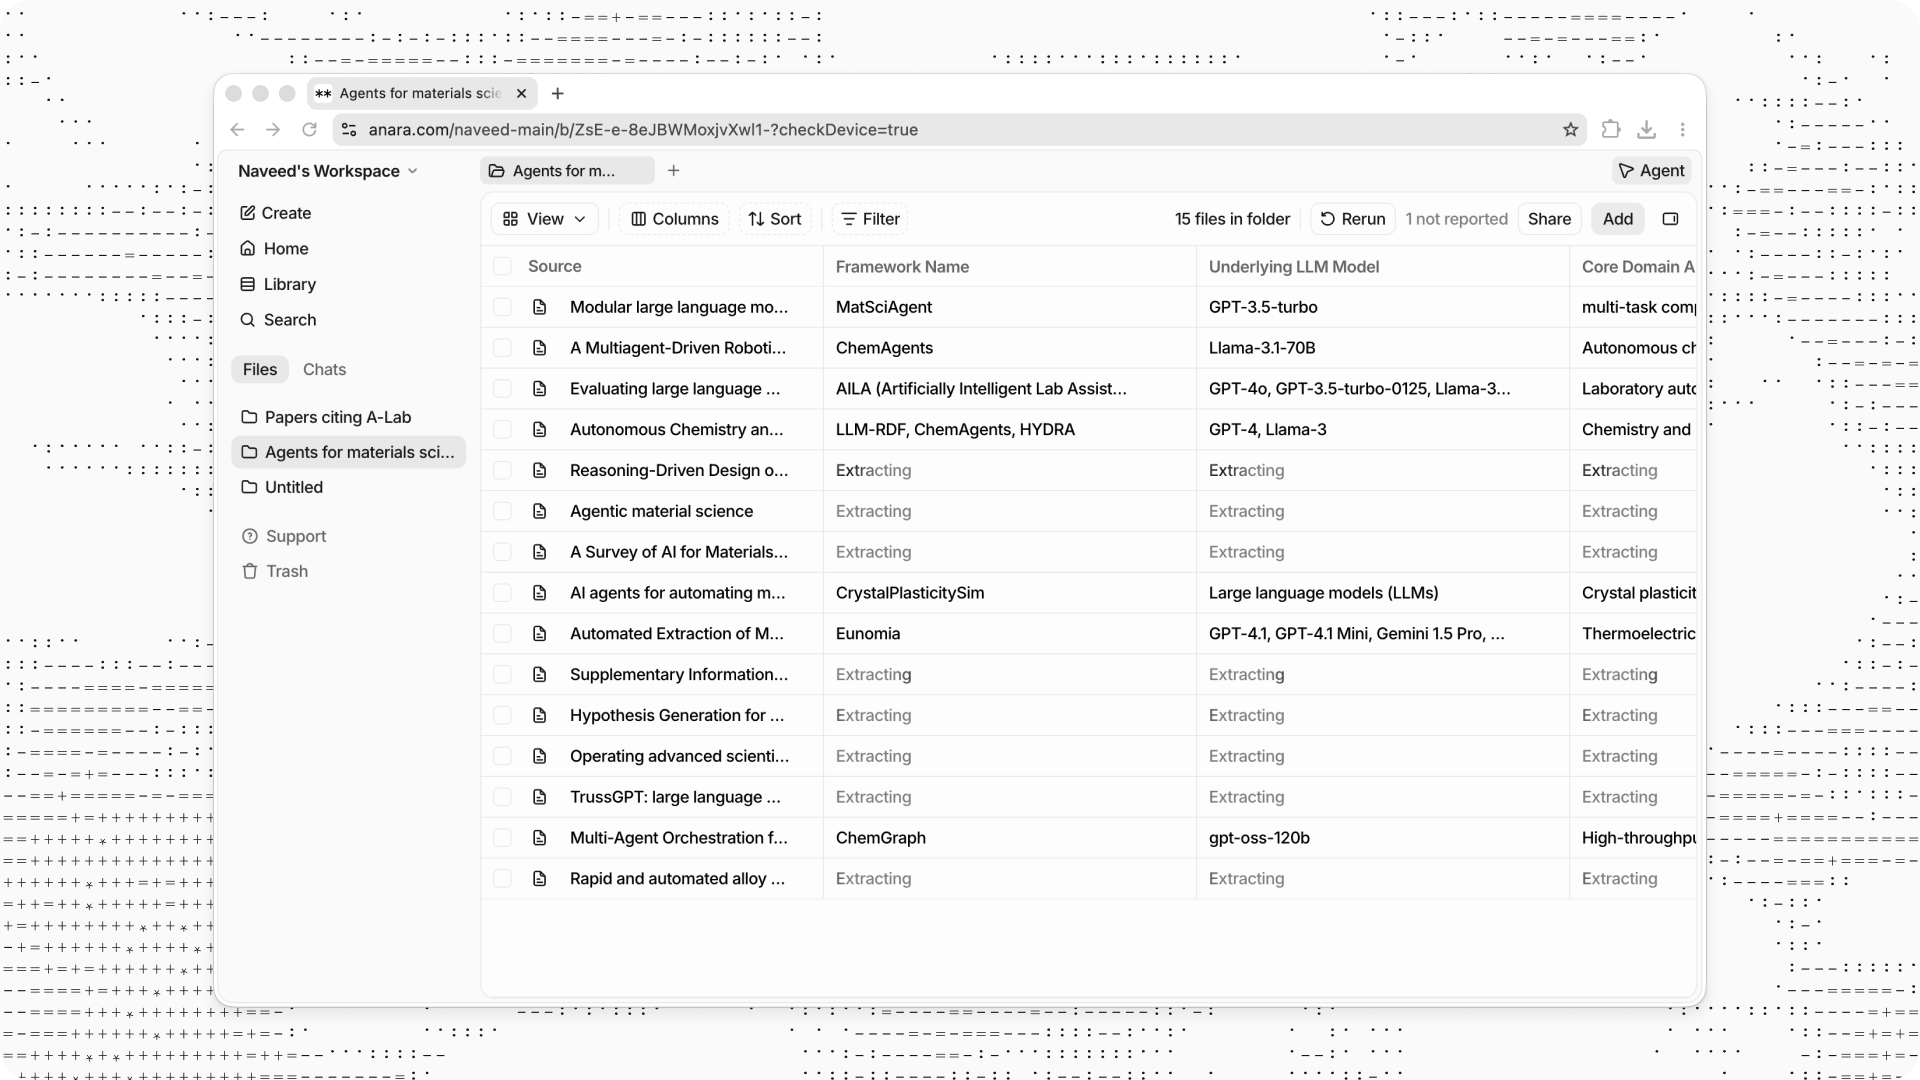
这是官方更新中的截图,展示材料科学文献的字段提取;部分格子仍为 Extracting,不是全部完成的结果,更不是本文的中文任务输出。
一格“没找到”,怎样读才不误判
教学情境:中文任务是“比较在线课程研究中的学习者人数、课程时长与退课率”。准备几篇合法取得的英文 PDF 放进文件夹,输入字段要求:Extract sample size, course duration, dropout rate, and how dropout is defined.
若退课率一列出现 Not reported,文档定义是 Anara 没找到答案,并不证明论文没有报告。先打开文件核对表格或附录,再把问题改成更贴近论文用词的描述。另一个格子若写 Failed,处理的是提取错误,不能把它归入“缺失数据”。本文是资料研究稿,未执行该教学任务。
一列数字,需要一列定义
样本量可以设为 Number,退课定义却更适合保留文字。比如“六周课程未完成”的比例与“中途退出实验”的比例,即使都是15%,也不是同一个结果。作为编辑建议,可以把样本量拆成招募人数和最终分析人数,把课程时长注明单位,再为退课率单设定义列;先在几篇自己读过的论文上核对这些字段,再扩到整个文件夹。
这也是2000单元格上限的实际含义:200份文件各问10项,就是2000格,而不是还能无限增加问题。字段分得清楚会让比较更可靠,列数增加也会占用同一次提取的容量。Views 适合逐文件回答同题;如果真正想问的是跨整组资料形成一个综合判断,官方建议改用文件夹 chat。两种交付物分别是可对照的表和综合回答,选择取决于当前阅读任务。
表格怎样带进后续工作
悬停单元格并打开 Source evidence,可查文件、页码和原文。先核对“退课”指未完成、未登录还是退出实验,再考虑合并统计;数字相同而定义不同,也不应直接比较。首页列明提取表可衔接 CSV、Excel,导出文档也区分了表格与笔记等产物的格式:电子表格当前工作表可出 CSV,整个工作簿可出 Excel。下载后应检查实际保留了哪些列和来源信息,并保留视图入口与原文件,方便合作者回查;仅有一格数字还不足以支撑论文里的统计结论。
从官网注册进入;免费方案对 AI 和上传有限额,当前单文件列为20MB或120页。扫描文档的 OCR 另列在 Pro,不能只看总文件大小就认定扫描件能按普通 PDF 提取。持续批量提取需比较付费额度,导入、提取与聊天都会消耗用量。Views 文档注明图片会跳过,单次填充最多 2,000 个单元格。隐私政策将提示与文件列为收集内容,并列有生成式 AI 服务商;涉及受限研究材料时,应先确认上传权限。
以上为编辑整理,功能、许可与使用条件以官方说明为准。