
BAGEL:让看懂图片与按意思改图接在同一个模型里
为什么值得关注
把图像语义与像素信息一并带入生成上下文,为需要先解释画面、再调整画面的原型提供统一模型路线。
适合谁:研究图像编辑、搭建看图与改图原型的多模态开发者
这次有哪些亮点
- 理解与生成两类 Transformer 专家共享多模态注意力
- 官方示例包含连续肖像编辑与需要知识推断的视觉指令
- 图像保留和文字遵循分别提供引导参数
使用前需要知道
完整权重并非普通轻量看图模型;官方 Gradio 的常规加载面向 32GB 以上显存或多卡,较低显存需考虑量化。局部保真和中文指令效果不由展示图保证。
把一张人物图交给模型,先问画面里有什么,再要求“保留人物,把背景换掉”,两步最好共用对原图的理解。BAGEL-7B-MoT 值得认识的地方,正是把看图回答和生成、编辑图片放进同一套多模态模型。它更适合想搭建图像编辑原型的人:输入可以包含图片和文字,输出既可以是文字,也可以是新图片。
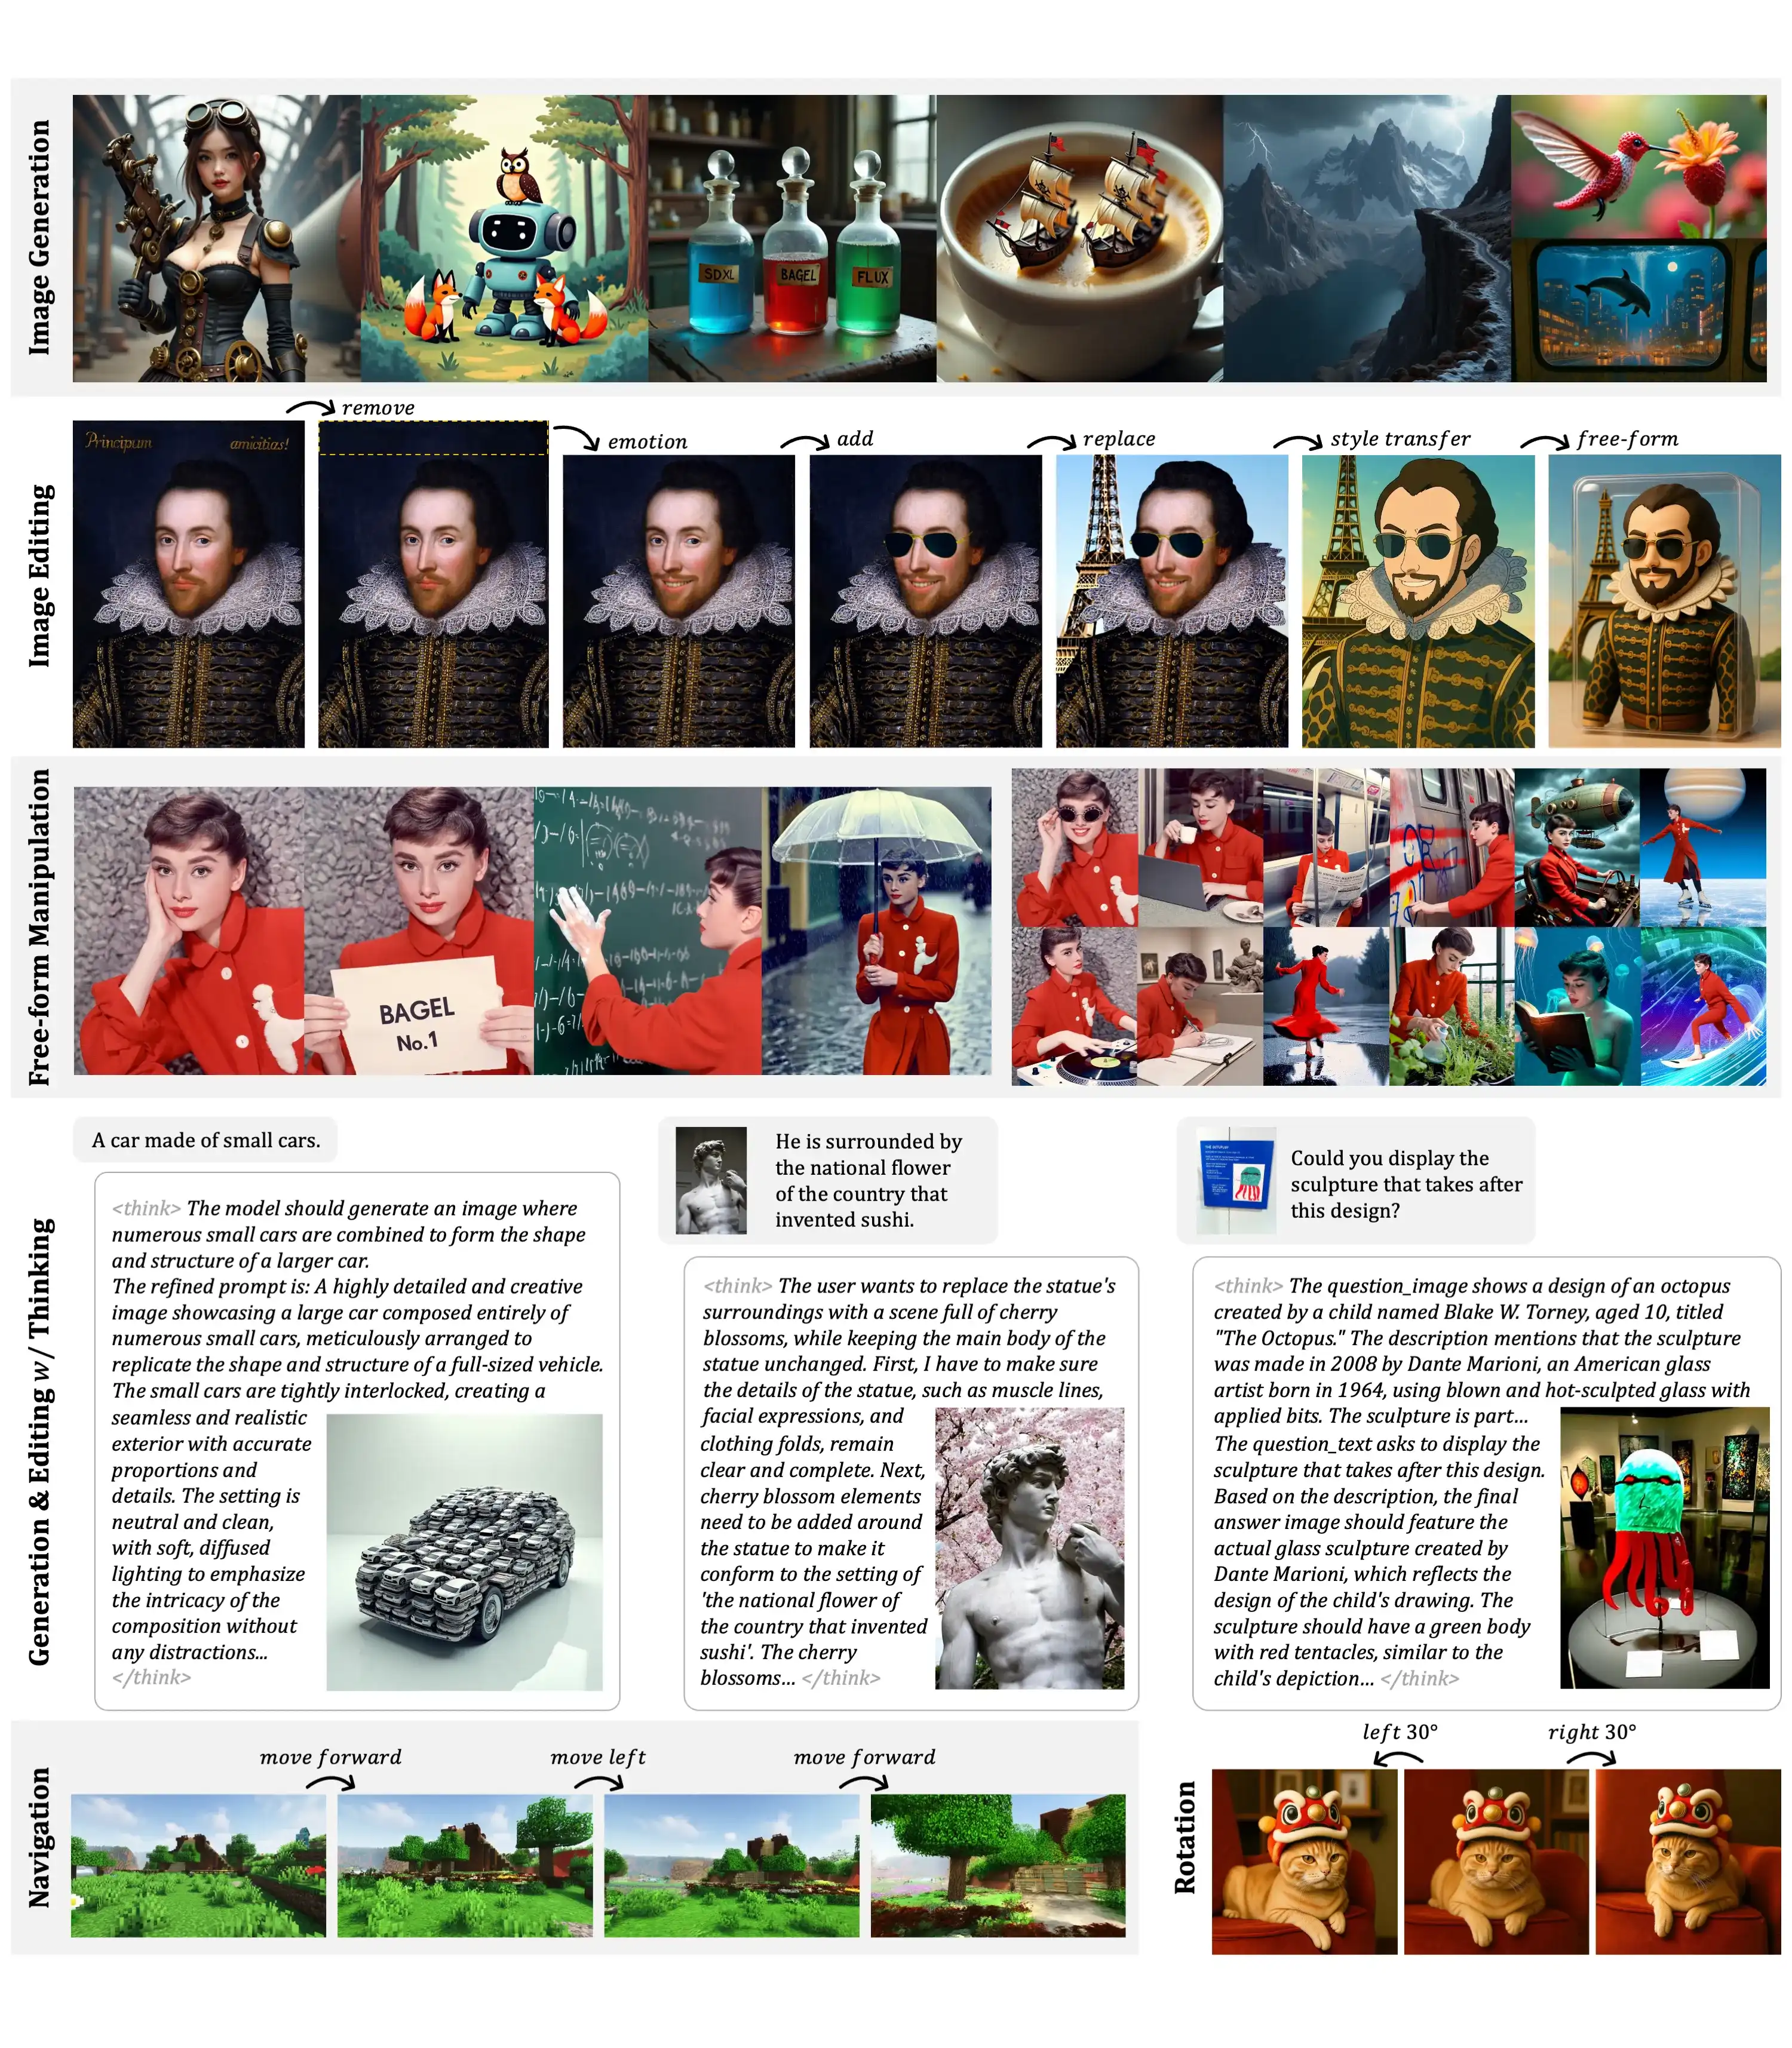
官方概览里有一条很直观的莎士比亚肖像编辑链:去掉上方文字、改变表情、加墨镜、换背景,再改成插画和立体摆件。每次修改都围绕原来的人物继续展开。这里值得看的不是某张图好不好看,而是“改一件事、保留其余内容”怎样成为连续交互的基础。它是发布方挑选的展示,不是本文逐轮运行的记录;可打开官方原尺寸概览查看各阶段。
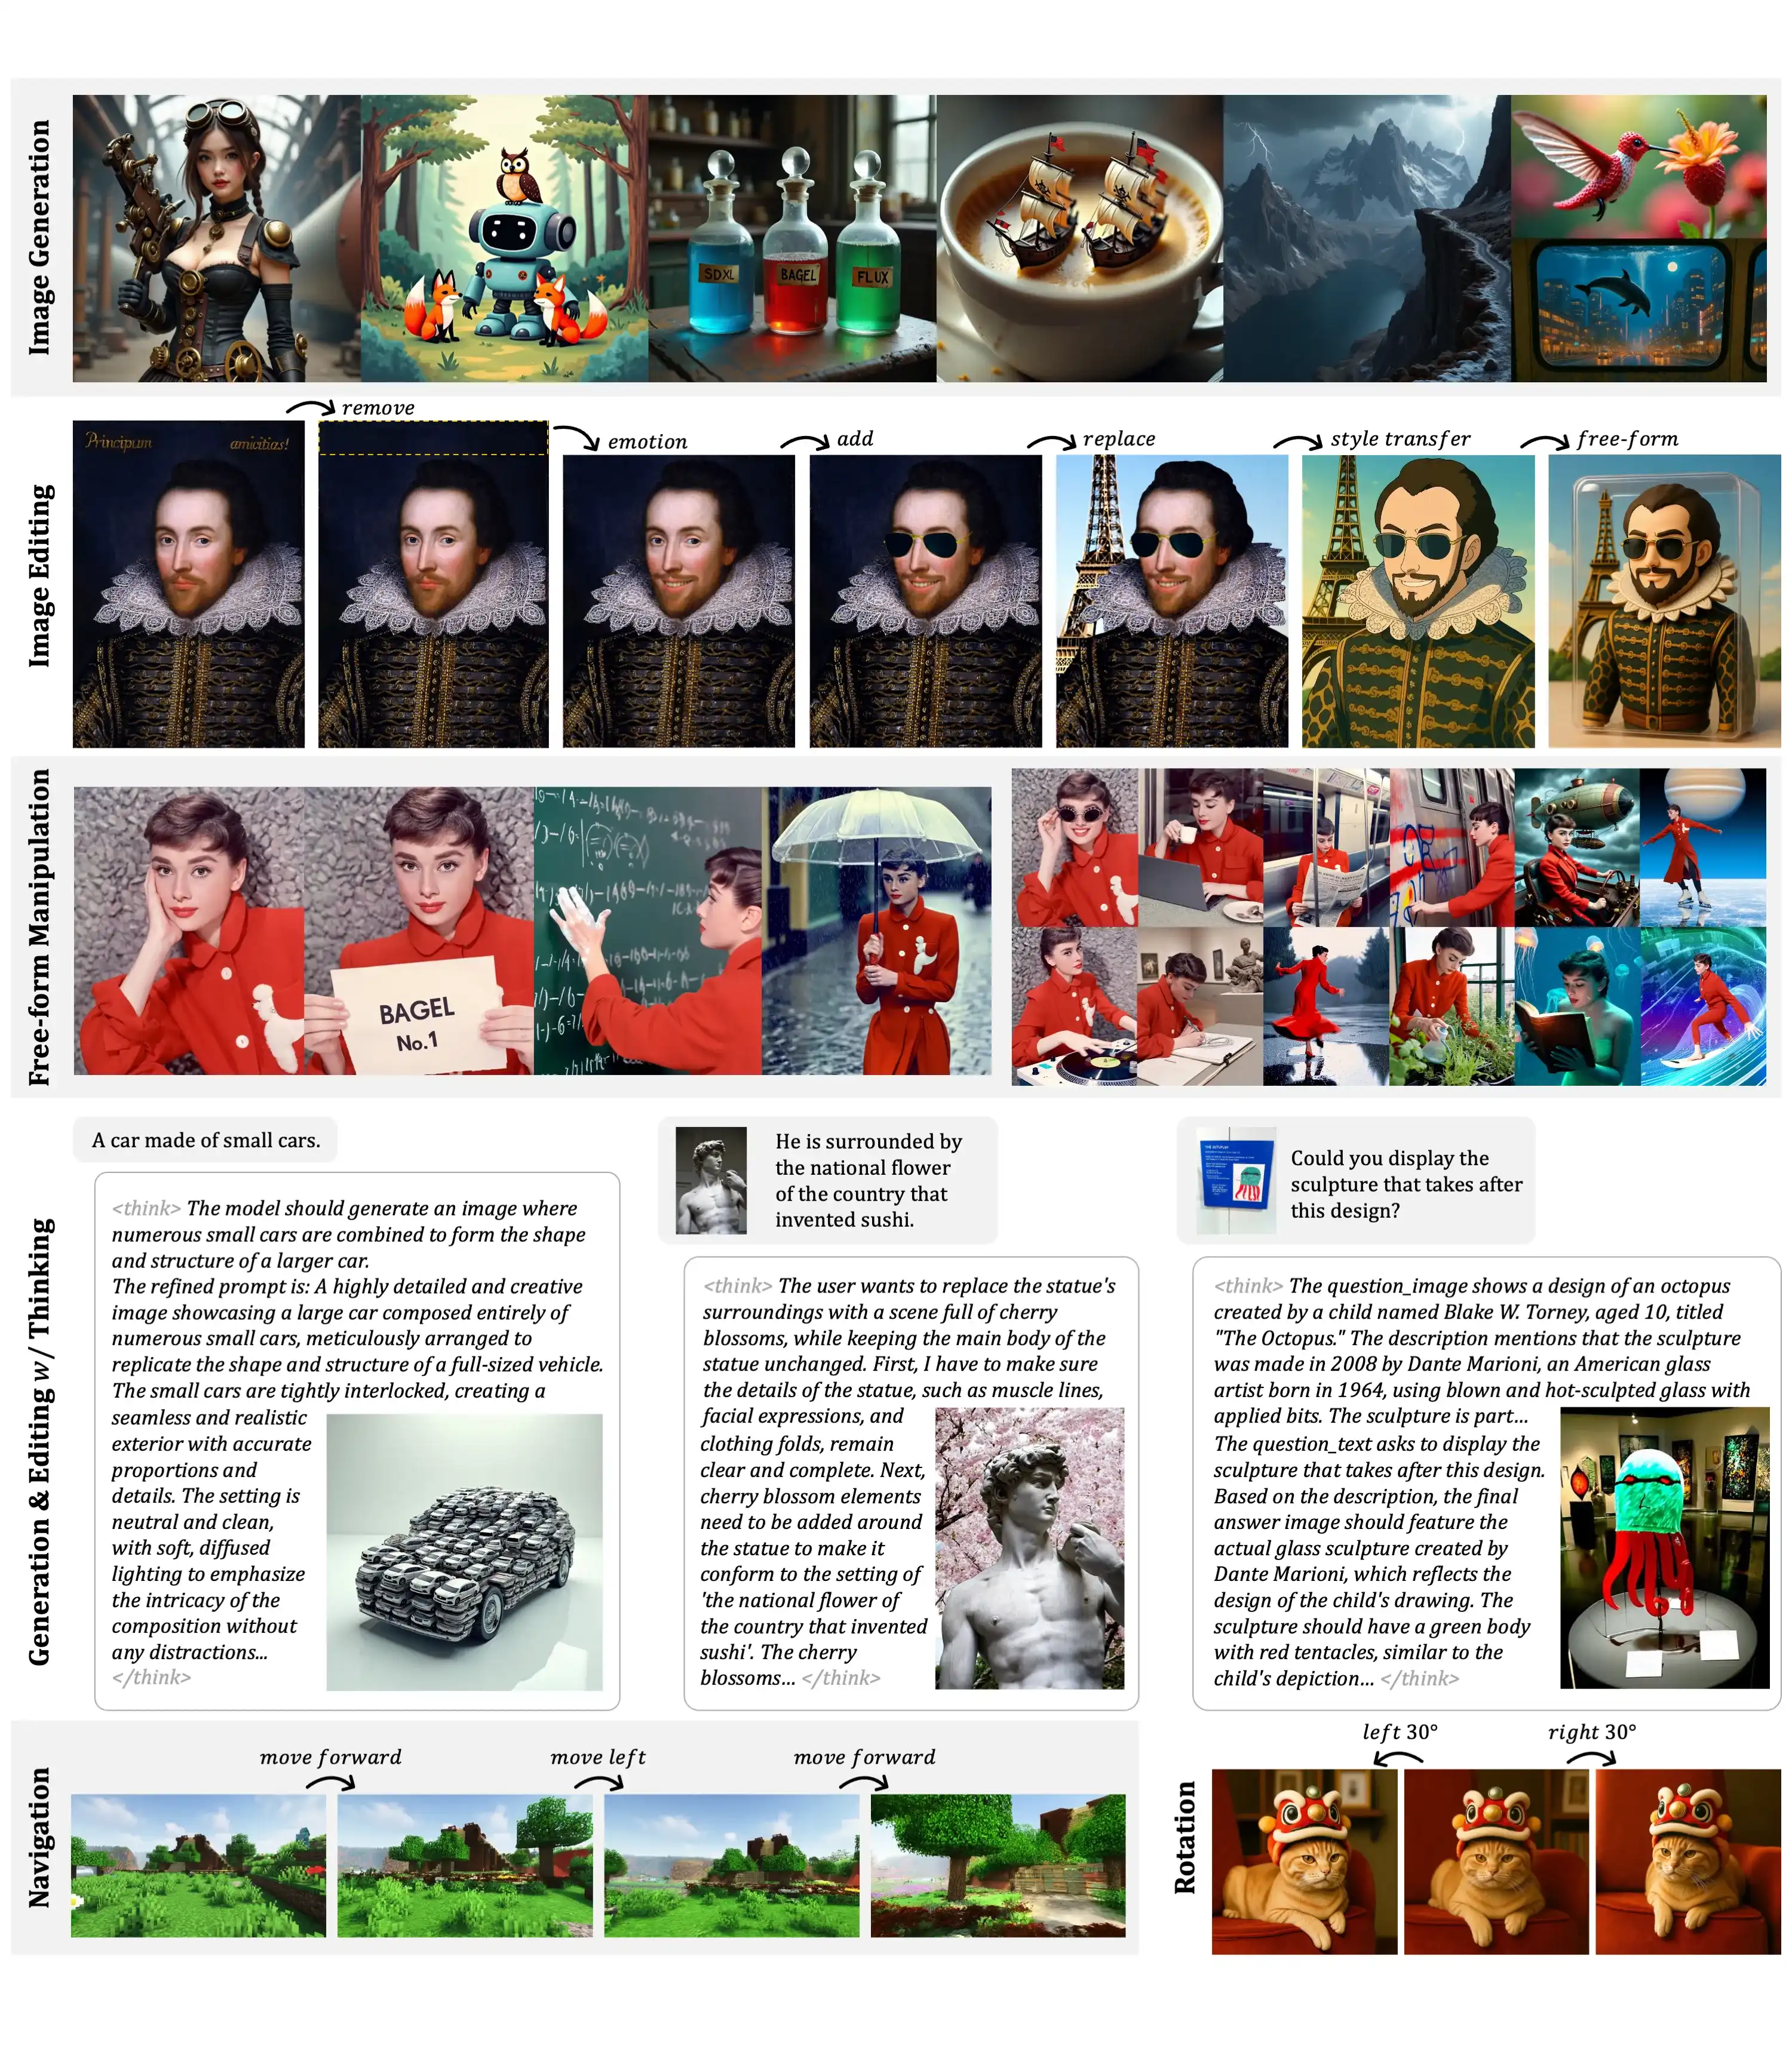
再往下一层,概览里还有一条更有意思的指令:让雕像被“发明寿司的国家的国花”围绕。官方展示先把文字条件解释为樱花场景,再生成保留雕像主体的画面。这类任务要求模型把知识推断接到视觉变更上,编辑指令不必总是直接列出一个物体名。它说明了研究方向;其中的知识解释也应单独检查,不能因为图生成成功就认定前提一定正确。
模型卡解释了背后的分工:MoT 架构设置理解和生成两类 Transformer 专家,语义与像素信息由不同视觉编码路径进入;论文的模型章节进一步说明,两类专家在每层共享注意力。预测文字走自回归路线,图像生成采用 Rectified Flow。因而这里的“统一”是上下文与模型结构的结合,并不意味着所有模态都使用完全一样的生成步骤。
这会怎样影响原型设计?一个教学设想是先请模型解释商品照片里哪些元素构成主体,再要求只换使用场景。第一次回答可以帮助人发现理解偏差,第二步再修改;这比直接交一条笼统改图指令,多了一个可检查的环节。但这只是建议的交互方式,本文没有运行该例,也没有据此承诺中文商品图的效果。
真正动手时,我会先选“换背景、保持主体”这类单一变化。官方仓库把文字遵循的 cfg_text_scale 与保留输入图细节的 cfg_image_scale 分开提供,说明遵循指令与保真需要一起调节;仓库也给出了模糊结果的调参建议。对需要固定品牌字样、严格不改人物细节的交付,这仍应是人工复核的生成环节。
采用门槛也要算进来:仓库把常规 Gradio 加载指向较大显存或多卡,并为较低显存提供 NF4 路线,发布方标明它有 7B 活跃参数、14B 总参数,不能按名字里的“7B”直接当成轻量视觉问答模型。代码许可证与权重模型卡均明确标注 Apache 2.0。本文是资料介绍,未部署模型;如果你正在研究理解与改图如何共用上下文,先从官方权重和 Gradio 入口认识它,比从展示图推导生产稳定性更有收获。
以上为编辑整理,功能、许可与使用条件以官方说明为准。