GPT Researcher:先拆研究问题,再把网页与本地资料写成带来源的报告
为什么值得关注
规划器先生成子问题,研究过程分别收集和筛选材料,最后汇成带引用报告,方便把调研要求落到可复查的证据范围。
适合谁:要为方案、产品选型或行业材料持续做资料调研,并能配置模型与检索服务的研究型开发者
这次有哪些亮点
- 规划研究子问题,再并行收集和汇总来源
- 可研究网页,也可指定本地文档目录
- 报告保留引用并可导出PDF、Word等格式
使用前需要知道
运行需要模型与检索配置,可能产生多轮调用成本;多来源与引用不自动证明事实独立或正确,云端检索和模型也影响资料流向。
做一份工具选型调研,最容易得到的是长报告,最难得到的是“这句话依据哪份材料、它是否真的回答了我们的要求”。GPT Researcher 把研究拆成计划、收集和成稿:先列子问题,再找资料,最后汇成带来源的报告。它适合希望把调研过程接进工作流、并保留可追查材料的开发者。
计划先决定要找什么
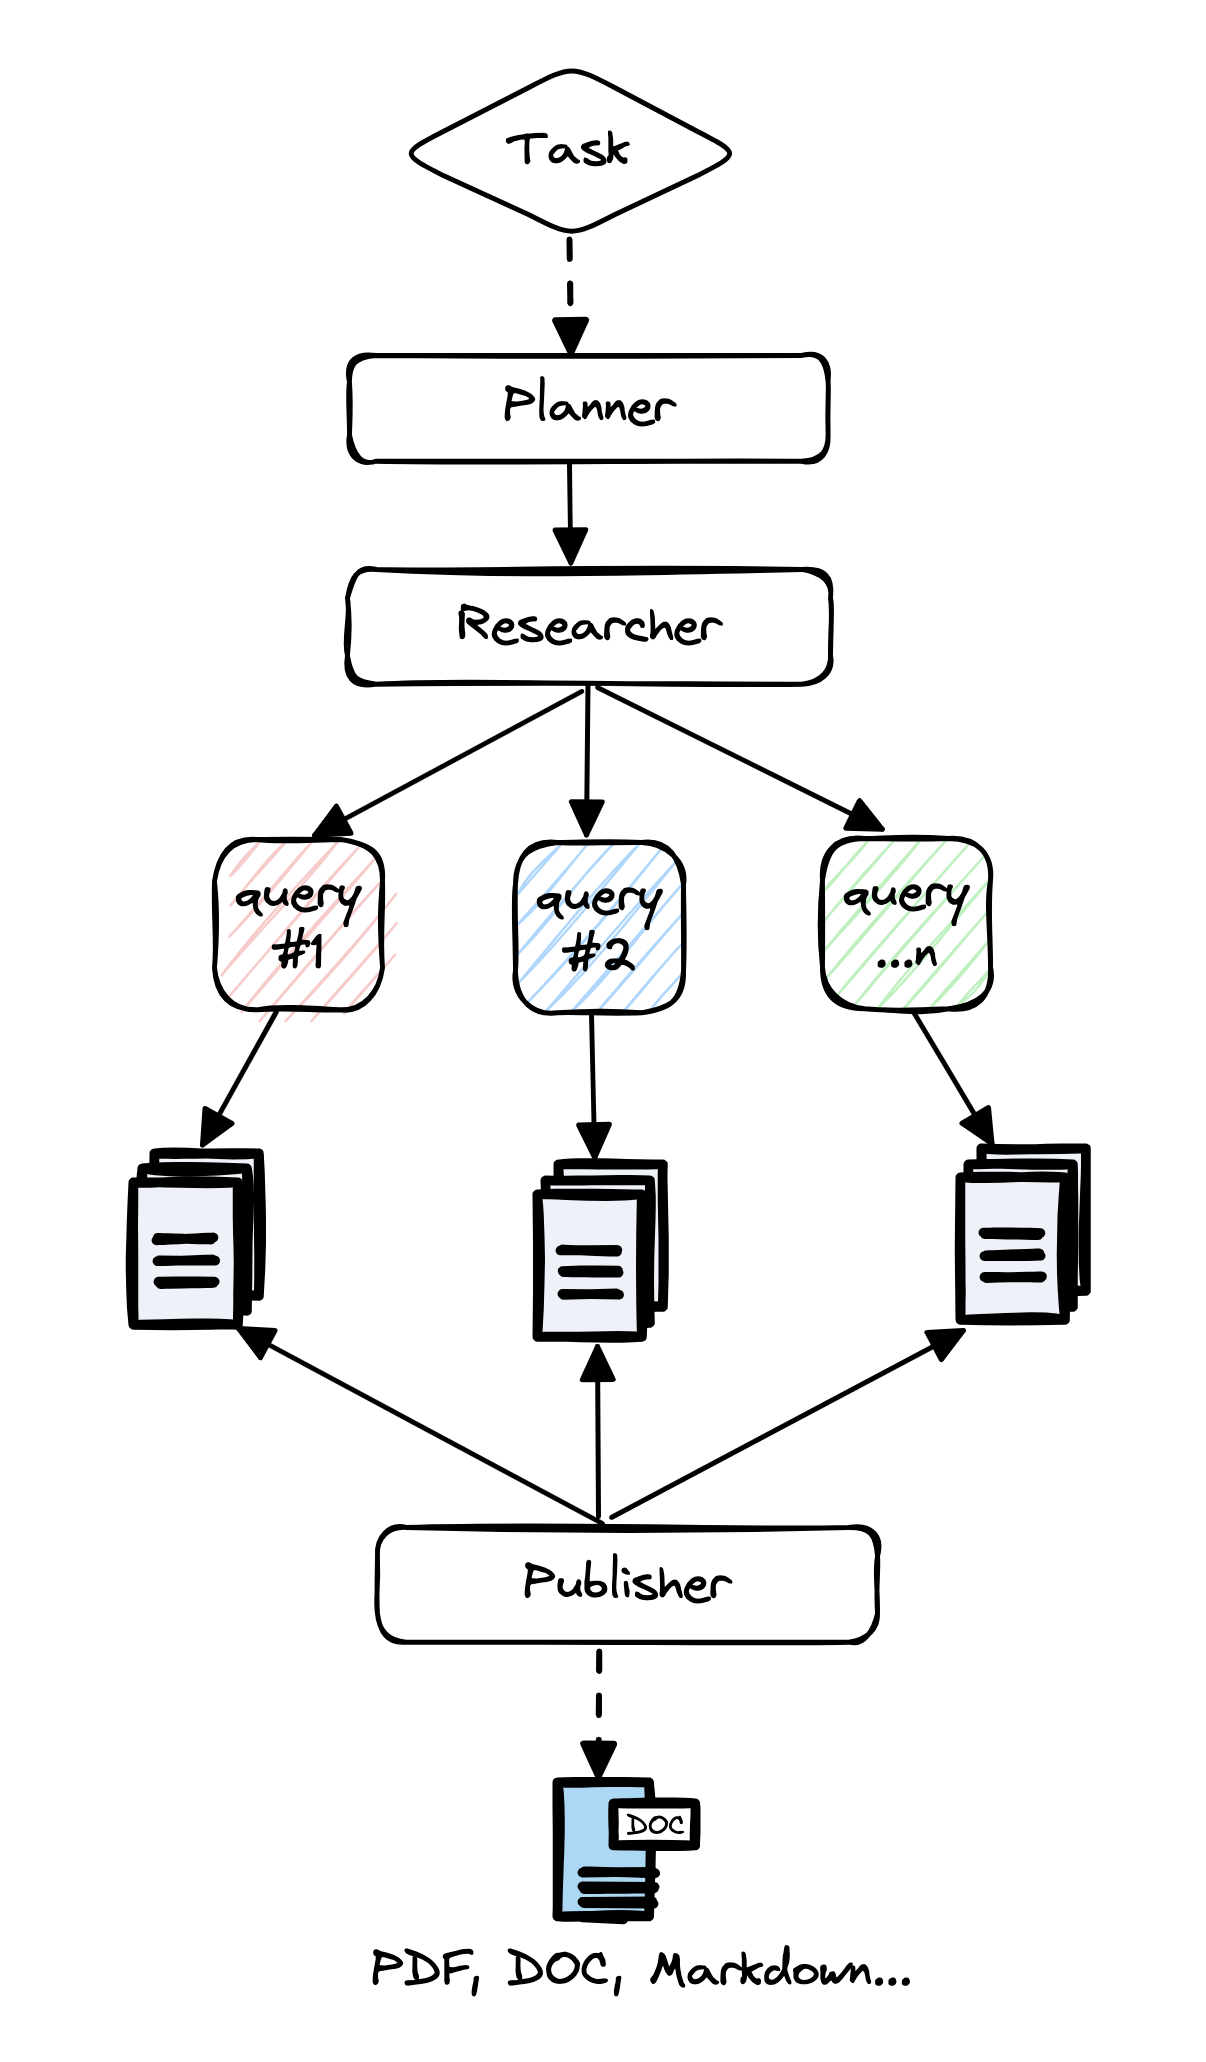
官方架构中,Planner 生成研究问题,执行部分围绕问题收集资源,Publisher 再整理报告。与一次性让模型写文章相比,这条路线给了研究范围一个明确的位置:问题拆错了,后面即使找到很多网页,也可能只是在回答另一个题目。
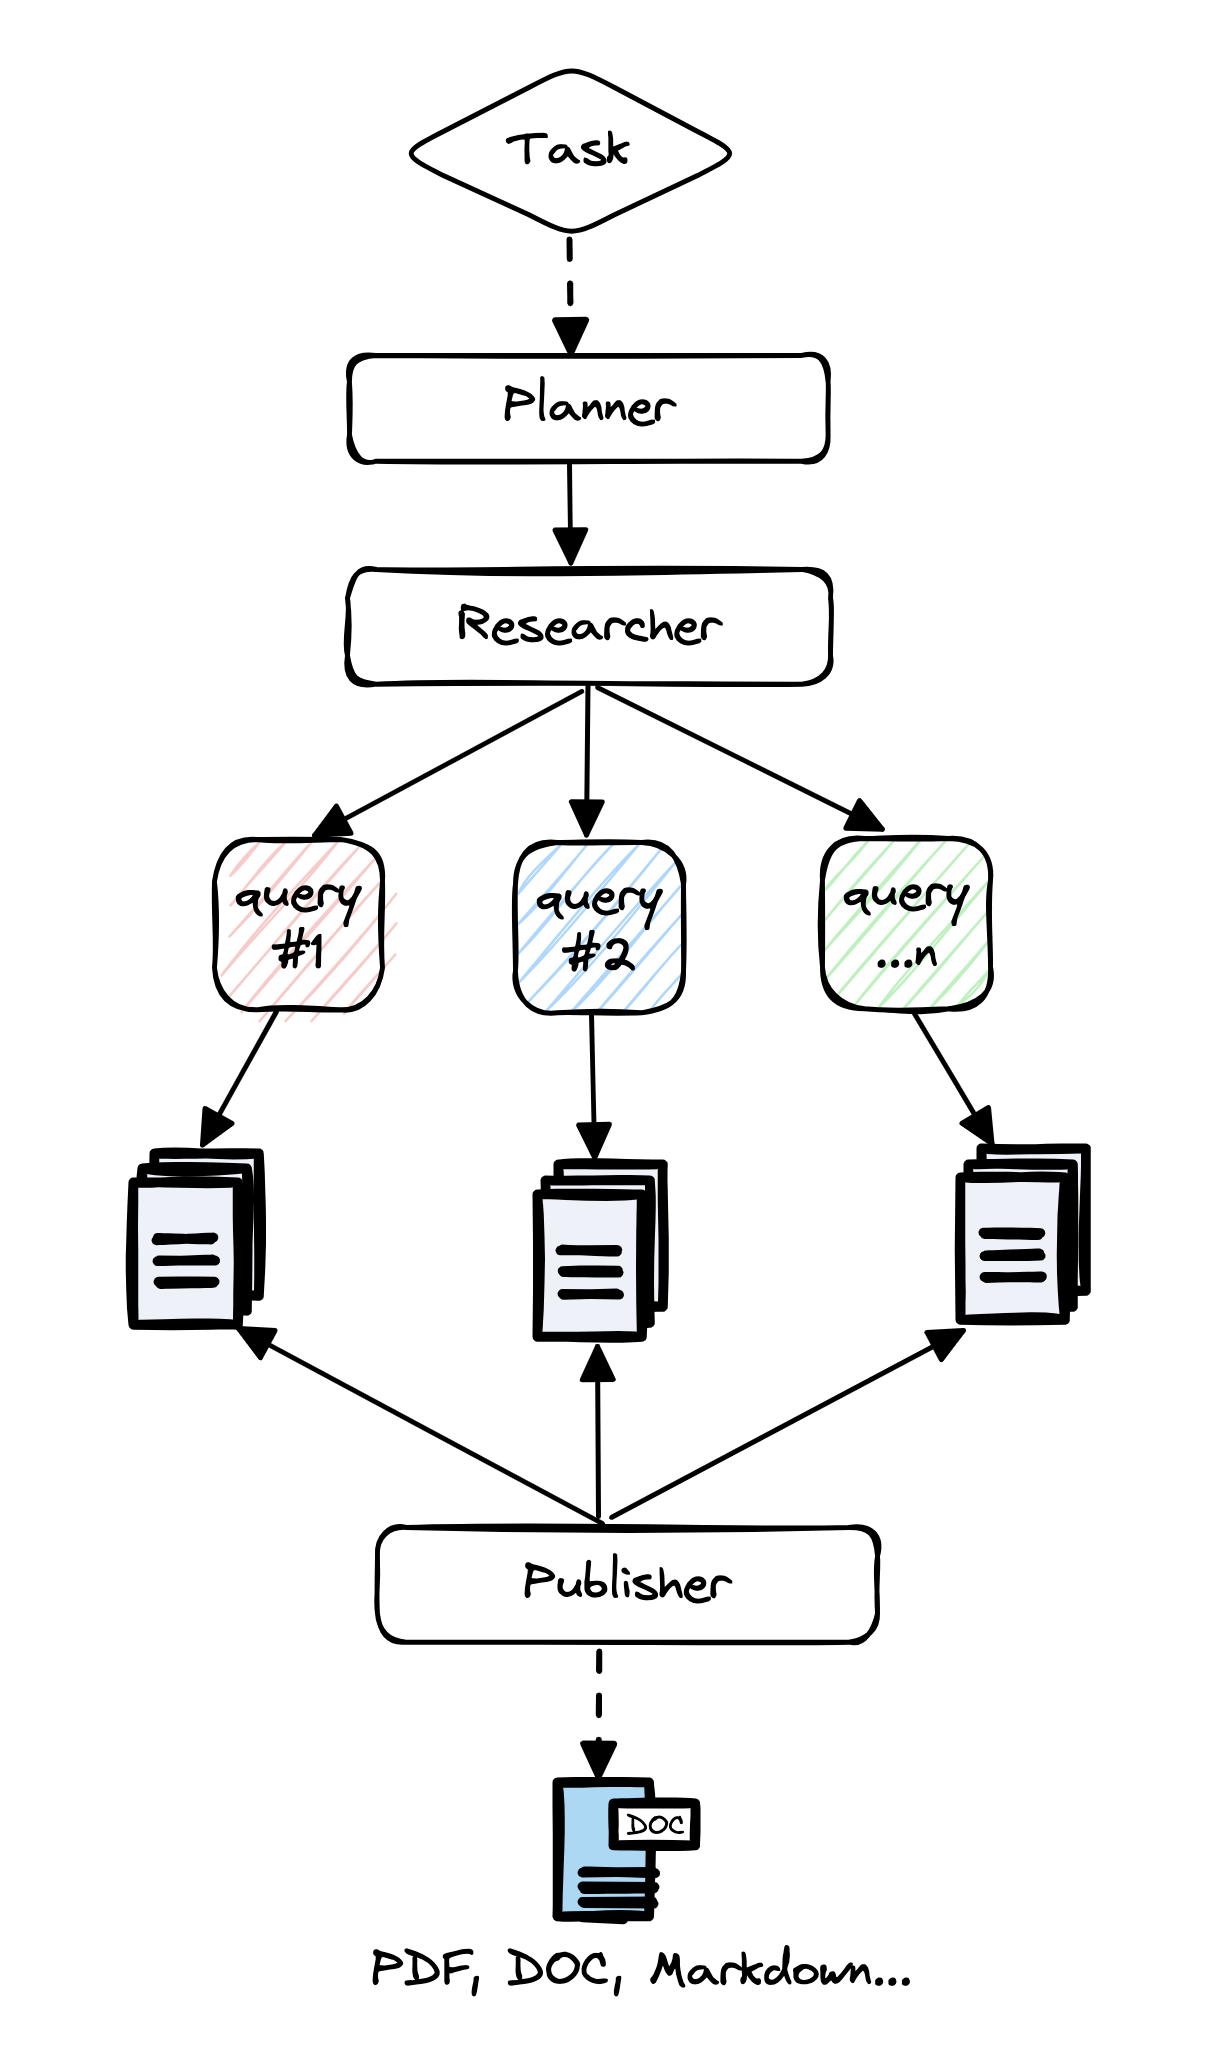
图是官方架构示意。注意中间多个 query 分支,它们分别取得资料,最后再汇合;这不是本文执行过的研究记录。
例如要为一个中文社区活动挑选报名工具,教学情境中的研究问题可以先分为:谁负责填写、能否导出名单、取消报名如何处理、费用与账户有什么要求。若计划只围绕“最好用的报名工具”搜索,最终很容易得到同质化推荐,反而没有回答名单能否交给现场同事使用。
网页与本地文件,各有进入报告的方式
项目既能研究网页,也能通过文档目录使用本地材料。官方列出的本地格式包括 PDF、文本、CSV、Excel、Markdown、PowerPoint 和 Word;报告可以导出 PDF、Word 等格式。对于已有需求说明的团队,这意味着研究不必每次从一句空泛提问开始。
沿用报名工具的情境,可以把自己的需求材料与公开文档分开管理:前者说明必须满足什么,后者支持某个产品是否满足。成稿时最有用的结果,是每项采用条件都能回到相应来源;如果某功能只在宣传页出现、具体开放范围未知,就应保留这个空缺,而不是用更多相似网页把空缺盖住。这个例子用于说明研究设计,未在项目中执行。
引用也需要判断。两篇文章可能来自同一份新闻稿,数量上是两条链接,证据上未必是两份独立材料。报告带引用方便复核,却不能替代对原文、版本和条件的检查。
适合持续调研,也需要配置与预算
官方仓库采用 Apache-2.0 许可,提供 Web 界面与 Python 包。开始前需要配置模型和检索服务;官方示例给出相应 API key,也支持自定义 OpenAI-compatible 地址。是否使用本地模型、外部搜索或其他资料连接,会改变运行条件和资料流向。
一次研究会经历多次收集与模型调用,不宜把示例任务的耗时或费用推成自己的固定预算。可从开始文档用一个范围明确的问题试起,先看计划是否覆盖需求,再看关键引用是否真的支持结论。
如果只是想知道一个概念,普通搜索或对话已经足够;如果相似调研要反复做,并且需要把来源交给下一位同事继续检查,GPT Researcher 的分工与可配置过程才更值得保留。
以上为编辑整理,功能、许可与使用条件以官方说明为准。