
Kotaemon:问文档时,把答案与PDF原页放在一起核对
为什么值得关注
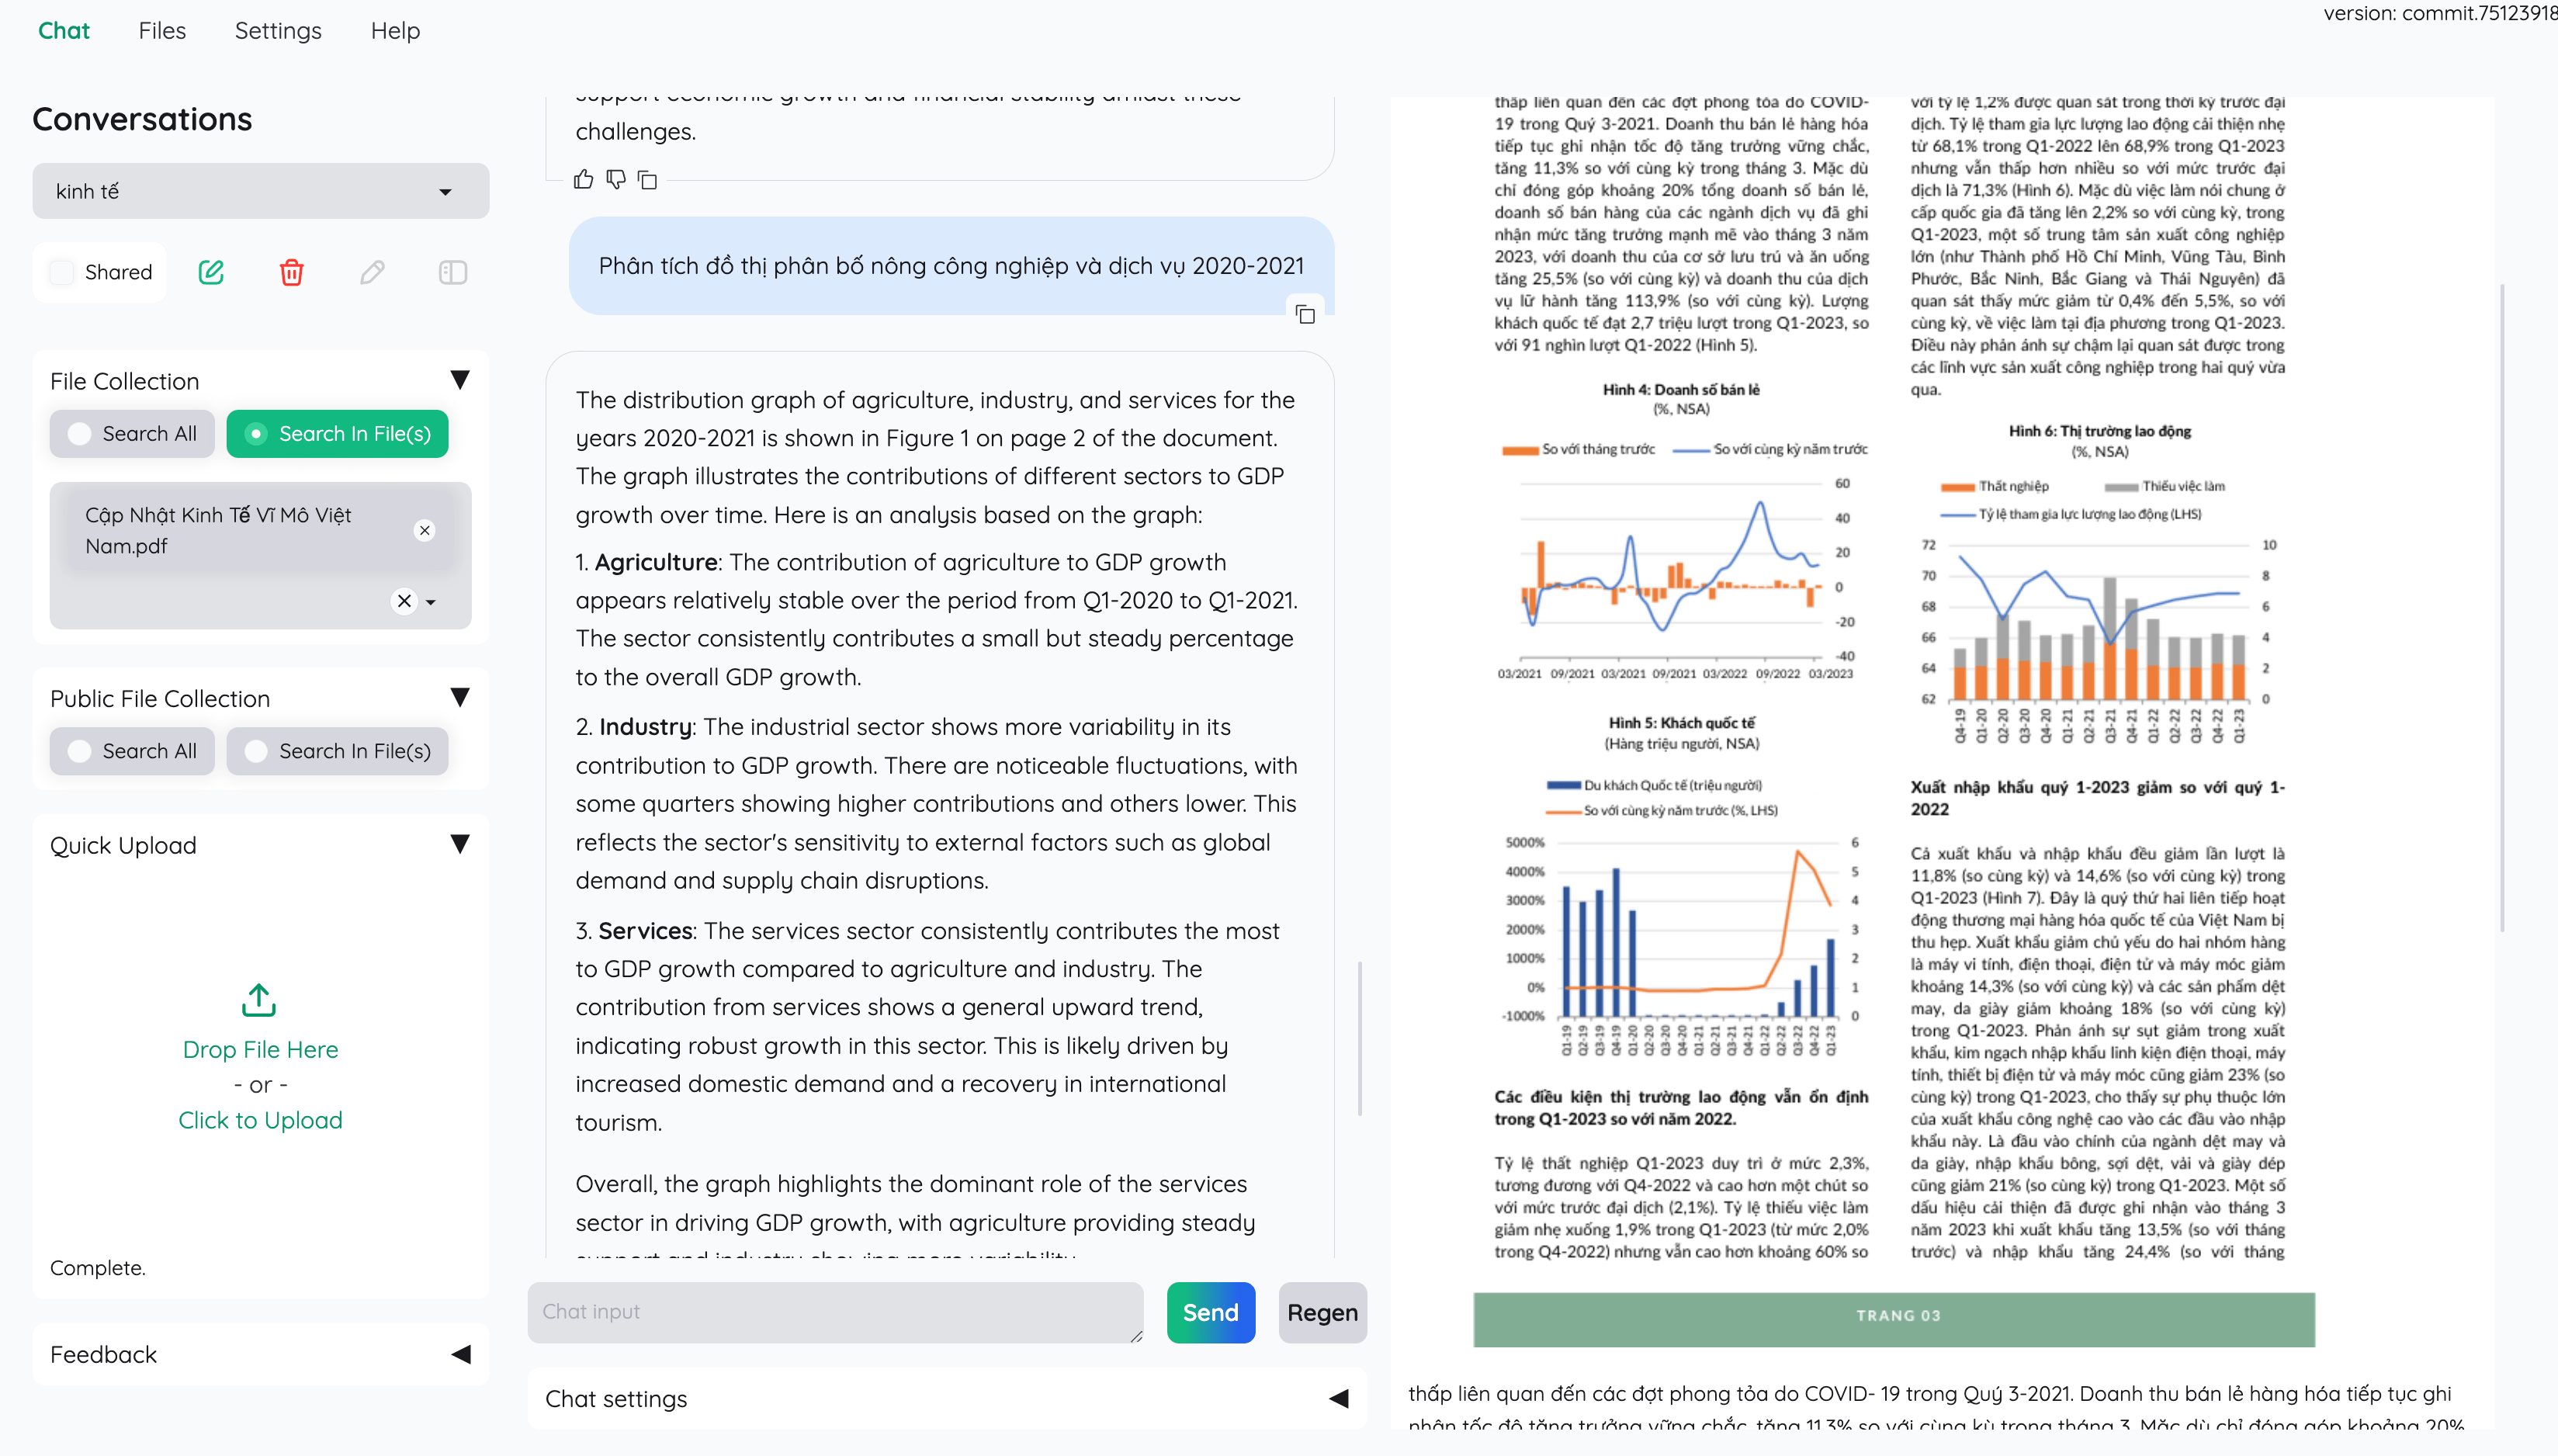
答案旁提供文档预览与引用位置,资料审阅者可以在同一界面核对数字和条件,开发者也能观察自己的RAG流程。
适合谁:要审阅多份报告或手册,并愿意自建文档问答环境的研究与开发团队
这次有哪些亮点
- 问答与PDF预览、引用高亮在同一界面呈现
- 可选择本地或API模型,组织私有和公共文档集合
- 默认流程结合全文/向量检索与重排,并可调整检索设置
使用前需要知道
需要模型、嵌入与文档解析环境;不同文件类型和PDF预览可能需要额外组件。配置本地生成模型后,还应检查文档集合嵌入和相关性评分是否也为本地;界面不能保证引用就支持结论。
问一份报告“哪些指标发生变化”,答案写得流畅还不够,审阅者往往要立刻看原表:单位是什么、比较的是哪一年、有没有“仅限样本”这样的条件。Kotaemon 把文档问答和 PDF 预览放在同一个界面里,适合希望一边问、一边回到原页核对的人。
引用要能回到读得见的材料
官方界面左侧组织文件集合,中间显示问答,右侧预览报告。封面使用的是越南语报告与英文回答的官方示例,说明的是布局关系,不能据此证明中文识别或回答正确。
项目支持详细引用、PDF 内高亮以及相关性提示。它的实际意义,是让“这句话来自哪里”不必再靠复制文件名、切换阅读器重新搜索。审阅材料时,原文应和答案一起进入判断。
例如一份中文年度报告写“样本门店收入增长”,这是自拟教学情境,未在产品中运行。如果回答省掉“样本”二字,把结果推广成全部门店,引用即使指对了页面,结论仍然被扩大了。并列原页让这种差异更容易被看到,但看见证据和正确使用证据仍是两回事。
不只是一层聊天框
Kotaemon 提供私有和公共文档集合、多用户界面,也让开发者替换文档索引和问答流程。默认检索结合全文与向量检索,再配合重排;界面中可以调整重要设置。
这对团队选型有一个直接好处:问题答得不好时,可以区分资料没有被取回,还是取回后没有正确表述。文件集合选错、解析遗漏、检索相关性不够,与模型把已有段落说错,需要不同的修正。单纯反复改提问语气,未必触及真正的问题。
也不必为了使用它,先开启每种复杂推理或图索引。先用清楚的文件与简单问题确定引用能读、原页能看,再根据实际材料考虑其他流程,通常更容易判断新增能力是否有帮助。
本地路线,要检查的不只一个模型
官方仓库采用 Apache-2.0 许可,提供 Docker 与本地安装方式。lite 和 full 镜像对附加文件解析依赖有所不同,部分 PDF 预览也需要相应组件。先看手头材料是什么格式,再选安装路线,能少走一些弯路。
如果希望在本地处理,官方本地模型说明提醒要检查几处:默认生成与嵌入模型、文件集合使用的嵌入模型,以及检索相关性评分模型。只把聊天模型改成本地,并不能说明其余步骤也已本地化。
Kotaemon 更适合愿意维护模型和解析环境、又希望把问答过程展示给资料审阅者的团队。它最值得留下的设计是让答案与原页靠近;是否可靠,仍要在自己的文档上核对,而不是由一枚引用编号替你决定。
以上为编辑整理,功能、许可与使用条件以官方说明为准。